
チップの配置配線は 1 台のノートパソコンで行いました。22 スレッドの Intel Core Ultra 7 155H と 30 GB の RAM です。軽いジョブの一部は、Slurm 上の小さなマシン 3 台が担いました。この最終回では、それが実際に何を意味したかを見ます。決めた制限、時間の使われ方、配線を通すのにかかった 20 回の試行、そしてハードウェアが増えたら何を変えるかです。
制限
プロジェクトを通して 3 つの制限を守りました。
- EDA ジョブは一度に 1 つ。 20 GB のジョブ 2 つは 30 GB に収まりません。
- ジョブあたり 10 スレッド。 どのツールでも明示的に設定しました。
- ジョブあたり 22 GB のメモリ上限、スワップはオフ。 各ジョブは
systemd-run --user --scope -p MemoryMax=22G -p MemorySwapMax=0の下で実行しました。上限を超えたジョブは、ノートパソコンをスワップで止めてしまう代わりに、明確なメモリ不足のエラーですぐに終了します。チップの配線では、エンジニアの同意を得たうえで上限を 26 GB に上げました。
Slurm では --mem はスケジューリングを左右するだけで、強制はされませんでした。小さなノードのメモリは最大でも約 15 GB で、チップや otbn のジョブが必要とする 20 GB 超に足りません。そこで、ジョブの予想ピークメモリでノードを選び、大きなジョブはノートパソコンに残しました。
時間はどこに使われたか
チップ v5 をステージごとに、各実行の GNU time のログから示します。「使用コア」は CPU 時間を実時間で割った値で、10 スレッドのうち平均でいくつが動いていたかを表します。
| ステージ | 実時間 | 使用コア | ピークメモリ |
|---|---|---|---|
| init | 4 min | 1.2 | 4.4 GB |
| floorplan | 8 min | 1.0 | 5.1 GB |
| place | 2 h 51 min | 1.6 | 15.8 GB |
| CTS | 6 min | 1.5 | 9.7 GB |
| post-CTS repair | 34 min | 2.8 | 17.5 GB |
| route | 26 h 12 min | 8.9 | 22.4 GB |
| post-route | 12 min | 1.3 | 20.1 GB |
| finish(軽量版) | 8 min | 0.3 | 6.1 GB |
| 抽出(OpenRCX、4 コーナー) | 30 min | 0.8 | 3.7 GB |
| サインオフ STA(OpenSTA、コーナーごと) | 3 min | 2.2 | 5.9 GB |
目立つパターンが 2 つあります。
- 配置とその修正は主に 1 コアで動く。 チップの配置は平均 1.6 コアでした。フラットなチップの 24.7 時間の配置は、22.5 時間がシングルスレッドの
repair_designでした(第 2 回)。そこではコアを増やしても役に立たず、役に立ったのは階層化でした。 - 詳細配線はすべてのスレッドと最も多くのメモリを使う。 10 スレッド中約 9 を動かし続けた唯一のステップで、メモリのピークもここでした。最大のブロックも同じで、otbn の配線は 9.4 コア、19.5 GB で 6 時間かかりました。
それに比べるとサインオフは安価です。ファイルさえあれば、抽出は 30 分、タイミングの実行は数分なので、修正後にサインオフをやり直すのは簡単です。
20 回の試行、ほとんどはメモリ
配置のあと、チップ v5 は最後の 5 ステージを通すのに 20 回の試行が必要でした。失敗のほとんどは上限でのメモリ不足エラーで、クラッシュや誤った結果ではありませんでした。
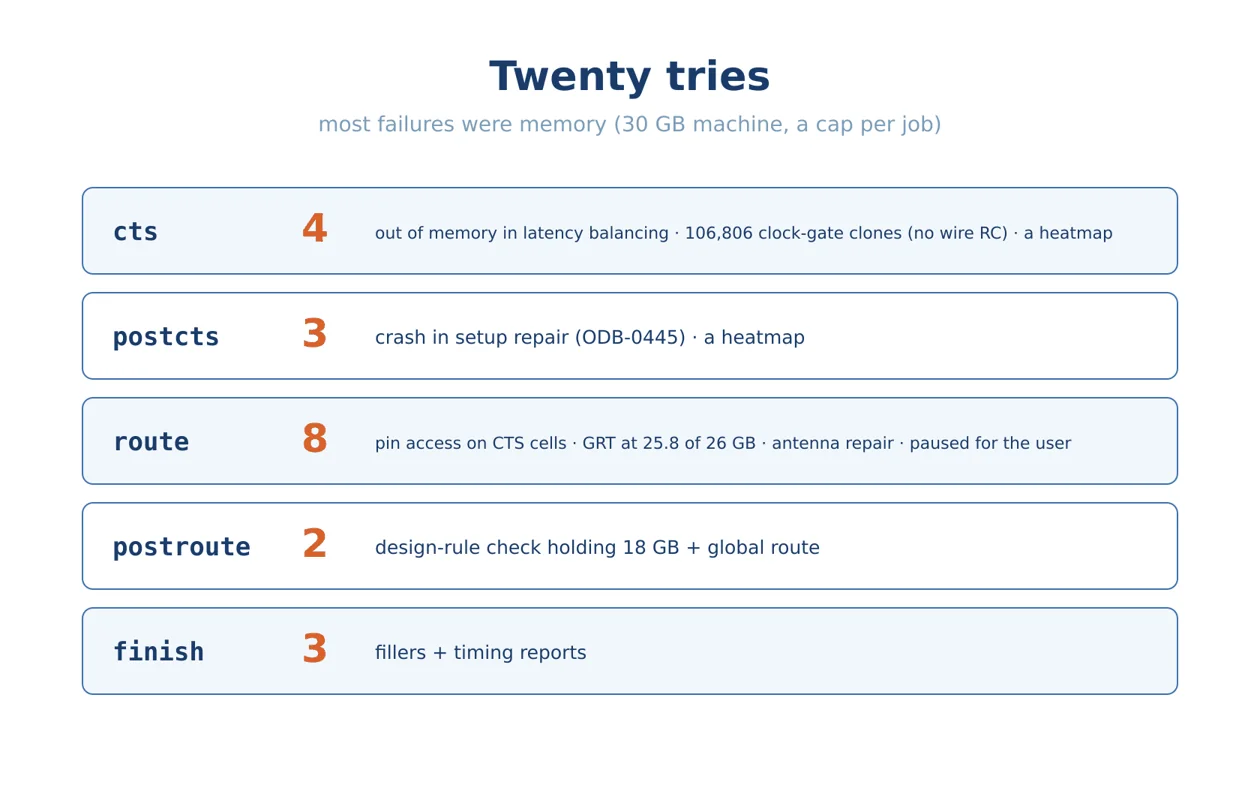
主な出来事:
- 配線モデルの欠落で、CTS がクロックゲートを 106,806 個複製しました。修正は
set_wire_rcの 1 行でした。 - グローバル配線のピークは、26 GB の上限に対して 25.8 GB でした。
- ポストルートのデザインルールチェックは、グローバル配線がまだ読み込まれている状態で 18 GB のデータを抱えていました。
- ヒートマップ、アンテナ修正、そしてフィニッシュステージのフィラーとタイミングレポートが、それぞれ実行を上限超えに押しやりました。
- 一度は、エンジニアがノートパソコンを使う必要があったため、配線を最初のパスで一時停止し、保存したグローバル配線の結果から後で再開しました。
失敗のたびに、フローは恒久的に変わりました。
- グローバル配線と詳細配線は別のプロセスで実行し、そのあいだにグローバル配線の結果を保存する。
- チップではヒートマップを出さない。
- レポートの前にチェックポイント。 メモリ不足になるレポートがあっても結果を失わないように。
- フィラーなしの軽量フィニッシュと、フルのデザインルールチェックなしのポストルート。
- デモではアンテナ修正をオフにし、残課題として書き留める。
どれも特殊なものではありません。しかしこれらがそろって、100 万セルのトップレベルが 30 GB のマシンにそもそも収まるかどうかを決めました。
 2:09
YouTube で見る(英語) ↗Bilibili で見る(中国語) ↗
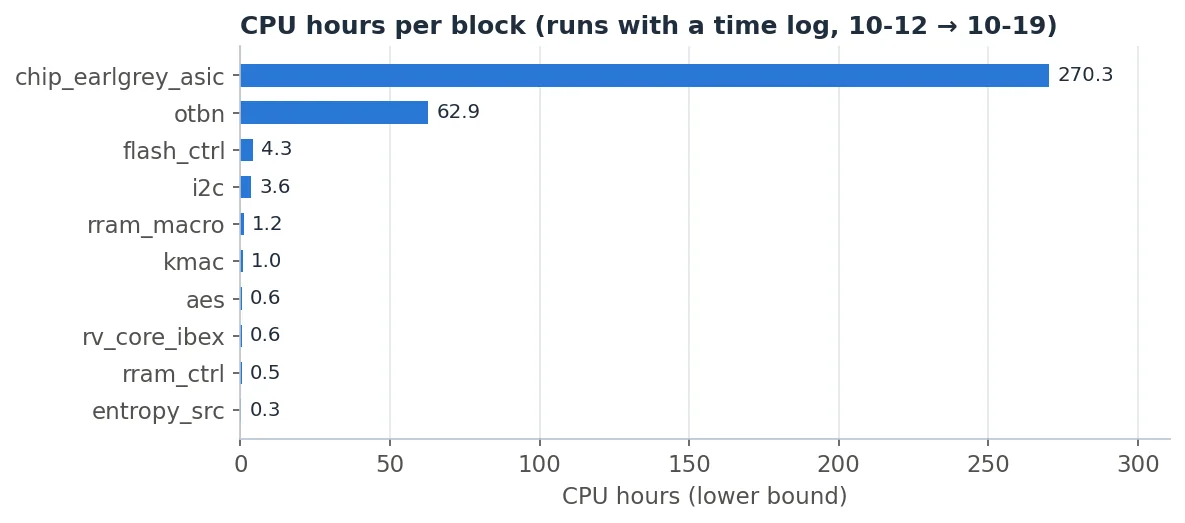
合計
この合計は下限値です。時間のログは 10 月 12 日以降にしかなく、各ステージの最後の実行しか残していないので、フラットなチップの 24.7 時間の配置、初期のブロックの実行の大部分、そして失敗した試行はすべて含まれていません。
マシンを増やすと役に立つとき、立たないとき
最も時間を節約できたのはメモリの増設でした。 20 回の試行のほとんどは速度ではなくメモリの問題でした。64 GB のマシンなら、その大部分を避けられ、プロセスの分割や上限の交渉も不要だったでしょう。
マシンを増やすと、独立したジョブで役に立ちます。
- 9 個のブロックは、配置配線を順に流して約 20 時間かかりました。十分なメモリのあるマシンなら並べて実行できます。i2c、aes、kmac のような小さなブロックは 15 GB のノードに収まりますが、otbn の配線(19.5 GB)や一部のフィニッシュステージ(約 22 GB)は収まりません。
- 4 つのレベル 2 のフロアプランチェック(第 3 回)は、それぞれ約 1 時間で、ピークは 20 GB 近くでした。十分大きなノードが 4 つあれば、4 時間ではなく 1 時間ですみます。
- プローブとサインオフの実行は小さく、どこにでも収まります。混雑のプローブは Slurm のノードで 15 秒で終わりました。
マシンを増やしても、1 本の長い実行は短くなりません。 26 時間の詳細配線は 1 台のマシン上の 1 つのプロセスで、すでに約 9 コアを使っています。配置はほとんど逐次的です。それらを短くしたのは設計でした。階層化で配置は 24.7 時間から 2.8 時間になり、配線を短くするのはより良いフロアプラン(kmac のチャネルの修正)です。
シリーズを 1 画面で
このシリーズで示したことのすべてです。
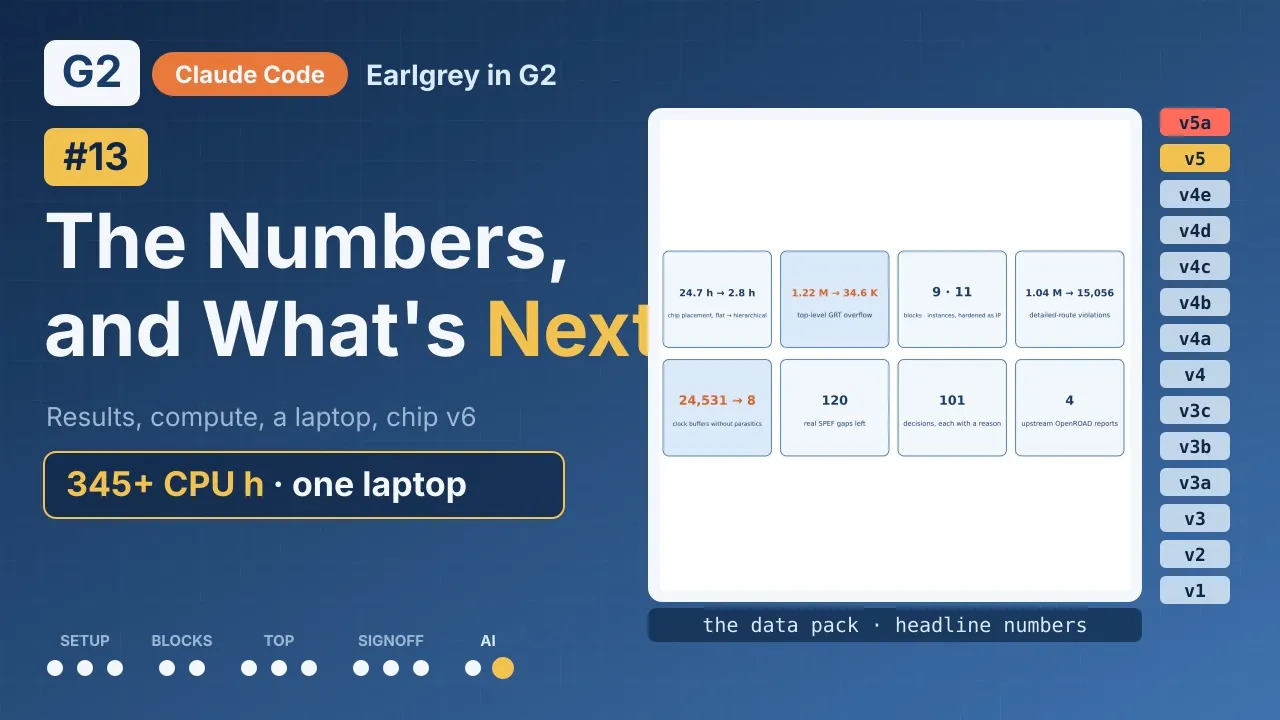 1:38
YouTube で見る(英語) ↗Bilibili で見る(中国語) ↗
まだテープアウトではない
これまで繰り返してきたとおり、上位のメタルは代用の 10 層スタックで、メモリは FakeRAM のモデル、クロックは 10 MHz のデモ用の目標であり、チップには残課題があります。その残課題とは、15,056 件の配線違反、タイミング例外のない IO パス、ホールドレポートがないこと、そしてパッドリングでの VDD のオープンです。チップ v5 は、2 つの OpenROAD ビルドとパッチを当てたデータベースも混ぜて使っています。
次のチップバージョン v6 で、これらのギャップを埋めます。
- パッドの層への電源グリッドの接続。VDD と VSS の両方をチェックする。
- kmac のチャネルを作り直し、配線前に最悪ウィンドウのルールで確かめる。
- IO パスのタイミング例外。
- サインオフでのホールドレポート。
- 実行全体を 1 つの OpenROAD ビルドで、パッチなしで。
どこで見られるか
- G2: GitHub の無料の Community Edition
- 動画: 「Earlgrey in G2」全 13 エピソード、YouTube と Bilibili で
- OpenROAD の修正: issue #11839 と #11840、pull request #11841 と #11842
オープンソースのツールで、100 万セルの SoC を RTL からサインオフタイミングまで進めることができます。すべてを追跡するフローマネージャー、そのルールの中で働くエージェント、そして判断を下すエンジニアがいれば、それはノートパソコン上で回し、説明し、繰り返せるプロジェクトになります。