
第 2 回の終わりで、チップは階層化されていました。ハード化した 9 個のブロック、11 インスタンス、そして 529,205 インスタンスのトップレベルで、配置は 25 時間ではなく約 3 時間で終わりました。この回は次の問題、トップレベルの配線と、その大部分を解決した方法についてです。
最初の配線チェックは、始まる前に止まった
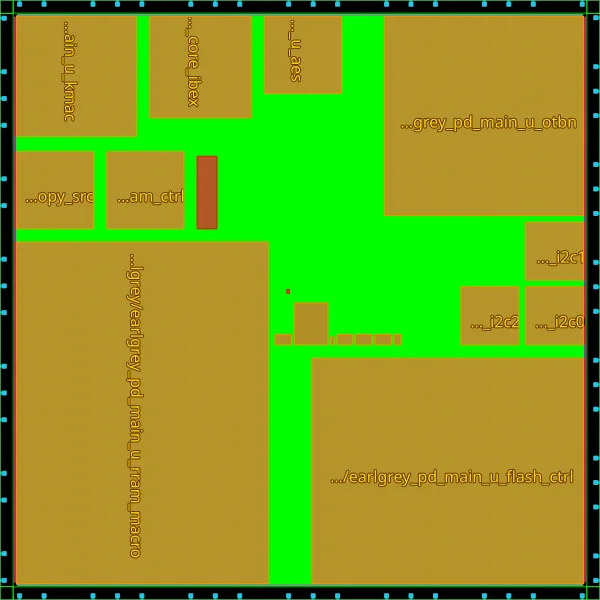
チップ v2 は手作業のフロアプランでした。ハード化したブロックを 8.6 mm のコアの縁に沿って並べ、メモリを中央に一列に置き、ブロックのあいだにトップレベルのロジック用のチャネルを設けました。階層化で実行時間は解決し、repair_design は 22.5 時間ではなく約 2 時間になりました。しかしトップレベルのセルは狭いチャネルに収まることになり、配置ツールの混雑推定はフラットなチップより悪くなりました。
続いてグローバル配線チェックがピンアクセスで止まりました。メモリのピン 1 本に、合法なアクセスポイントがありませんでした。18 個のメモリ LEF のうち 4 個は、ピンがマクロの外側に最大 59 µm はみ出していました。G2 で新しいメモリライブラリのバージョンとして修正しました。同じピンがまた失敗しました。配線ブロッケージの 0.08 µm 上にあったのです。これには 2 つ目のライブラリバージョンが必要でした。フラットなチップは、どちらのバグも見つけられるところまで進んでいませんでした。
 2:10
YouTube で見る(英語) ↗Bilibili で見る(中国語) ↗
やり直さずに修正を試す
2 つ目の修正を試すのに、チップを配置し直しはしませんでした。小さなテストバージョン(v3b)が配置済みの設計を読み取り専用でリンクし、メモリ上で 1 つのメモリだけをパッチして、グローバル配線チェックだけを実行しました。先に 3 時間の配置をする代わりに 28 分です。G2 ではこれも普通のバージョンの 1 つで、専用のステージディレクトリと README を持つので、この近道も他の実行と同じように記録に残ります。
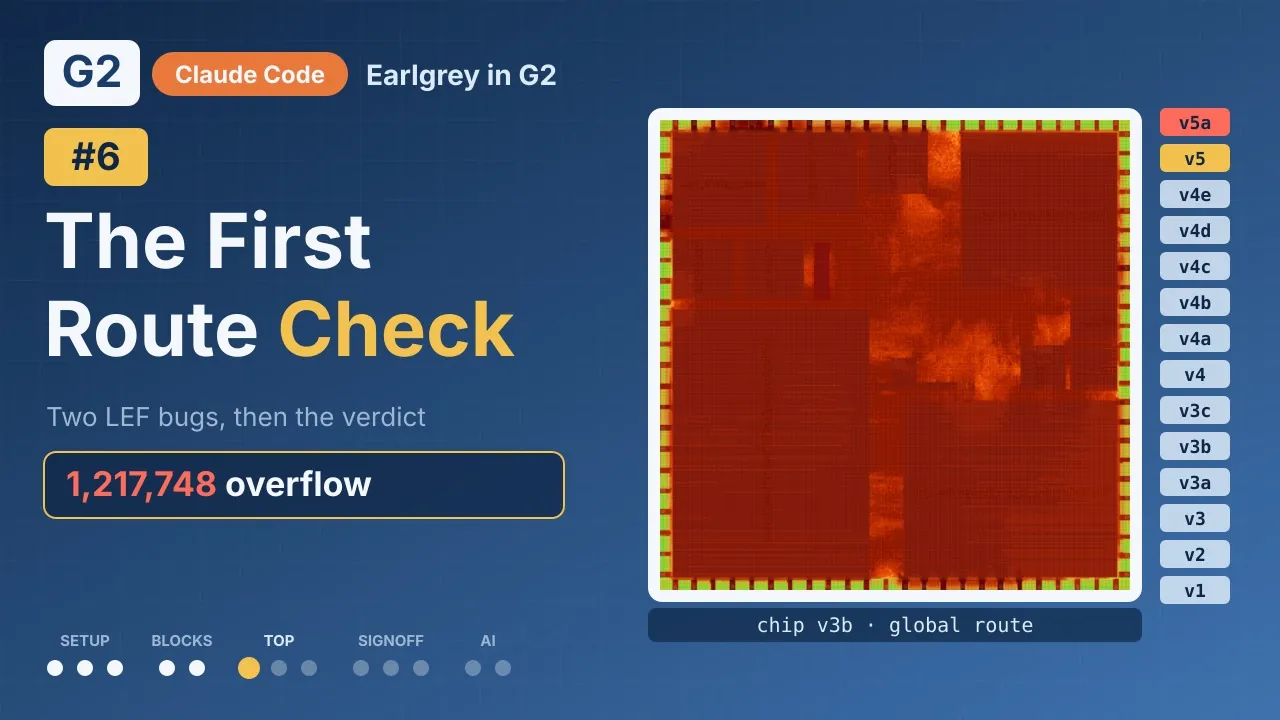
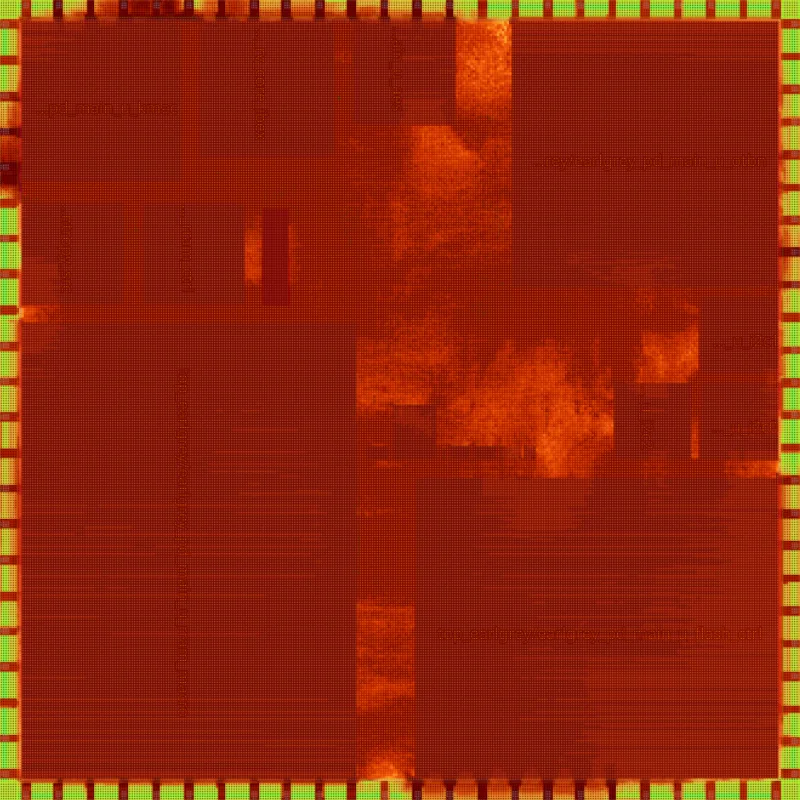
判定は 1,217,748 本のオーバーフロー。どこも赤で、最大のブロックが配線できたときのオーバーフローの約 43 倍でした。
4 つの出口、安いものから
選択肢を 4 つ書き出しました。
- A. グローバル配線の設定を 1 つ変える(otbn を直したレイヤー derate):30 分のテスト。
- B. チャネルを広げた、より大きなコア。
- C. トップレベルからブロックのピンを配置する。
- D. さらに多くのブロックをハード化する。
安いものから試しました。A でオーバーフローは 3 分の 1 減り、749,885 になりました。B は 9.6 mm のコアで 4 分の 3 減らし、176,749 になりました。それでも otbn が配線できた水準の 6 倍です。
しかし数字は役に立つことを教えてくれました。平均のトラック需要は 22% しかないのに、水平方向の層がオーバーフローしていました。このパターンが意味するのは局所的なホットスポットであり、チップが小さすぎるのではありません。次の問いは、それがどこにあるかでした。
ステップ 1:測る
テストバージョン(v4a)が v4 の配置済み設計をリンクし、追加のステージを 1 つ、プローブとして実行しました。15 秒、1.6 GB で、混雑したすべてのネットの端点、すべてのブロックピン、すべてのセルを書き出しました。その README には、オーバーフローがどこから来るか、どのネットが原因か、次に何を試すべきかが書かれています。
 2:20
YouTube で見る(英語) ↗Bilibili で見る(中国語) ↗
わかったこと:
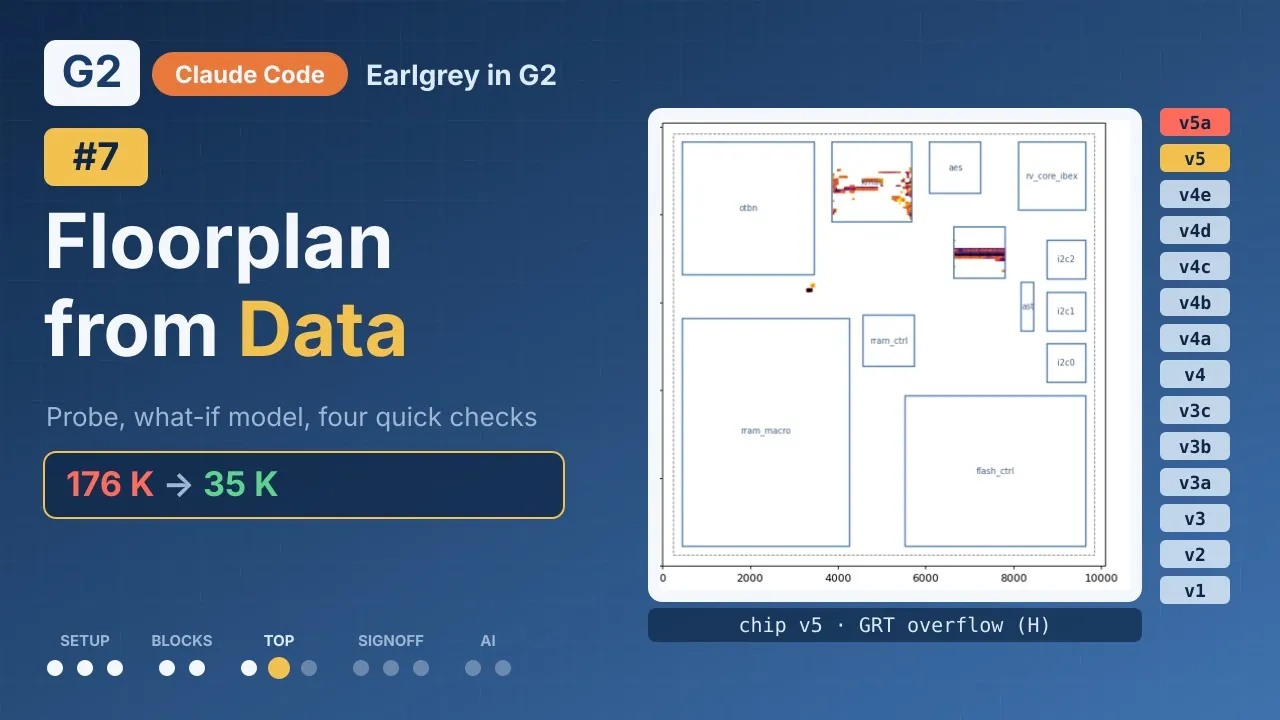
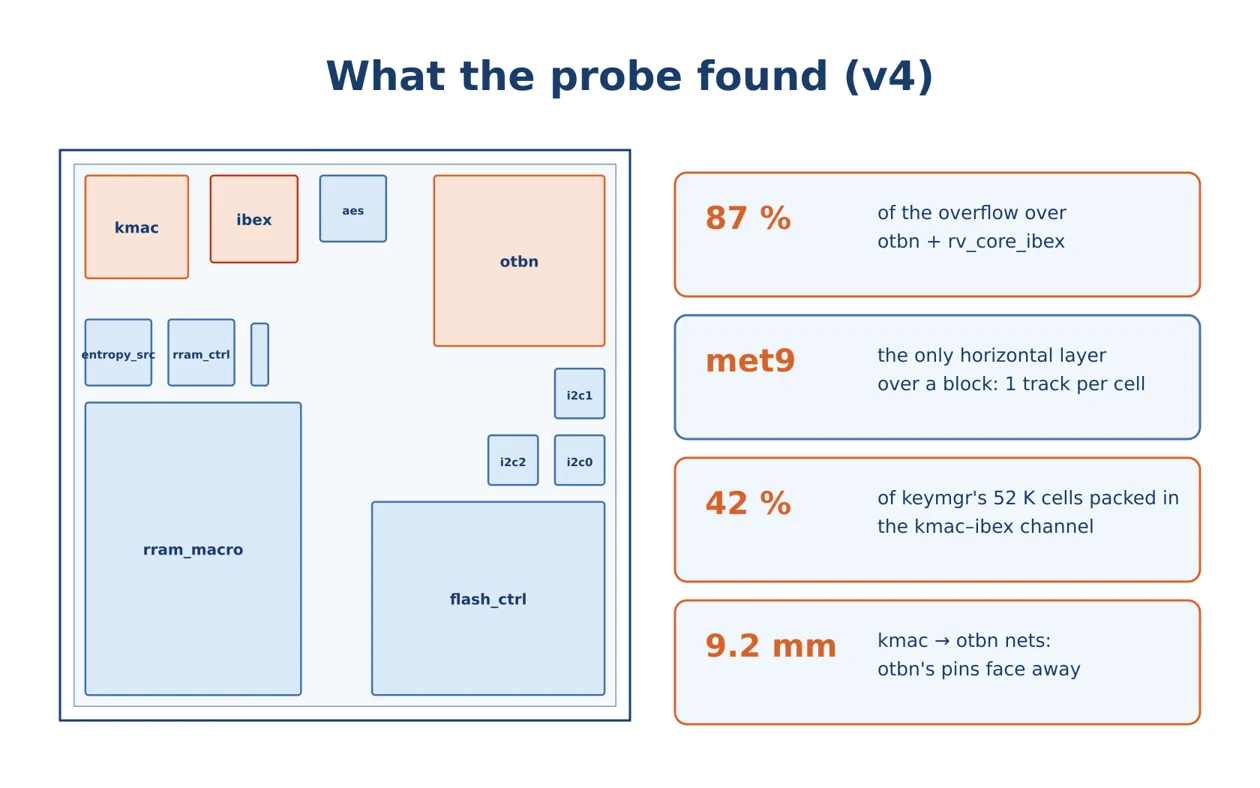
- オーバーフローの 87% は 2 つのブロックの上にありました: otbn(40%)と Ibex コア(39%)で、その 85% が水平方向です。
- ハードブロックの上で水平に走る層は 1 つだけ(私たちのスタックではメタル 9)で、配線グリッドのセルごとにトラックは 1 本です。ブロックを水平に横切るトップレベルの配線はすべて、その 1 本を奪い合います。
- キーマネージャーのロジック(51,757 セル)は、kmac と Ibex コアのあいだの 400 µm のチャネルに詰め込まれていました。その 42% がこの 1 本のチャネルにありました。
- otbn のピンは kmac と反対側を向いていたため、kmac から otbn へのネットの一部は 9 mm を超えていました。
ステップ 2:EDA を実行せず、モデルで候補を順位づける
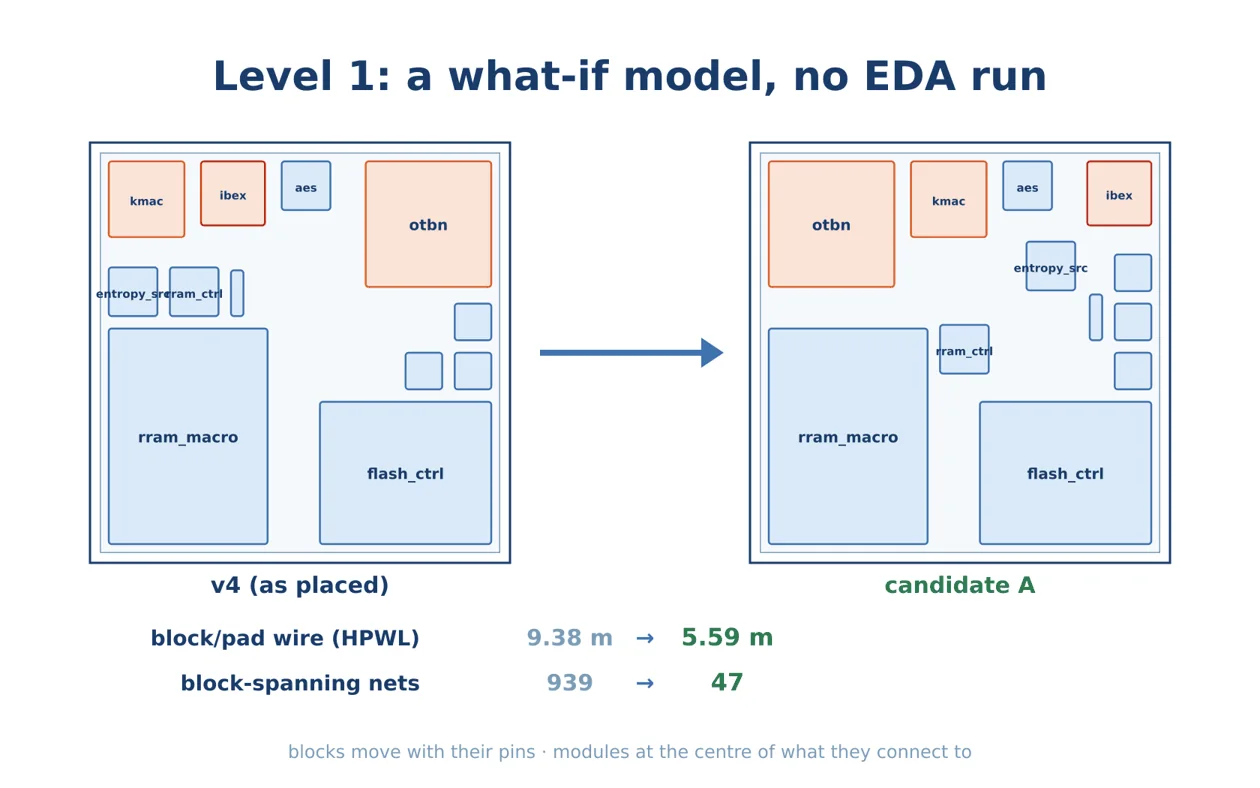
「レベル 1」のモデルは、EDA の実行ではなく簡単な what-if スクリプトです。ブロックをピンごと動かし、トップレベルの各モジュールをその接続先の中心に置き、配線長を見積もります。候補 A は otbn を角に置いてその隣に kmac を並べ、大きなマクロ 2 つを反転させ、中央を空けました。推定されるブロック間の配線長は 9.38 m から 5.59 m に減り、ブロックを横切るネットの数は 939 本から 47 本に減りました。
ステップ 3:上位の候補を短い本物の実行で確かめる
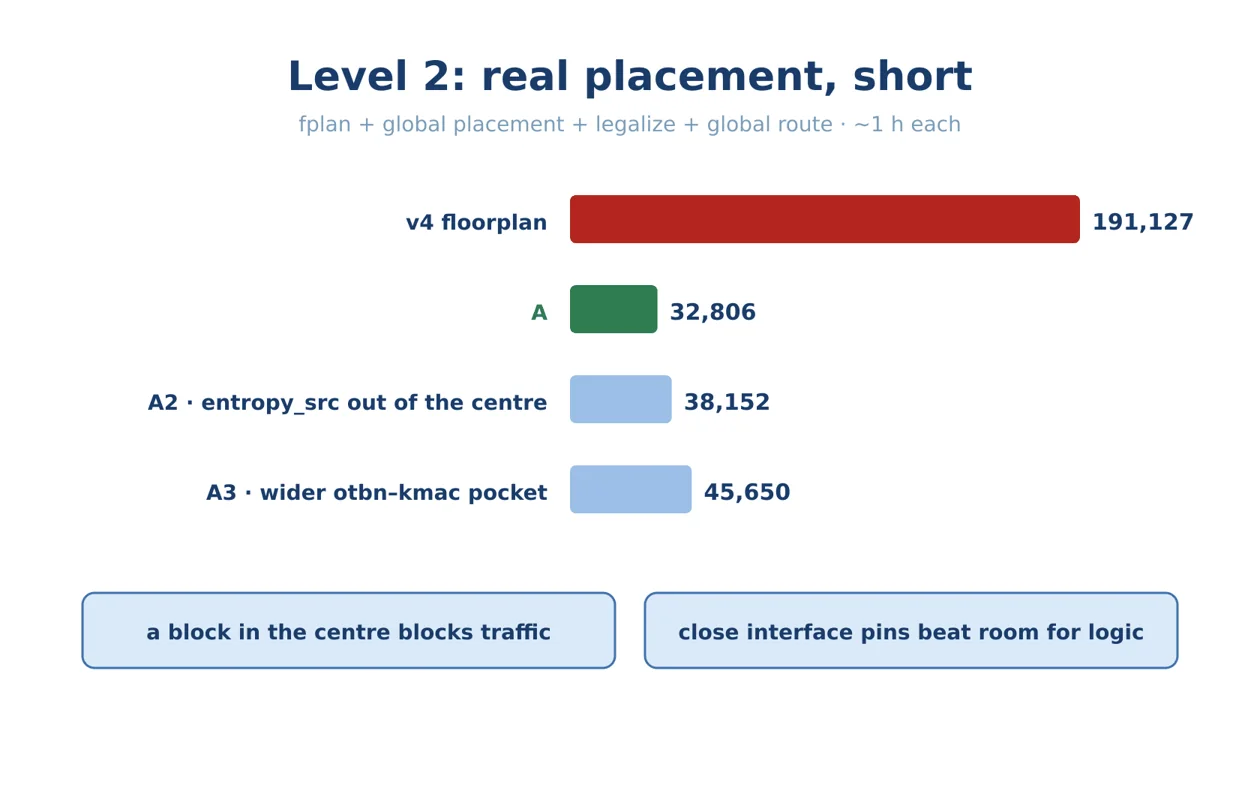
「レベル 2」は本物ですが短い実行です。グローバル配置、レガライズ、グローバル配線チェックで、候補あたり約 1 時間。それぞれが専用のテストバージョンです。
| 候補 | 変更点 | GRT オーバーフロー |
|---|---|---|
| v4c | 旧フロアプラン、同じ短いフロー(基準) | 191,127 |
| A | otbn を kmac の隣の角に置き、中央を空ける | 32,806 |
| A2 | A の変形 | 38,152 |
| A3 | A の変形 | 45,650 |
2 つの変形からも学びがありました。中央にブロックを置くと交通を妨げること、そしてロジックに余裕を与えるより、インターフェースのピンを近くに保つほうが効くことです。
ステップ 4:本番の実行
続いて候補 A をチップ v5 として本番で配置しました。予測は当たりました。オーバーフローは 34,639 本(v4 から −80%)、平均需要は 17%、配線長は 22% 減りました(103.0 m → 80.1 m)。
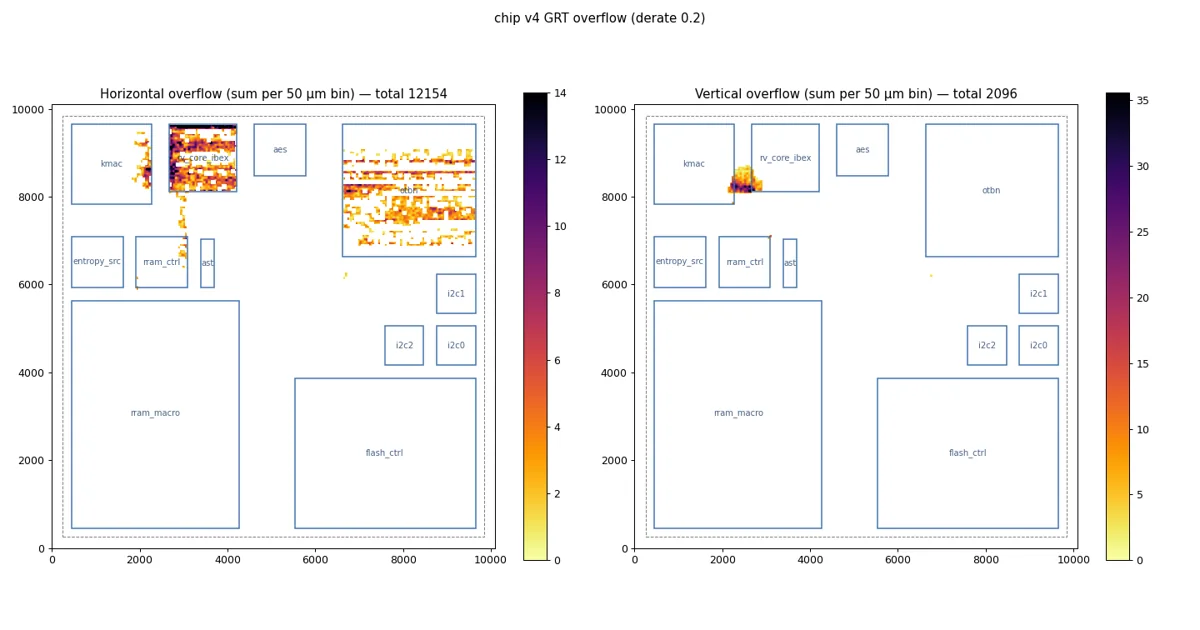
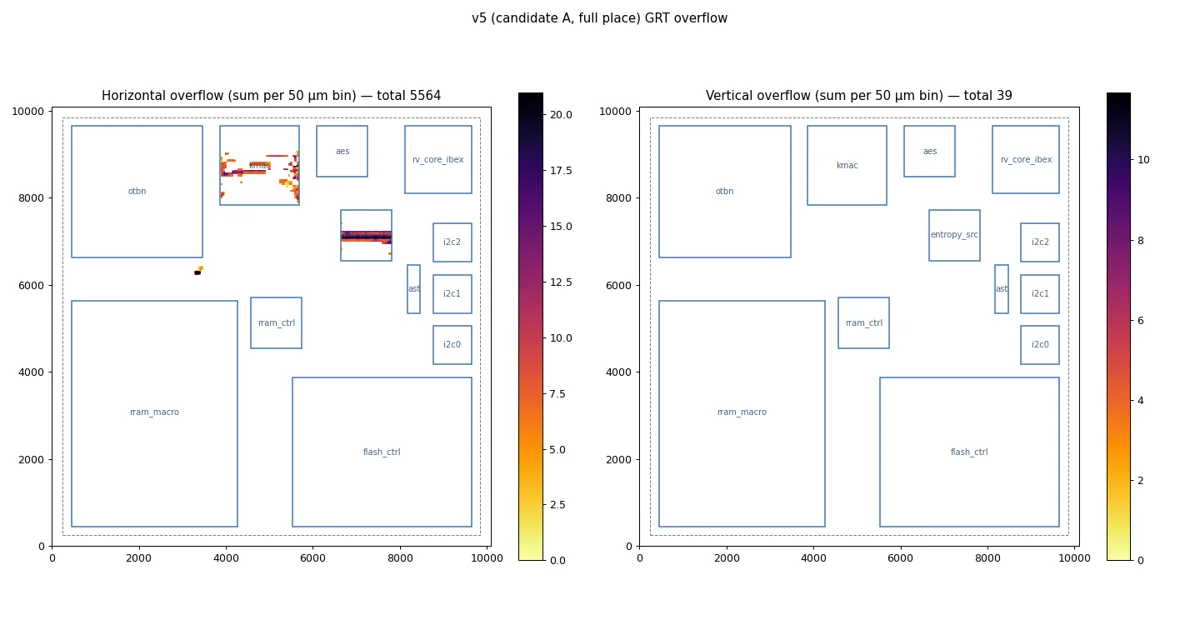
残ったのは kmac(59%)と entropy_src(35%)の上の 2 本の帯で、ほとんどがキーマネージャーから kmac へ入るバスでした。最大のブロックが配線できた水準とほぼ同じだったので、配線することに決めました。モデルにも限界があります。モジュールの位置が 1 mm ほどずれるので、本当のテストはレベル 2 のチェックです。
方法全体は 1 行に収まります。測り、順位づけ、確かめ、それから実行する。 安いステップから先に。
チップの配線:26 時間、そして予測が見落としたもの
配置のあとは、クロックツリー合成とその修正、配線、ポストルート、フィニッシュです。書類の上では 6 ステージ。実際には、主にメモリのせいで 20 回の試行が必要でした(その話は第 6 回で)。
 2:09
YouTube で見る(英語) ↗Bilibili で見る(中国語) ↗
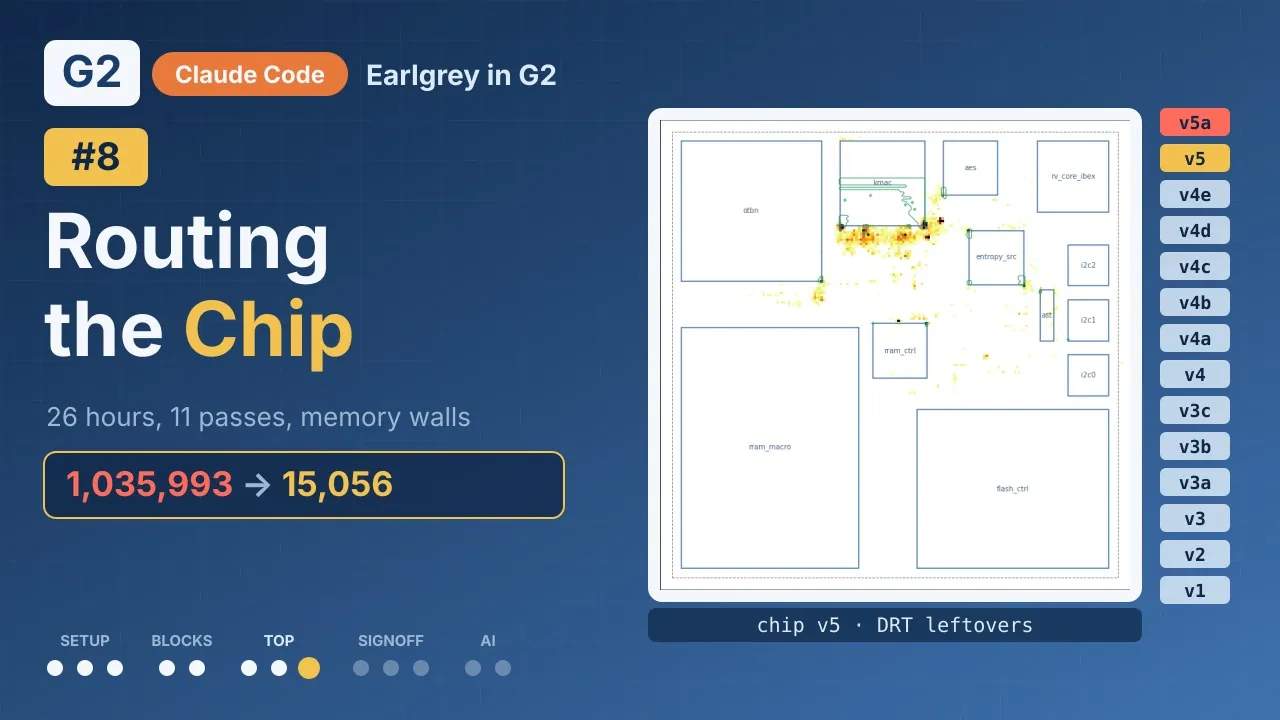
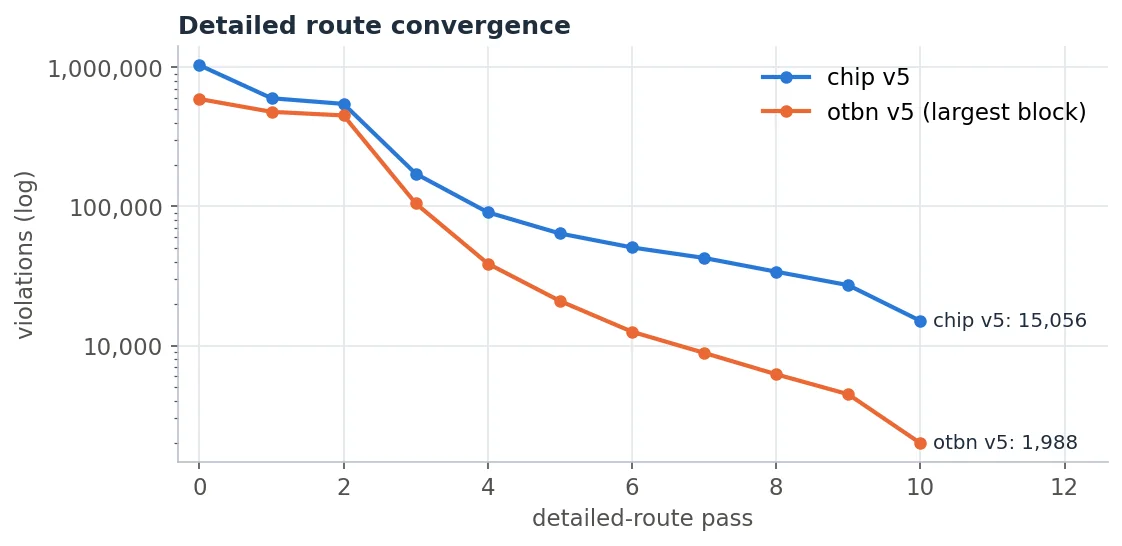
詳細配線は 11 パスで 26 時間かかり、違反は最初のパスの 1,035,993 件から、最後には 15,056 件になりました。最初の 3 パスでは、チップはブロックと同じように振る舞いました。パス 3 でブロックの違反は 4〜20 分の 1 に減りましたが、チップは 3.2 分の 1 にしか減りませんでした。その後は、パスごとに時間が長くなり、減る量は少なくなりました。
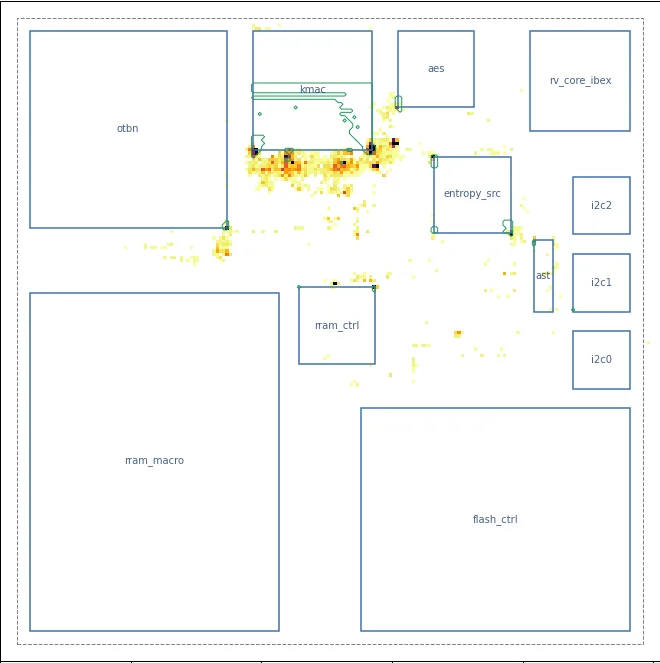
残った違反は、グローバル配線が予告したとおりの場所にあります。グローバル配線はオーバーフローの 80% を kmac の上で見つけていました。詳細配線もその配線を収めきれず、kmac のすぐ南のチャネルに押し出しました。違反の 81% が 2.5 mm² の中にあります。
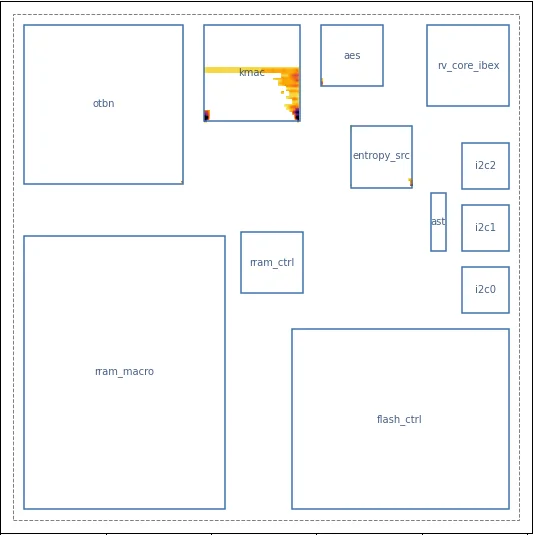
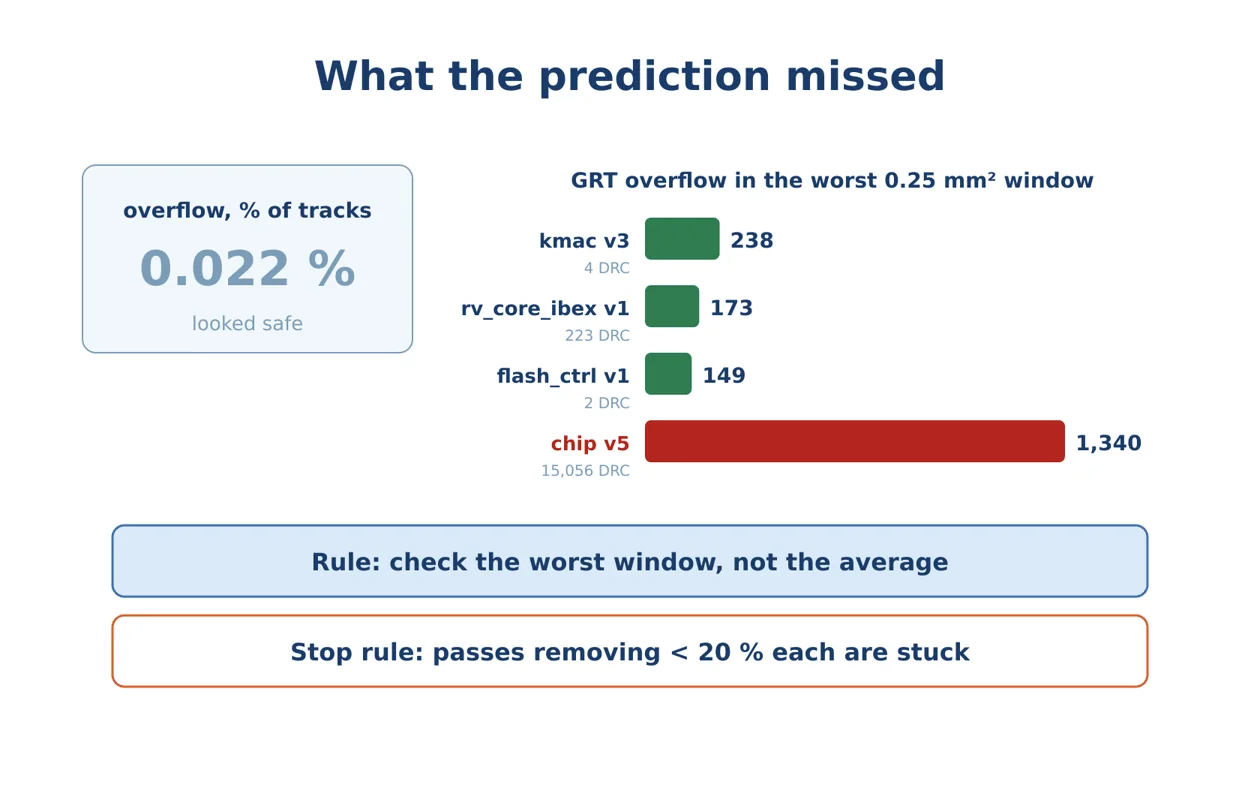
予測では、オーバーフローが全トラックの 0.022% しかないため、チップは配線可能だとしていました。それは間違った指標でした。そこから 2 つのルールが生まれました。
- 合計ではなく、最悪の小さなウィンドウを使う。 最悪の 0.25 mm² のグローバル配線ウィンドウで、チップには 1,340 本のオーバーフローがありました。配線できたブロックは 149〜238 本でした。
- パスが停滞したら止める。 詳細配線の各パスが残りの 5 分の 1 未満しか減らせなくなったら、パスを重ねても終わりません。
そして判断です。kmac 周辺のフロアプランを直す(あと 2 日ほど)か、今終えて残りを書き留めるか。これはフローのデモであってテープアウトではないので、終えることにしました。ポストルートとフィニッシュは完了し、残った課題はすべてそのバージョンのメモにあります。kmac のチャネルを直し、配線前に最悪ウィンドウのルールで確かめることが、チップ v6 の最初の項目です。
G2 がもたらしたもの
この各ステップは、どれも README 付きの G2 のバージョンでした。プローブ、4 つの短いチェック、そして配置し直しを避けた読み取り専用のテストです。だからこそ、この方法を安く実行できました。データ、判断、次のステップは、それを生んだ実行のすぐ隣に残り、フロアプランの選択は記憶ではなく数値でたどれます。
次回:完成したチップを別ツールでサインオフし、そこで OpenROAD のバグが 2 つ見つかります。