
芯片的布局布线是在一台笔记本上跑的:Intel Core Ultra 7 155H,22 个线程、30 GB 内存。另外三台小机器在 Slurm 上分担了一些比较轻的任务。最后这一篇讲这在实际上代表什么:我们设定的限制、时间花在哪里、绕线阶段试了二十次才走完,以及有更多硬件时我们会改什么。
限制
三个限制在整个项目里一直有效:
- 一次一个 EDA 任务。 两个 20 GB 的任务塞不进 30 GB。
- 每个任务 10 个线程, 在每个工具里明确设定。
- 每个任务 22 GB 内存上限,并关掉 swap。 每个任务都在
systemd-run --user --scope -p MemoryMax=22G -p MemorySwapMax=0下运行。超过上限的任务会很快以清楚的内存不足错误结束,而不是让笔记本 swap 到动弹不得。芯片绕线时我们把上限调高到 26 GB,那也是在工程师同意之后。
在 Slurm 上,--mem 只影响调度,并不会真正限制。小节点最多只有大约 15 GB,低于芯片和 otbn 任务需要的 20 GB 以上。所以我们按任务预期的内存峰值来挑节点,大任务都留在笔记本上。
时间花在哪里
芯片 v5 的各个阶段,数据来自每次运行的 GNU time 日志。「使用核数」是 CPU 时间除以实际时间:平均有几个线程(总共 10 个)在忙。
| 阶段 | 实际时间 | 使用核数 | 内存峰值 |
|---|---|---|---|
| init | 4 分钟 | 1.2 | 4.4 GB |
| floorplan | 8 分钟 | 1.0 | 5.1 GB |
| place | 2 小时 51 分钟 | 1.6 | 15.8 GB |
| CTS | 6 分钟 | 1.5 | 9.7 GB |
| post-CTS 修复 | 34 分钟 | 2.8 | 17.5 GB |
| route | 26 小时 12 分钟 | 8.9 | 22.4 GB |
| post-route | 12 分钟 | 1.3 | 20.1 GB |
| finish(轻量) | 8 分钟 | 0.3 | 6.1 GB |
| 寄生提取(OpenRCX,4 个 corner) | 30 分钟 | 0.8 | 3.7 GB |
| 签核 STA(OpenSTA,每个 corner) | 3 分钟 | 2.2 | 5.9 GB |
有两个明显的模式:
- 布局和它的修复大部分只用一个核。 芯片的布局平均只用了 1.6 个核;扁平芯片 24.7 小时的布局里,有 22.5 小时是单线程的
repair_design(第 2 篇)。在那里,更多的核也帮不上忙。帮上忙的是层次化。 - 详细绕线用满所有线程,也用掉最多内存。 它是唯一让 10 个线程里大约 9 个一直在忙的步骤,内存峰值也由它决定。最大的模块也是一样:otbn 的绕线花了 6 小时,用了 9.4 个核、19.5 GB。
相比之下,签核很便宜。只要文件已经有了,寄生提取半小时,一次时序分析几分钟,所以修正之后重跑签核很容易。
试了二十次,大部分是内存
布局之后,芯片 v5 试了二十次才走完最后五个阶段。大部分失败都是碰到上限的内存不足,而不是崩溃或结果错误:
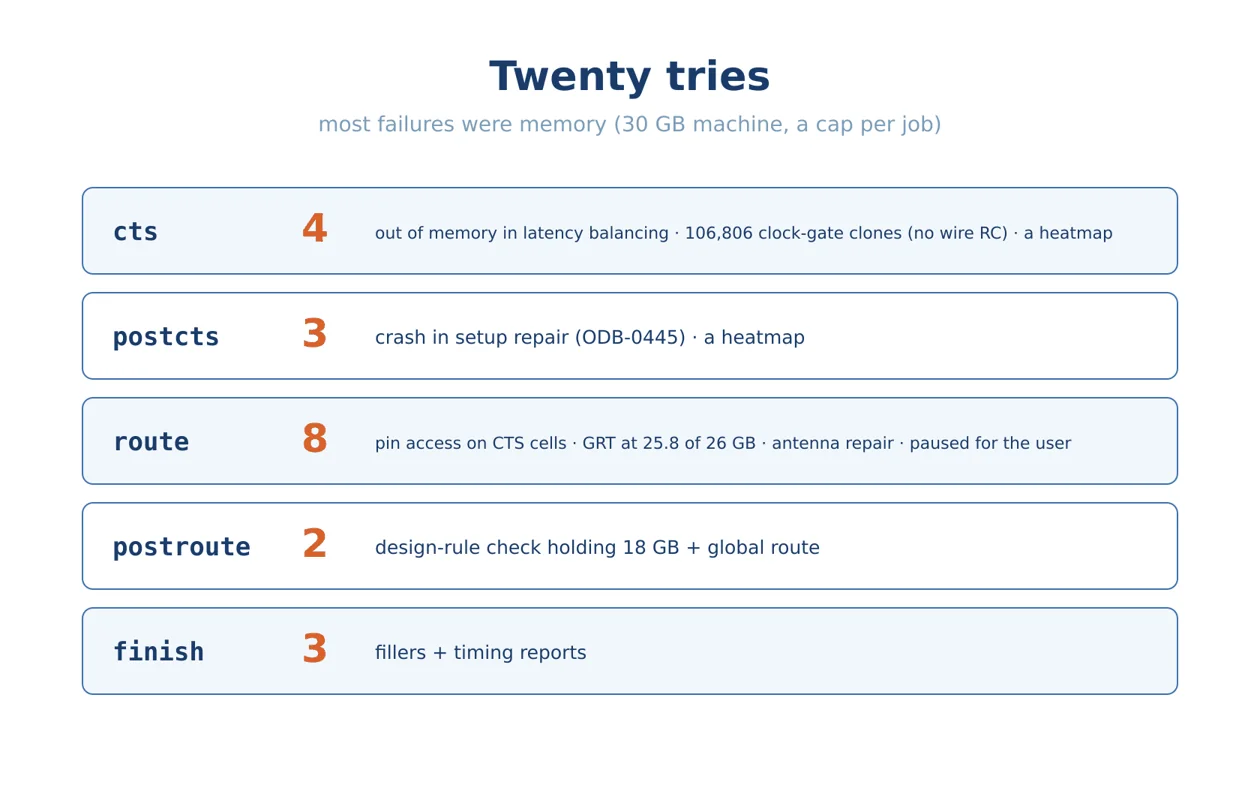
几个重点:
- 少了一个线模型,让 CTS 复制出 106,806 个时钟门控。修正只是一行
set_wire_rc。 - 全局绕线的峰值是 25.8 GB,上限是 26 GB。
- 绕线后处理里的一次设计规则检查,在全局绕线还加载着的时候,占了 18 GB 的数据。
- 热图、天线修复,以及 finish 阶段的填充单元加上时序报告,每一项都曾让一次运行超过上限。
- 有一次工程师需要把笔记本拿回来用,所以绕线在第一轮里暂停,之后从保存的全局绕线结果继续。
每一次失败都永久改变了流程:
- 全局绕线和详细绕线分成两个进程,中间保存全局绕线的结果。
- 芯片不画热图。
- 在报告之前先存 checkpoint, 报告内存不足时就不会丢掉结果。
- 轻量的 finish,不放填充单元;绕线后处理不做完整的设计规则检查。
- 演示时关掉天线修复,记成遗留问题。
这些都不稀奇。但它们加在一起,决定了一个百万单元的顶层到底能不能在 30 GB 的机器上跑起来。
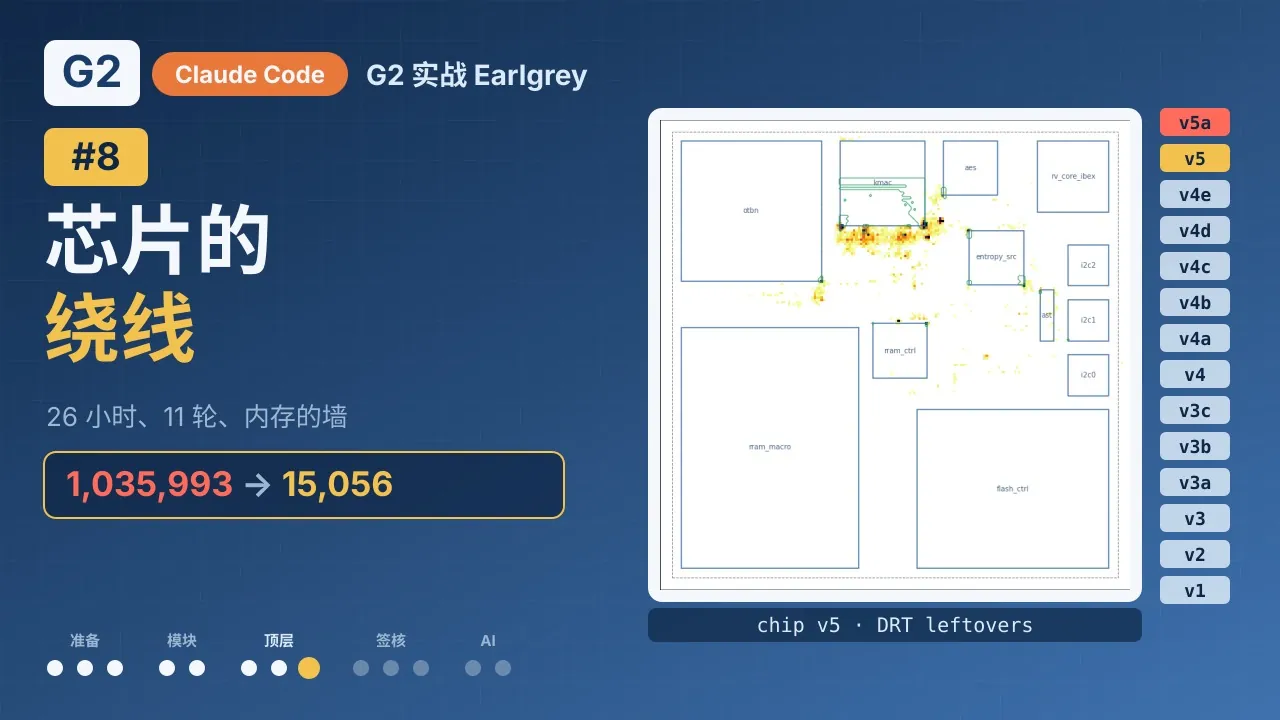 2:08
在 YouTube 观看(英文) ↗在 Bilibili 观看(中文) ↗
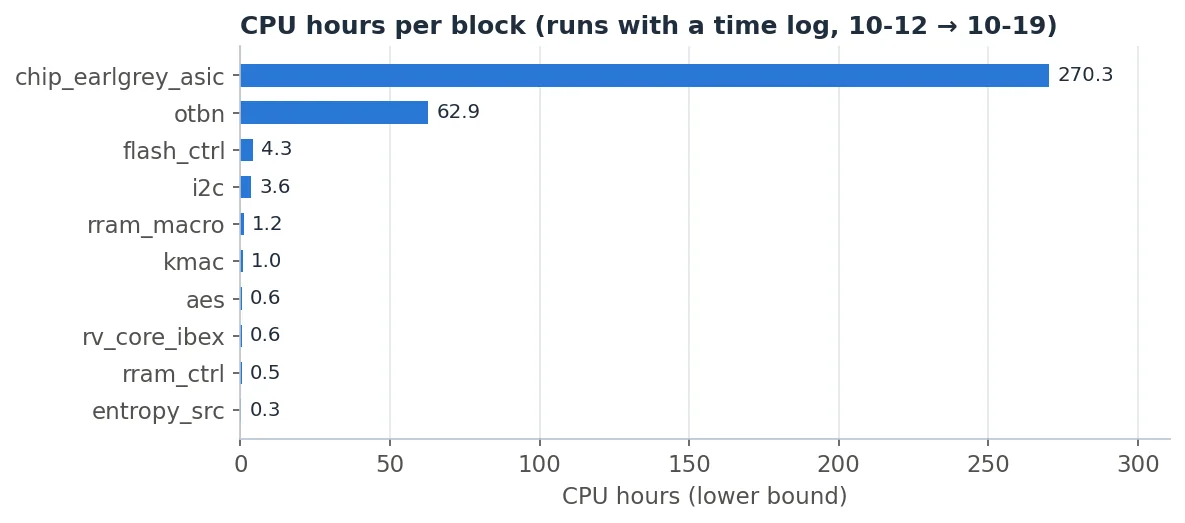
总数
这个总数是下限。计时日志从 10 月 12 日才开始有,而且每个阶段只保留最后一次运行,所以扁平芯片 24.7 小时的布局、大部分早期的模块运行,以及每一次失败的尝试都不在里面。
什么时候更多机器有帮助,什么时候没有
更多内存能省下最多时间。 二十次尝试里大部分是内存问题,不是速度问题。一台 64 GB 的机器能避开大部分失败,也就不需要拆进程、协商上限。
更多机器对彼此独立的任务有帮助:
- 九个模块一个接一个,布局布线花了大约 20 小时。在内存够的机器上,它们可以并行。i2c、aes 和 kmac 这类小模块放得进 15 GB 的节点;otbn 的绕线(19.5 GB)和一些 finish 阶段(大约 22 GB)放不进去。
- 四次第二级 floorplan 检查(第 3 篇)每次大约一小时,峰值接近 20 GB。有四个够大的节点,就只要一小时,而不是四小时。
- 探测和签核运行都很小,放在哪里都行。拥挤度探测在一个 Slurm 节点上只跑了 15 秒。
更多机器缩短不了一次长时间的运行。 26 小时的详细绕线是一台机器上的一个进程,已经用了大约 9 个核。布局大部分是串行的。缩短它们的是设计:层次化让布局从 24.7 小时变成 2.8 小时,而更好的 floorplan(修好 kmac 通道)才能缩短绕线。
一个画面看完这个系列
这个系列展示的所有东西:
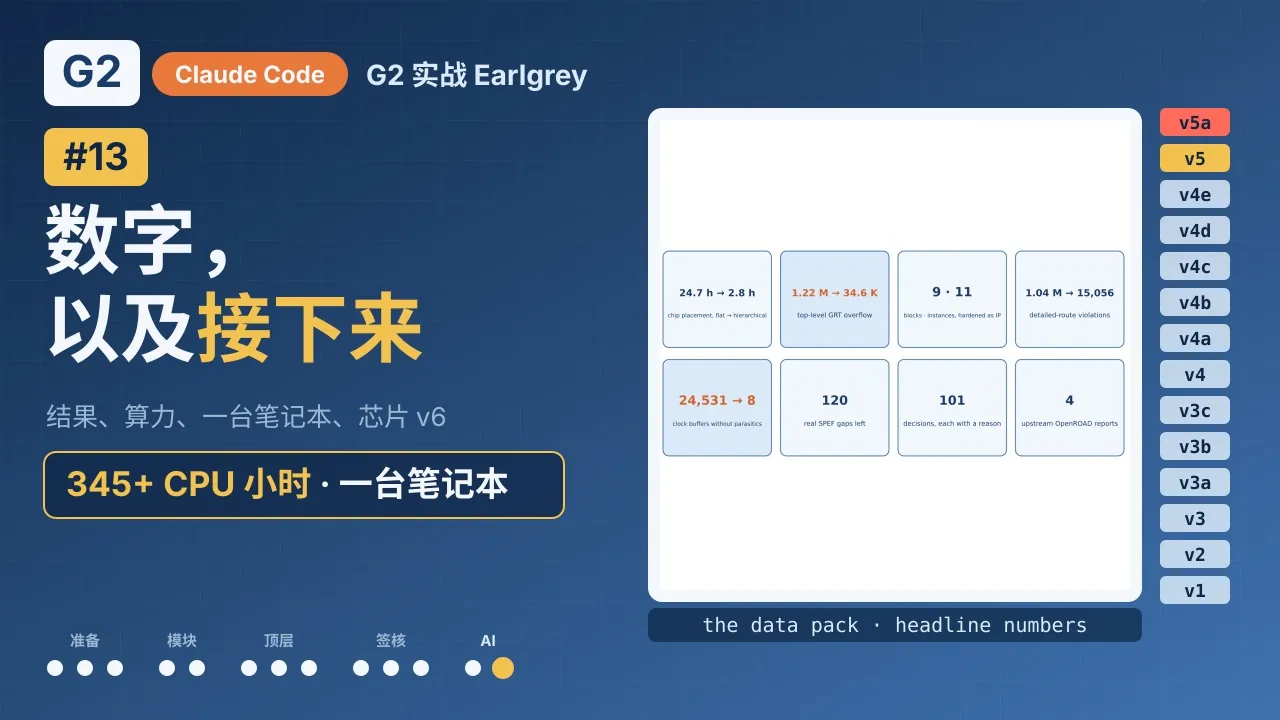 1:38
在 YouTube 观看(英文) ↗在 Bilibili 观看(中文) ↗
仍然不是流片
如同我们一路上说的:上面几层金属是替代的 10 层金属堆叠,存储器是 FakeRAM 模型,时钟是 10 MHz 的演示目标,芯片也还有遗留问题。这些遗留问题是 15,056 个绕线违例、没有时序例外的 IO 路径、没有 hold 报告,以及 pad 环上断开的 VDD 连接。芯片 v5 还混用了两个 OpenROAD 版本和一个修补过的数据库。
下一个芯片版本 v6 会补上这些缺口:
- 电源网络连到 pad 的金属层,VDD 和 VSS 都检查。
- 重做 kmac 通道,并在绕线前用最差窗口规则检查。
- IO 路径的时序例外。
- 签核里的 hold 报告。
- 整次运行只用一个 OpenROAD 版本,不打补丁。
去哪里找
- G2:GitHub 上免费的社区版
- 视频:「Earlgrey in G2」,13 集,在 YouTube 和 Bilibili
- OpenROAD 的修正:issue #11839 和 #11840,pull request #11841 和 #11842
开源工具可以把一颗百万单元的 SoC 从 RTL 做到签核时序。有一个记录一切的流程管理器、一个在它的规则里工作的助手,以及一位做决定的工程师,这就是一个能跑、能讲清楚、也能在一台笔记本上重复的项目。