
晶片的佈局繞線是在一台筆電上跑的:Intel Core Ultra 7 155H,22 個執行緒、30 GB 記憶體。另外三台小機器在 Slurm 上分擔了一些比較輕的任務。最後這一篇講這在實際上代表什麼:我們設定的限制、時間花在哪裡、繞線階段試了二十次才走完,以及有更多硬體時我們會改什麼。
限制
三個限制在整個專案裡一直有效:
- 一次一個 EDA 任務。 兩個 20 GB 的任務塞不進 30 GB。
- 每個任務 10 個執行緒, 在每個工具裡明確設定。
- 每個任務 22 GB 記憶體上限,並關掉 swap。 每個任務都在
systemd-run --user --scope -p MemoryMax=22G -p MemorySwapMax=0下執行。超過上限的任務會很快以清楚的記憶體不足錯誤結束,而不是讓筆電 swap 到動彈不得。晶片繞線時我們把上限調高到 26 GB,那也是在工程師同意之後。
在 Slurm 上,--mem 只影響排程,並不會真正限制。小節點最多只有大約 15 GB,低於晶片和 otbn 任務需要的 20 GB 以上。所以我們按任務預期的記憶體峰值來挑節點,大任務都留在筆電上。
時間花在哪裡
晶片 v5 的各個階段,資料來自每次執行的 GNU time 日誌。「使用核數」是 CPU 時間除以實際時間:平均有幾個執行緒(總共 10 個)在忙。
| 階段 | 實際時間 | 使用核數 | 記憶體峰值 |
|---|---|---|---|
| init | 4 分鐘 | 1.2 | 4.4 GB |
| floorplan | 8 分鐘 | 1.0 | 5.1 GB |
| place | 2 小時 51 分鐘 | 1.6 | 15.8 GB |
| CTS | 6 分鐘 | 1.5 | 9.7 GB |
| post-CTS 修復 | 34 分鐘 | 2.8 | 17.5 GB |
| route | 26 小時 12 分鐘 | 8.9 | 22.4 GB |
| post-route | 12 分鐘 | 1.3 | 20.1 GB |
| finish(輕量) | 8 分鐘 | 0.3 | 6.1 GB |
| 寄生提取(OpenRCX,4 個 corner) | 30 分鐘 | 0.8 | 3.7 GB |
| 簽核 STA(OpenSTA,每個 corner) | 3 分鐘 | 2.2 | 5.9 GB |
有兩個明顯的模式:
- 佈局和它的修復大部分只用一個核。 晶片的佈局平均只用了 1.6 個核;扁平晶片 24.7 小時的佈局裡,有 22.5 小時是單執行緒的
repair_design(第 2 篇)。在那裡,更多的核也幫不上忙。幫上忙的是層次化。 - 細部繞線用滿所有執行緒,也用掉最多記憶體。 它是唯一讓 10 個執行緒裡大約 9 個一直在忙的步驟,記憶體峰值也由它決定。最大的模組也是一樣:otbn 的繞線花了 6 小時,用了 9.4 個核、19.5 GB。
相比之下,簽核很便宜。只要檔案已經有了,寄生提取半小時,一次時序分析幾分鐘,所以修正之後重跑簽核很容易。
試了二十次,大部分是記憶體
佈局之後,晶片 v5 試了二十次才走完最後五個階段。大部分失敗都是碰到上限的記憶體不足,而不是崩潰或結果錯誤:
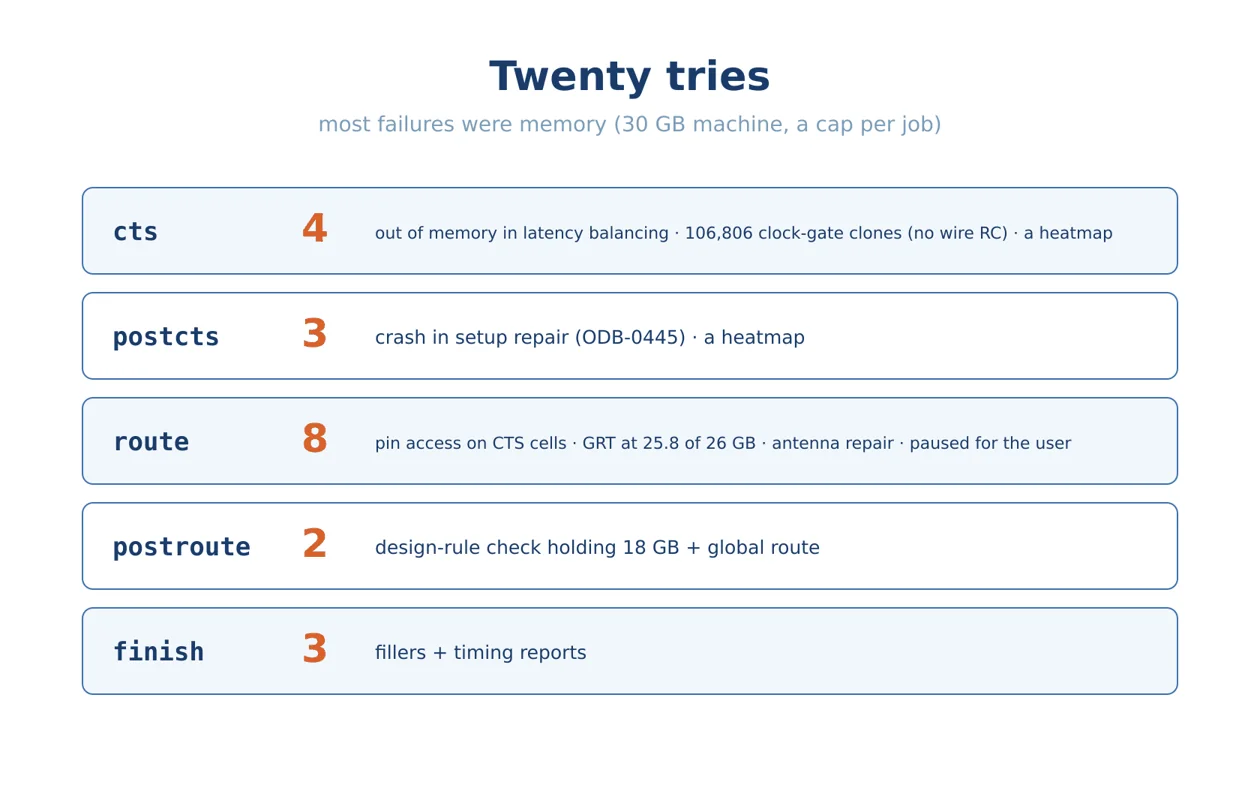
幾個重點:
- 少了一個線模型,讓 CTS 複製出 106,806 個時脈閘控。修正只是一行
set_wire_rc。 - 全域繞線的峰值是 25.8 GB,上限是 26 GB。
- 繞線後處理裡的一次設計規則檢查,在全域繞線還載入著的時候,佔了 18 GB 的資料。
- 熱力圖、天線修復,以及 finish 階段的填充單元加上時序報告,每一項都曾讓一次執行超過上限。
- 有一次工程師需要把筆電拿回來用,所以繞線在第一輪裡暫停,之後從儲存的全域繞線結果繼續。
每一次失敗都永久改變了流程:
- 全域繞線和細部繞線分成兩個程序,中間儲存全域繞線的結果。
- 晶片不畫熱力圖。
- 在報告之前先存 checkpoint, 報告記憶體不足時就不會丟掉結果。
- 輕量的 finish,不放填充單元;繞線後處理不做完整的設計規則檢查。
- 示範時關掉天線修復,記成遺留問題。
這些都不稀奇。但它們加在一起,決定了一個百萬單元的頂層到底能不能在 30 GB 的機器上跑起來。
 2:08
在 YouTube 觀看(英文) ↗在 Bilibili 觀看(中文) ↗
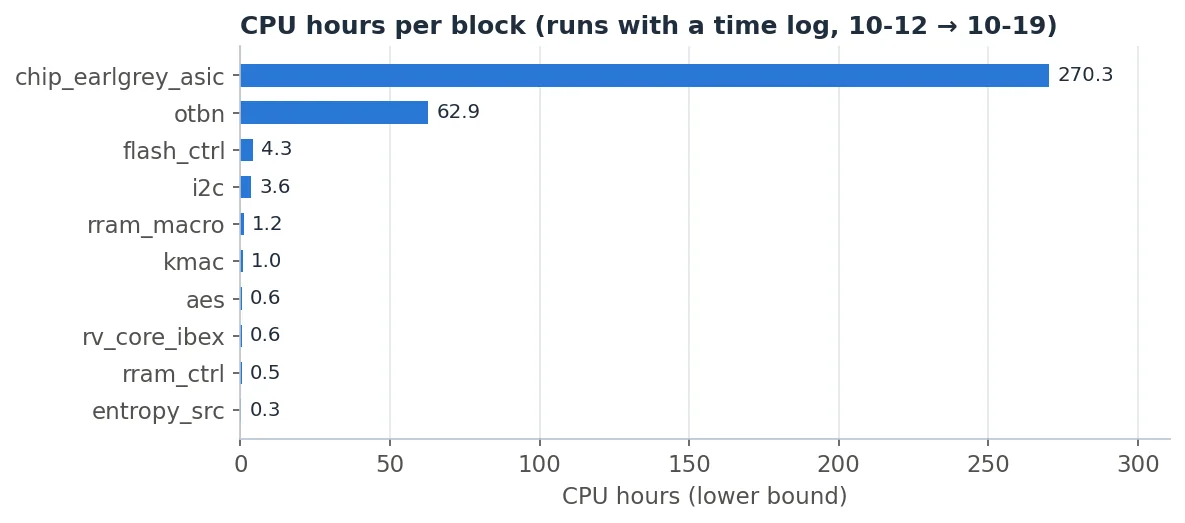
總數
這個總數是下限。計時日誌從 10 月 12 日才開始有,而且每個階段只保留最後一次執行,所以扁平晶片 24.7 小時的佈局、大部分早期的模組執行,以及每一次失敗的嘗試都不在裡面。
什麼時候更多機器有幫助,什麼時候沒有
更多記憶體能省下最多時間。 二十次嘗試裡大部分是記憶體問題,不是速度問題。一台 64 GB 的機器能避開大部分失敗,也就不需要拆程序、協商上限。
更多機器對彼此獨立的任務有幫助:
- 九個模組一個接一個,佈局繞線花了大約 20 小時。在記憶體夠的機器上,它們可以並行。i2c、aes 和 kmac 這類小模組放得進 15 GB 的節點;otbn 的繞線(19.5 GB)和一些 finish 階段(大約 22 GB)放不進去。
- 四次第二級 floorplan 檢查(第 3 篇)每次大約一小時,峰值接近 20 GB。有四個夠大的節點,就只要一小時,而不是四小時。
- 探測和簽核執行都很小,放在哪裡都行。擁擠度探測在一個 Slurm 節點上只跑了 15 秒。
更多機器縮短不了一次長時間的執行。 26 小時的細部繞線是一台機器上的一個程序,已經用了大約 9 個核。佈局大部分是序列的。縮短它們的是設計:層次化讓佈局從 24.7 小時變成 2.8 小時,而更好的 floorplan(修好 kmac 通道)才能縮短繞線。
一個畫面看完這個系列
這個系列展示的所有東西:
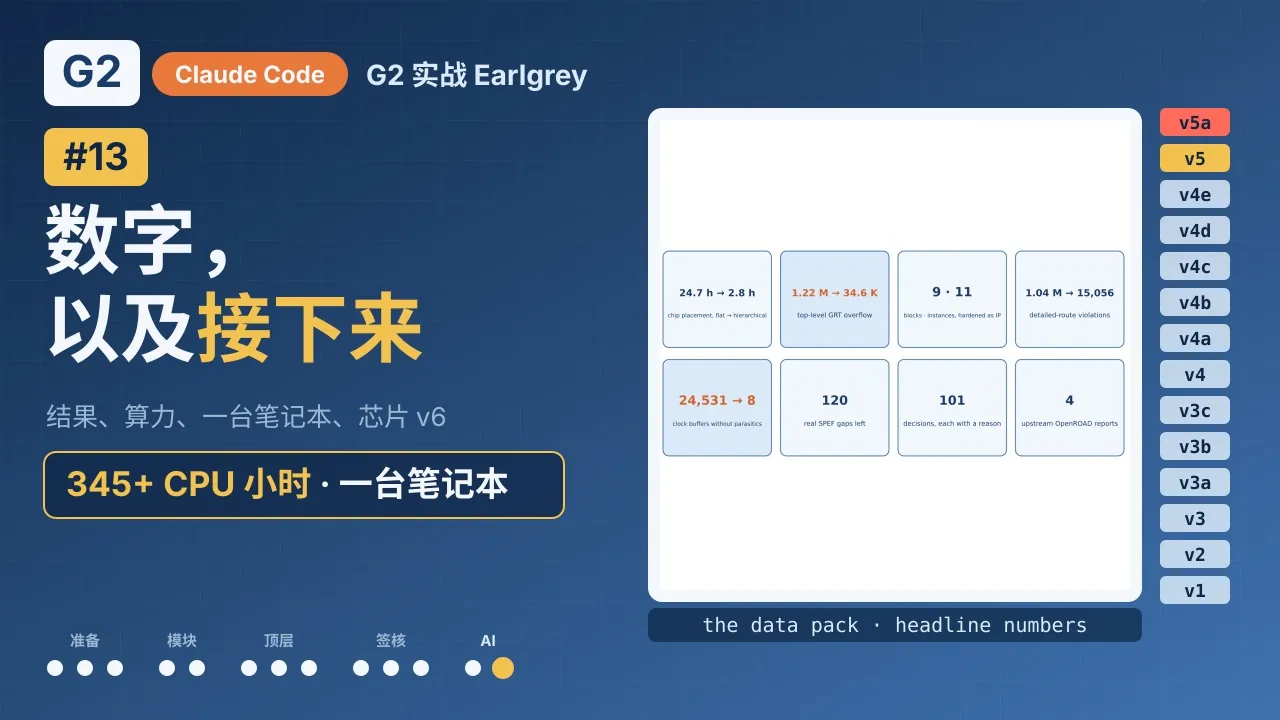 1:38
在 YouTube 觀看(英文) ↗在 Bilibili 觀看(中文) ↗
仍然不是下線
如同我們一路上說的:上面幾層金屬是替代的 10 層金屬堆疊,記憶體是 FakeRAM 模型,時脈是 10 MHz 的示範目標,晶片也還有遺留問題。這些遺留問題是 15,056 個繞線違例、沒有時序例外的 IO 路徑、沒有 hold 報告,以及 pad 環上斷開的 VDD 連接。晶片 v5 還混用了兩個 OpenROAD 版本和一個修補過的資料庫。
下一個晶片版本 v6 會補上這些缺口:
- 電源網路連到 pad 的金屬層,VDD 和 VSS 都檢查。
- 重做 kmac 通道,並在繞線前用最差區域規則檢查。
- IO 路徑的時序例外。
- 簽核裡的 hold 報告。
- 整次執行只用一個 OpenROAD 版本,不打補丁。
去哪裡找
- G2:GitHub 上免費的社群版
- 影片:「Earlgrey in G2」,13 集,在 YouTube 和 Bilibili
- OpenROAD 的修正:issue #11839 和 #11840,pull request #11841 和 #11842
開源工具可以把一顆百萬單元的 SoC 從 RTL 做到簽核時序。有一個記錄一切的流程管理器、一個在它的規則裡工作的助手,以及一位做決定的工程師,這就是一個能跑、能講清楚、也能在一台筆電上重複的專案。