
칩의 배치와 배선은 노트북 한 대에서 돌아갔습니다. 22 스레드와 30 GB RAM을 갖춘 Intel Core Ultra 7 155H입니다. Slurm의 작은 컴퓨터 세 대가 가벼운 작업 일부를 맡았습니다. 이 마지막 글은 그것이 실제로 무엇을 의미했는지를 다룹니다. 저희가 둔 제한, 시간이 어디에 쓰였는지, 배선을 통과하는 데 걸린 스무 번의 시도, 그리고 하드웨어가 더 있었다면 무엇을 바꿨을지입니다.
제한
프로젝트 내내 세 가지 제한을 지켰습니다.
- EDA 작업은 한 번에 하나. 20 GB 작업 두 개는 30 GB에 들어가지 않습니다.
- 작업당 스레드 10개, 모든 도구에서 명시적으로 설정했습니다.
- 작업당 메모리 22 GB 상한, 스왑 없음. 각 작업은
systemd-run --user --scope -p MemoryMax=22G -p MemorySwapMax=0아래에서 실행했습니다. 상한을 넘는 작업은 노트북을 스왑으로 멈춰 세우는 대신 명확한 메모리 부족 오류와 함께 빠르게 종료됩니다. 칩 배선에서는 엔지니어가 동의한 뒤에만 상한을 26 GB로 올렸습니다.
Slurm에서 --mem은 스케줄링을 안내할 뿐 강제되지 않았습니다. 작은 노드의 메모리는 최대 약 15 GB로, 칩과 otbn 작업에 필요한 20 GB 이상에 못 미쳤습니다. 그래서 작업의 예상 최대 메모리로 노드를 골랐고, 큰 작업은 노트북에 남았습니다.
시간이 어디에 쓰였나
칩 v5의 단계별 기록으로, 각 실행의 GNU time 로그에서 가져왔습니다. "사용 코어"는 CPU 시간을 실제 경과 시간으로 나눈 값으로, 스레드 10개 중 평균적으로 몇 개가 바빴는지를 나타냅니다.
| 단계 | 경과 시간 | 사용 코어 | 최대 메모리 |
|---|---|---|---|
| init | 4분 | 1.2 | 4.4 GB |
| 플로어플랜 | 8분 | 1.0 | 5.1 GB |
| 배치 | 2시간 51분 | 1.6 | 15.8 GB |
| CTS | 6분 | 1.5 | 9.7 GB |
| 포스트 CTS 수리 | 34분 | 2.8 | 17.5 GB |
| 배선 | 26시간 12분 | 8.9 | 22.4 GB |
| 포스트 라우트 | 12분 | 1.3 | 20.1 GB |
| 피니시(경량) | 8분 | 0.3 | 6.1 GB |
| 추출(OpenRCX, 4 코너) | 30분 | 0.8 | 3.7 GB |
| 사인오프 STA(OpenSTA, 코너별) | 3분 | 2.2 | 5.9 GB |
두 가지 패턴이 두드러집니다.
- 배치와 그 수리 단계는 대부분 코어 하나로 돌아갑니다. 칩의 배치는 평균 1.6 코어를 썼고, 플랫 칩의 24.7시간 배치 중 22.5시간은 싱글 스레드
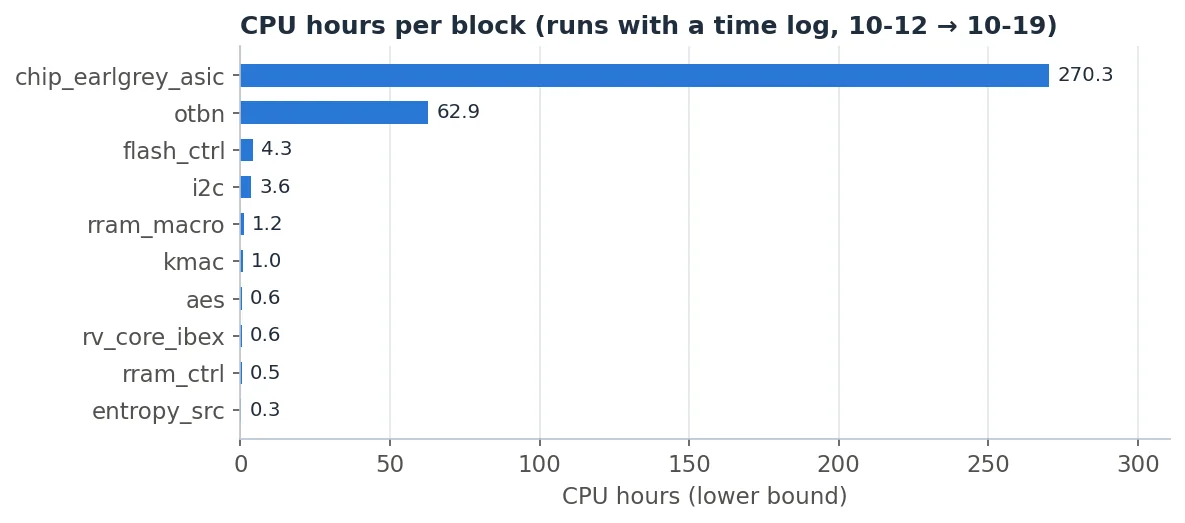
repair_design이었습니다(2편). 코어가 더 있어도 거기서는 도움이 되지 않았을 것입니다. 도움이 된 것은 계층 구조였습니다. - 상세 배선은 스레드를 모두 쓰고 메모리도 가장 많이 씁니다. 스레드 10개 중 약 9개를 계속 바쁘게 한 유일한 단계이며, 메모리 최대치도 이 단계가 정했습니다. 가장 큰 블록도 마찬가지였습니다. otbn의 배선은 9.4 코어, 19.5 GB로 6시간이 걸렸습니다.
이에 비하면 사인오프는 저렴합니다. 파일이 있으면 추출은 30분, 타이밍 실행은 몇 분이므로, 수정 후 사인오프를 다시 돌리기가 쉽습니다.
스무 번의 시도, 대부분 메모리
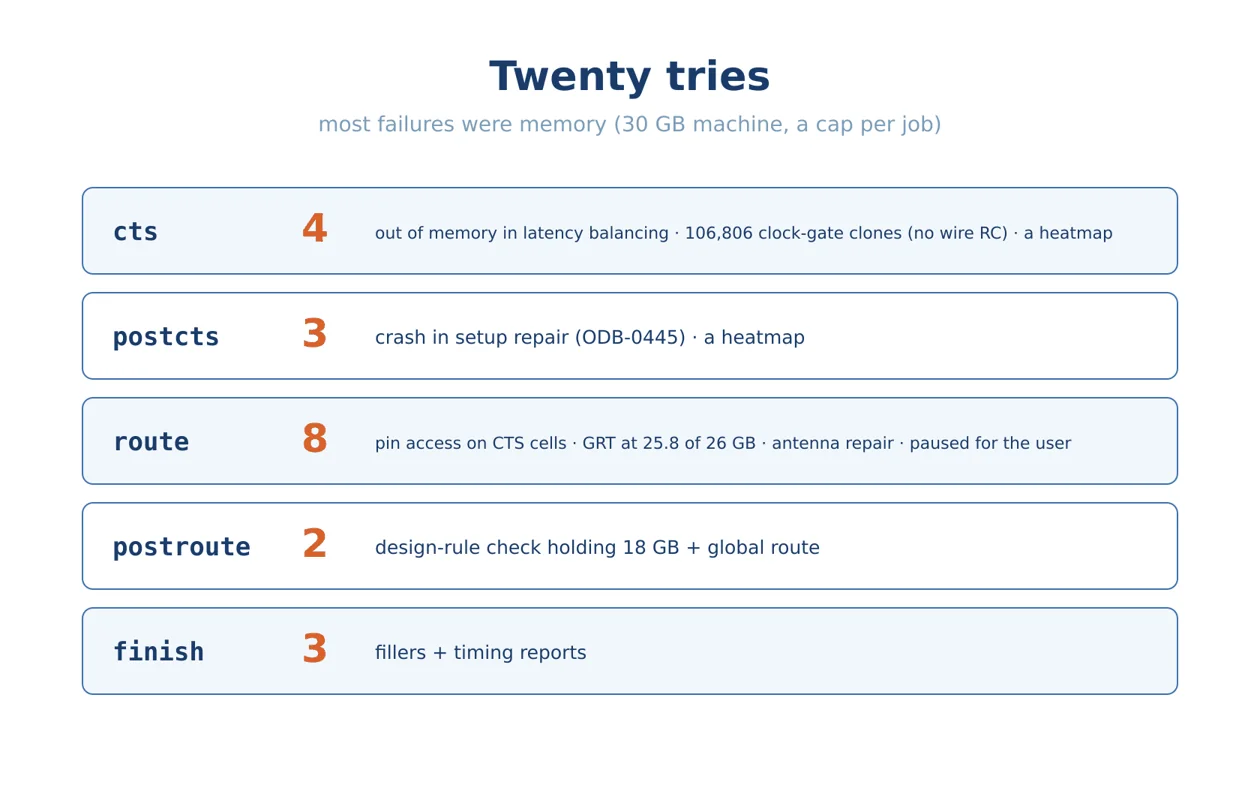
배치 후 칩 v5는 마지막 다섯 단계를 통과하는 데 스무 번의 시도가 필요했습니다. 대부분의 실패는 비정상 종료나 잘못된 결과가 아니라 상한에 걸린 메모리 부족 오류였습니다.
몇 가지 주요 사례:
- 빠진 와이어 모델 때문에 CTS가 클록 게이트 106,806개를 복제했습니다. 해결책은
set_wire_rc한 줄이었습니다. - 글로벌 라우팅은 26 GB 상한에 대해 최대 25.8 GB까지 썼습니다.
- 포스트 라우트의 설계 규칙 검사는 글로벌 라우팅이 아직 메모리에 올라와 있는 상태에서 18 GB의 데이터를 잡고 있었습니다.
- 히트맵, 안테나 수리, 그리고 피니시 단계의 필러와 타이밍 리포트가 각각 실행을 상한 너머로 밀어냈습니다.
- 한번은 엔지니어가 노트북을 다시 써야 해서, 배선을 첫 패스 중에 일시 정지했다가 나중에 저장된 글로벌 라우팅 결과에서 재개했습니다.
실패마다 흐름이 영구적으로 바뀌었습니다.
- 글로벌 배선과 상세 배선을 별도 프로세스로 실행하고, 그 사이에 글로벌 라우팅 결과를 저장합니다.
- 칩에서는 히트맵을 만들지 않습니다.
- 리포트 전에 체크포인트를 저장해, 리포트가 메모리 부족으로 실패해도 결과를 잃지 않습니다.
- 필러 없는 경량 피니시, 그리고 전체 설계 규칙 검사 없는 포스트 라우트.
- 안테나 수리는 시연에서는 끄고, 남은 문제로 기록했습니다.
이 중 특이한 것은 하나도 없습니다. 하지만 이것들이 모여, 백만 셀 톱 레벨이 30 GB 컴퓨터에 들어갈 수 있느냐를 결정했습니다.
 2:09
YouTube에서 보기(영어) ↗Bilibili에서 보기(중국어) ↗
합계
합계는 하한값입니다. 시간 로그는 10월 12일부터만 있고 단계마다 마지막 실행만 보관하므로, 플랫 칩의 24.7시간 배치, 초기 블록 실행 대부분, 그리고 실패한 모든 시도가 빠져 있습니다.
컴퓨터가 더 있으면 도움이 될 때와 아닐 때
메모리가 더 있었다면 가장 많은 시간을 아꼈을 것입니다. 스무 번의 시도 대부분은 속도가 아니라 메모리 문제였습니다. 64 GB 컴퓨터라면 프로세스 분할과 상한 조정과 함께 그 대부분을 피했을 것입니다.
컴퓨터가 더 있으면 독립적인 작업에 도움이 됩니다.
- 블록 아홉 개는 하나씩 차례로 배치 배선하는 데 약 20시간이 걸렸습니다. 메모리가 충분한 컴퓨터라면 나란히 돌릴 수 있습니다. i2c, aes, kmac 같은 작은 블록은 15 GB 노드에 들어가지만, otbn의 배선(19.5 GB)과 일부 피니시 단계(약 22 GB)는 들어가지 않습니다.
- 레벨 2 플로어플랜 검사 네 개(3편)는 각각 약 한 시간이 걸렸고 최대 20 GB 가까이 썼습니다. 충분히 큰 노드 네 대가 있으면 네 시간이 아니라 한 시간이면 됩니다.
- 프로브와 사인오프 실행은 작아서 어디에나 들어갑니다. 혼잡도 프로브는 Slurm 노드에서 15초 만에 돌았습니다.
컴퓨터가 더 있어도 하나의 긴 실행은 줄어들지 않습니다. 26시간짜리 상세 배선은 한 컴퓨터의 한 프로세스이고, 이미 코어를 약 9개 쓰고 있습니다. 배치는 대부분 직렬입니다. 그것들을 줄인 것은 설계였습니다. 계층 구조가 배치를 24.7시간에서 2.8시간으로 줄였고, 배선을 줄이는 것은 더 나은 플로어플랜(kmac 채널 수정)입니다.
한 화면으로 보는 시리즈
이 시리즈가 보여 준 모든 것입니다.
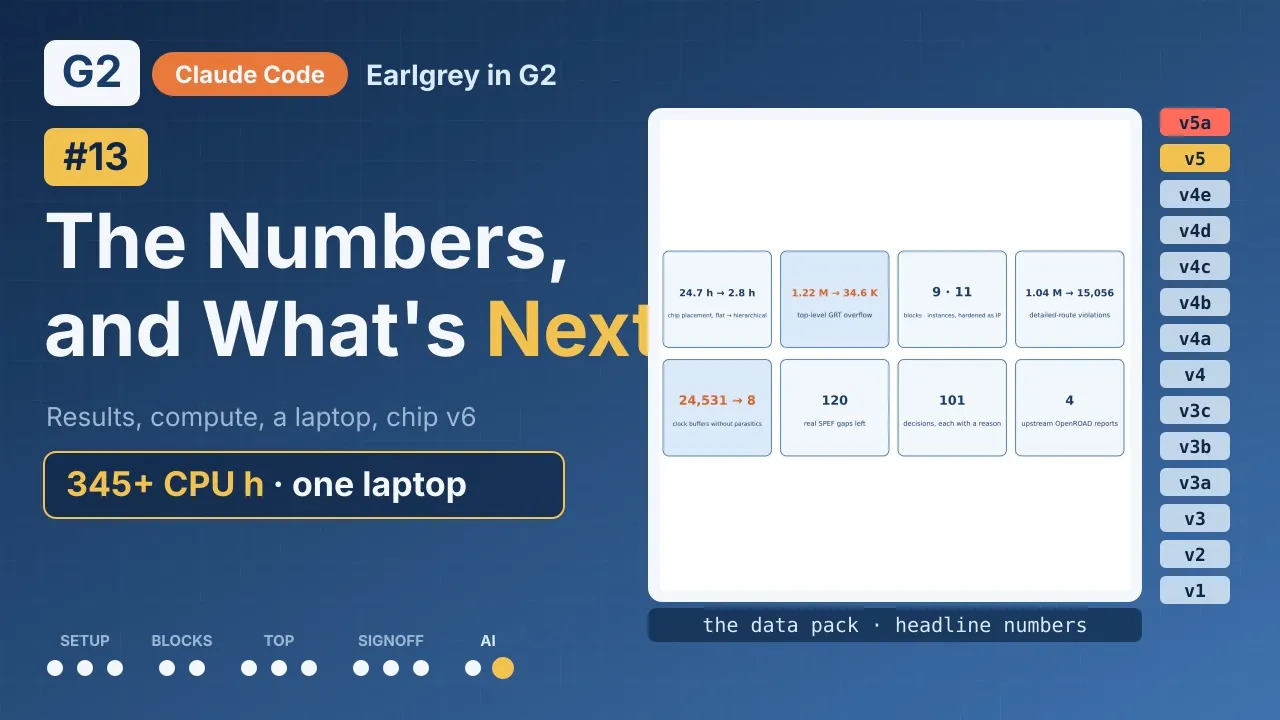 1:38
YouTube에서 보기(영어) ↗Bilibili에서 보기(중국어) ↗
여전히 테이프아웃은 아닙니다
내내 말씀드렸듯이 상위 메탈은 대체용 10층 스택이고, 메모리는 FakeRAM 모델이며, 클록은 10 MHz 시연 목표이고, 칩에는 남은 문제가 있습니다. 남은 문제는 배선 위반 15,056개, 타이밍 예외가 없는 IO 경로, 홀드 리포트 없음, 그리고 패드 링의 VDD 끊김입니다. 칩 v5는 또한 두 가지 OpenROAD 빌드와 패치된 데이터베이스를 섞어서 썼습니다.
다음 칩 버전 v6에서 그 빈틈을 메웁니다.
- 패드 층으로의 전원 그리드 연결, VDD와 VSS 모두 검사.
- kmac 채널을 다시 설계하고, 배선 전에 최악 창 규칙으로 확인.
- IO 경로의 타이밍 예외.
- 사인오프의 홀드 리포트.
- 실행 전체에 OpenROAD 빌드 하나, 패치 없음.
찾아볼 곳
- G2: GitHub의 무료 Community Edition
- 동영상: "Earlgrey in G2" 13편, YouTube와 Bilibili
- OpenROAD 수정: 이슈 #11839와 #11840, 풀 리퀘스트 #11841과 #11842
오픈소스 도구로 백만 셀 SoC를 RTL부터 사인오프 타이밍까지 진행할 수 있습니다. 모든 것을 추적하는 흐름 관리 도구, 그 규칙 안에서 일하는 에이전트, 그리고 결정을 내리는 엔지니어가 있으면, 노트북 한 대로 운영하고, 설명하고, 반복할 수 있는 프로젝트가 됩니다.