
オープンソースのチップ設計ツールは、たいてい小さな設計で紹介されます。GCD ブロック、UART、小さな RISC-V コアなどです。こうしたデモでツールが動くことはわかります。しかし、実際のシステムオンチップの規模でプロジェクトを回すために何が必要かはわかりません。数十のブロック、丸一日かかる実行、失敗した試行、ツールと人のあいだを行き来する設計データ、そして 1 週間後にも誰かが説明できなければならない判断です。
その後半こそ、私たちのフローマネージャーである G2 が担う部分です。本物で試すために、本物の SoC を使いました。
OpenTitan Earlgrey は、オープンでセキュリティグレードの RISC-V SoC です。SkyWater 130 nm で約 113 万個のスタンダードセル、23 個のメモリ、70 本の信号パッド、暗号エンジン、CPU コア、多倍長演算アクセラレーターを持ちます。私たちはこれを RTL から、配線と寄生抽出まで終えたチップへ進め、サインオフ相当の静的タイミング解析まで行いました。使ったのはオープンソースの EDA ツール(Yosys、OpenROAD、OpenRCX、OpenSTA)だけです。すべての実行、入力、判断は G2 を通り、Anthropic の AI コーディングエージェント Claude Code が、G2 のルールの中で実作業の多くを担いました。
この第 1 回では、全体の流れを一か所にまとめます。シリーズの残りの回で、それぞれの部分を掘り下げます。
 2:27
YouTube で見る(英語) ↗Bilibili で見る(中国語) ↗
 3:22
YouTube で見る(英語) ↗Bilibili で見る(中国語) ↗
たどり着いたところ
5 つのステップで見る全体像
- フラットは壁にぶつかる。 40 個のブロックはすべて Yosys と yosys-slang で問題なく論理合成できました。ところがフラットなチップの配置には 24.7 時間かかり、そのうち 22.5 時間はシングルスレッドのタイミング修正でした。結果はチップ全体が混雑し、reg2reg のセットアップスラックは −164 ns。配線できる見込みはありませんでした。
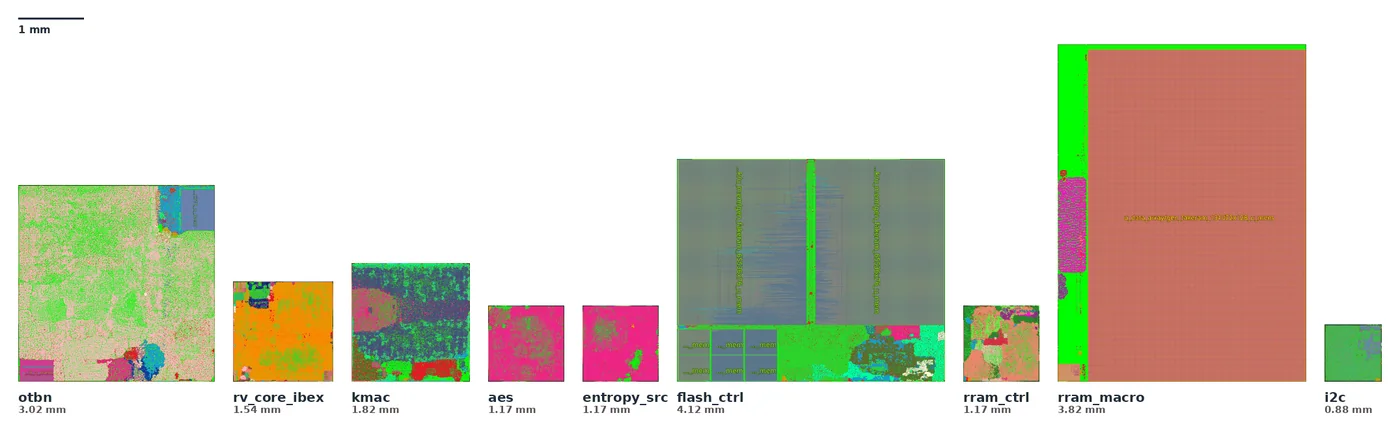
- チップチームと同じやり方で階層化する。 9 個のブロックをボトムアップでハード化しました。otbn、Ibex コア、kmac、aes、entropy_src、フラッシュと RRAM のコントローラー、RRAM アレイ、そして i2c(3 回使用)です。各ブロックは G2 でフロアプラン、配置、CTS、配線を通り、チップのクロックで再タイミングされ、IP になりました。abstract LEF、2 コーナーのタイミングモデル、ブラックボックスのスタブを、G2 のライブラリマネージャーに登録したものです。そのうえでトップレベルの論理合成と OpenROAD は、それらをハードマクロとして使いました。階層化した配置は 24.7 時間ではなく 2.8 時間で終わりました。
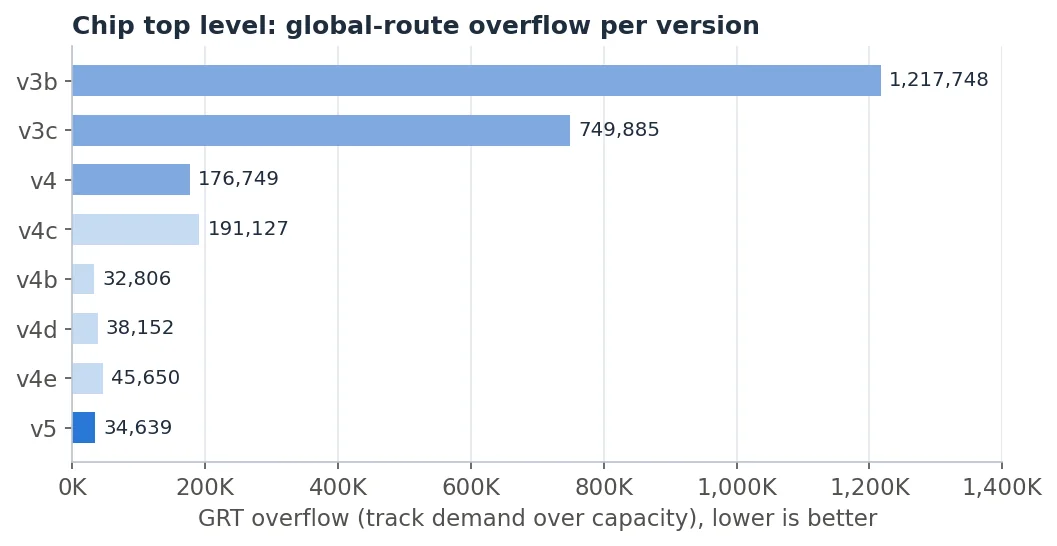
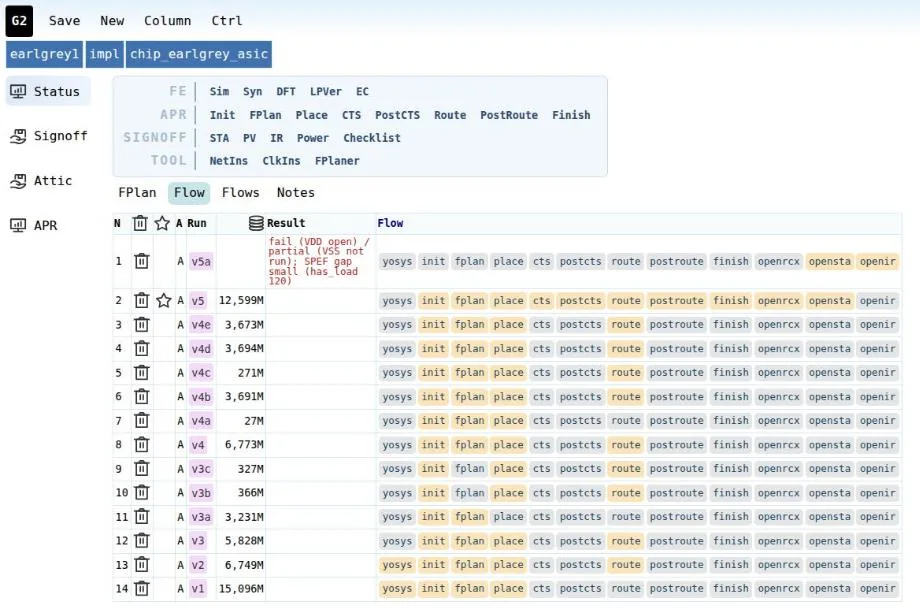
- データからトップレベルを配線可能にする。 トップレベル最初のグローバル配線では、オーバーフローしたトラックが 122 万本ありました。GRT の derate を下げ、ダイを大きくすると改善しましたが(v4 で 176,749)、十分ではありません。そこで推測ではなく、オーバーフローの発生源をたどりました(87% は 2 つのブロックの上。最大の単一要因は、キーマネージャーのロジックが 1 本のチャネルに詰め込まれていたこと)。ブロック配置の簡単な what-if モデルを作り、候補を短いグローバル配置の実行で確かめ、そのあとで初めて本番を流しました。バージョン v5 は 34,639 に落ち着き、最大のブロックがまだ配線できた水準に近づきました。
- 別ツールでのサインオフタイミングが、OpenROAD のバグを 2 件見つけた。 業界と同じく、サインオフでは配置配線ツール自身のタイミングを信用しませんでした。OpenRCX で寄生成分を抽出し、書き出したネットリストと SPEF に対してスタンドアロンの OpenSTA を実行しました。そこで、階層フローでしか現れないバグが 2 つ見つかりました。
write_spefが、CTS がサブモジュール内に作ったオブジェクトのモジュールパスを落としていたこと。そして CTS がダミー負荷を間違ったモジュールに置き、ネットリストの 13,566 本のクロックネットを分断していたことです。どちらも原因をソースまでたどり、回帰テストとともに修正し、チップで検証して、アップストリームに送りました(OpenROAD の issue #11839/#11840、PR #11841/#11842。現在レビュー待ち)。 - 自分たちの作業を検証する。 ツールのアップグレード後、最終チップに 2 つのチェックを実行しました。電源グリッドのチェックで、コア電源がパッドリングにつながっていないことがわかりました。それまで隠れていた、本物の PDN のミスです。寄生成分のプローブでは、SPEF データのない 73,824 個のドライバーのうち、実際に何かを駆動しているのは 120 個だけだとわかりました。悪い知らせが 1 つ、良い知らせが 1 つ。どちらも記録に残っています。
G2 が管理できる状態に保ったしくみ
これを一度だけ手作業でやることはできても、もう一度やったり、あとから説明したりはできません。違いを生んだのは 5 つのことでした。
- 変更した実行ごとに新しいバージョン。 チップは 14 のバージョン(v1 から v5a)を経ました。何も上書きしていないので、このシリーズのどの数値も、それを出した実行までたどれます。
- 設計データと IP を管理されたオブジェクトとして扱う。 RTL、ネットリスト、SDC、配置配線の各ステージは、G2 の設計データマネージャーでバージョン管理・公開されます。ハード化したブロックはライブラリマネージャーのエントリーであり、ディレクトリ間でコピーするファイルではありません。
- 書き残した判断ログ。 自明でない選択にはすべて 1 行を残しました。何を、いつ、なぜ決めたか。7 日間で 101 件が記録されました。
- そのルールの中で働く Claude Code。 無人の一夜で、最大ブロックの配線失敗 4 件を診断して直し、7 ブロックのハードマクロ用ビューを生成し、16 件の判断を理由とともに記録しました。間違いもしました。SPEF のバグでは最初に別のツールのせいにし、エンジニアが「その書き出し処理が正しくできているのは何か」と問いかけたことで本当の原因にたどり着きました。この協業のしくみは、あとで改めて取り上げます。
- 厳しい制限。 EDA ジョブは一度に 1 つ、10 スレッド、ジョブあたり 22 GB のメモリ上限。この規模では、何を実行できるかを決めるのは CPU ではなくメモリです。
これは何ではないか
それでも主な結果は変わりません。オープンなツール、AI エージェント、そしてすべてを追跡するフローマネージャーがあれば、100 万セル規模の SoC は、実際に回し、説明し、繰り返せるプロジェクトになります。しかもノートパソコンで動きました。チップの配置配線は、Intel Core Ultra 7 155H(22 スレッド)と 30 GB の RAM を積んだ 1 台のマシンで実行し、軽いジョブには Slurm 上の小さなマシンを数台使いました。難しいのは規模、メモリ、そして複数のツールに 1 つの設計で合意させることです。シリーズの残りの回は、まさにその部分を扱います。