
第 2 回から第 4 回まではチップの話でした。この回は、作業がどう進んだかについてです。このプロジェクトの実作業の多くは、Anthropic の AI コーディングエージェント Claude Code が、G2 の中で 1 人のエンジニアと並んで行いました。うまくいかなかったところも含めて、そのしくみを紹介します。
2 つの役割
分担はシンプルでした。
| Claude Code | エンジニア |
|---|---|
| G2 自身のコマンドでフローを実行 | 目標と制限を決める |
| ログとレポートを読む | 判断を下す:A 案か B 案か、どのフロアプランか、「それでも終える」か |
| 失敗を診断する | 方向を変える問いを投げる |
| スクリプト、修正、記録を書く | 公開するものはすべて承認する |
簡単に言えば、エージェントが手を、エンジニアが判断を提供しました。
最初から重要だったルールが 1 つあります。フローのすべてのステップは G2 の API を通すことです。WebUI のボタンが呼ぶのと同じ sd -e コマンドです。エージェントは場当たり的なシェルスクリプトからツールを実行しませんでした。必要なステップに API がなければ、それは回避するのではなく、報告して作るべき欠けた部分でした。これによって、すべての実行がエンジニアの見える G2 の記録に残りました。
 2:11
YouTube で見る(英語) ↗Bilibili で見る(中国語) ↗
無人の一夜
10 月 13 日 21:40、エンジニアは約 10 時間を、1 つの指示とともに任せました。できるところまで進め、本当の判断が必要なときだけ止まること。翌朝 07:00 までに:
- otbn v5 の配線が通りました。 4 回の配線失敗を、1 つずつ診断して直しました(その話は第 2 回にあります)。
- 7 個のブロックがポストルートとフィニッシュを通り、IP 用のビュー(abstract LEF、タイミングモデル、ブラックボックスのスタブ)が生成されました。
- i2c を最初に: 新しいフィニッシュのスクリプトは、高価なブロックの前に、いちばん安いブロックで試しました。
- チップ v2 のスクリプトを準備: 電源グリッドとフロアプランです。
- 16 件の判断を記録しました。 それぞれに理由が付いています。
判断ログ
自明でない選択にはすべて、4 つの部分からなるエントリーを残しました。時刻、何を決めたか、なぜか、タグです。その夜の例を 2 つ挙げます。再タイミングを別のスクリプトではなく G2 のステージにまとめること、そして新しいスクリプトをいちばん安いブロックで先に試すこと。各エントリーは短く、役に立つのは「なぜ」の行です。
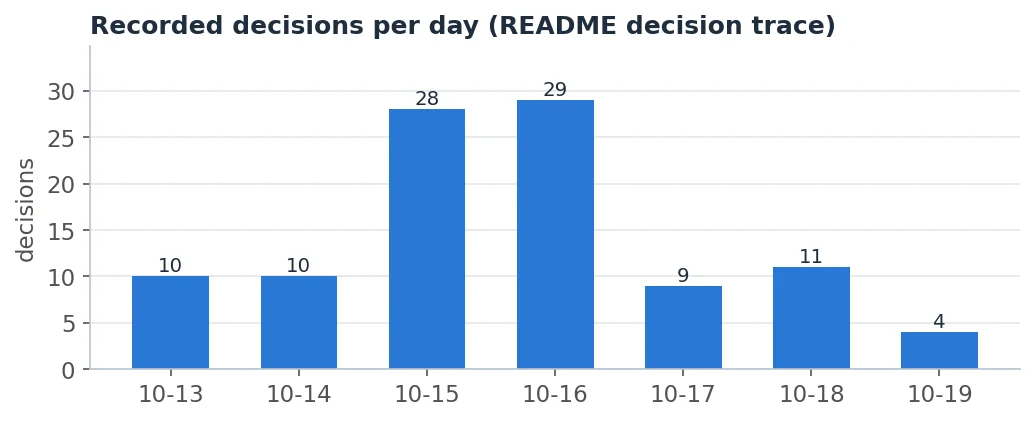
7 日間(10 月 13 日〜19 日)で、判断ログには 101 件のエントリーが集まりました。エンジニアはログから再構成する代わりに、翌朝その夜の全体を数分で確認できました。
間違いがルールになった
エージェントは間違いをしました。どれも何かの損失を生み、どれも書き残されたルールになりました。
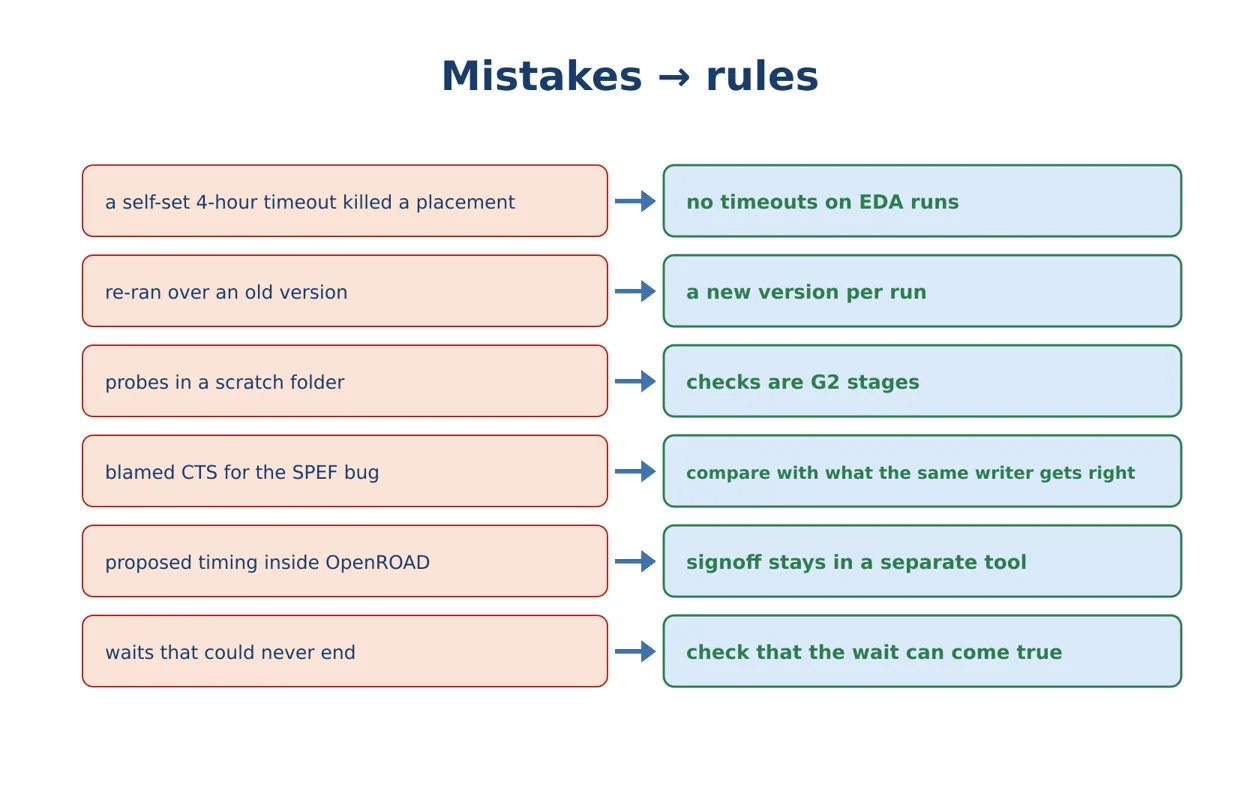
| 起きたこと | ルール |
|---|---|
| エージェント自身が設定した 4 時間のタイムアウトが、配置の実行を出力なしで止めた。 | 長い EDA 実行にタイムアウトを付けない。 |
| 既存のバージョンの上でブロックを再実行し、最初の結果を上書きした。 | 実行ごとに新しいバージョン。 |
| プローブをプロジェクトの外のスクラッチフォルダーに置いた。 | チェックは G2 のステージにし、テストバージョンに README 付きで置く。 |
| SPEF のバグをクロックツリーツールのせいにした。 | 同じコードが正しくできていることと比べる。 |
| チップのタイミングを OpenROAD の中で解析しようと提案した。 | サインオフは別ツールで行う。 |
| 決して成り立たない条件を待ち続けた。エンジニアは「なぜ待っているの?」と 3 回聞いた。 | 待ちが終わり得るかを確かめ、タイムアウトには報告させる。 |
SPEF の件は、この協業をいちばんよく表す例です。エージェントの最初の仮説はもっともらしく、証拠としてバッファを 1 つたどっていました。エンジニアはその証拠に反論しませんでした。代わりに、より良い問いを投げました。同じファイルはこのモジュールの論理合成済みのネットを正しく書いている。では、ここで何が違うのか。それで探す対象がクロックツリーツールから SPEF の書き出し処理に移り、そこにバグがありました(第 4 回)。
AI エンジン向けに書き残したルール
ルールはプレーンテキストのガイドにまとめてあり、次のエージェントは G2 のプロジェクトに触れる前にそれを読みます。黄金律は 10 個です。
- すべてのステップに G2 の API を使う。
- 実行ごとに新しいバージョン。
- チェックは G2 のステージ。
- テストケースを作る前に確認する。
- 公開するものは事前に確認する。
- EDA ジョブは一度に 1 つ、最大 10 スレッド。
- 長い実行にタイムアウトを付けない。
- サインオフタイミングはスタンドアロンの OpenSTA で。
- タイミング解析は G2 のタイミングパスデータから。
- デモの実行はクロージャーではない:残りを書き留めて先に進む。
このうちいくつかは、どのチップチームでも思い当たるエンジニアリングの慣習です。「公開するものは事前に確認する」「待ちが終わり得るかを確かめる」などは、エージェントと働くことに特有のものです。ルール 5 はアップストリームへのバグ報告にも適用されました。issue と pull request はエージェントが準備し、エンジニアが了承するまで何も投稿しませんでした。
G2 でうまくいく理由
10 時間無人で動くエージェントは、人がすばやく確認でき、信頼できる成果を残さなければなりません。その大部分は G2 の構造が担います。
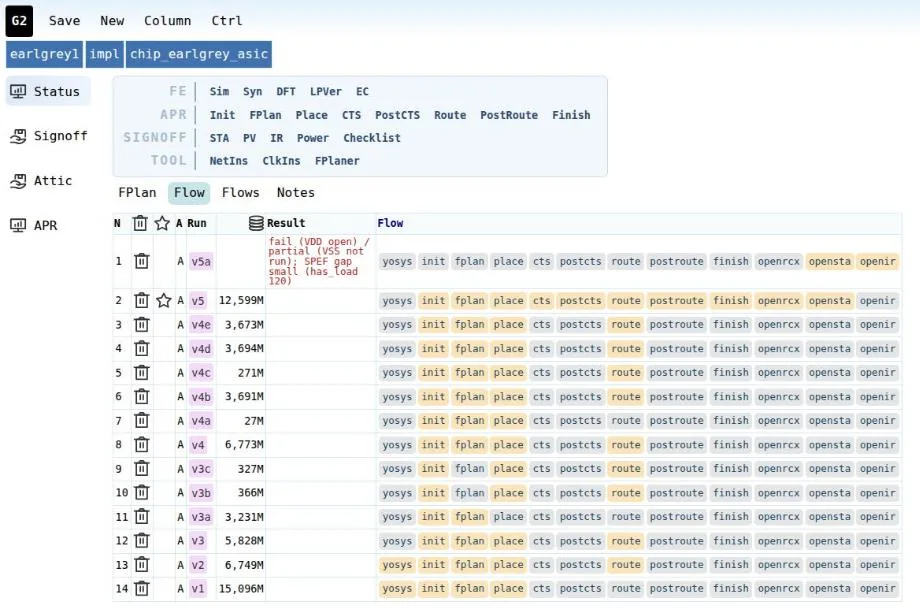
- すべての実行がバージョン。 エージェントが何をしても結果は上書きされないので、悪い実行で失うのは時間であってデータではありません。
- すべてのステップがステージ で、ログ、QoR サマリー、README を持ちます。エージェントは実行の最後に README を書きます。目的、結果、次のステップです。
- 判断は書き残される。 判断ログに、時刻、何を、なぜ。
- 1 組のページ。 エンジニアは、エージェントが書き込むのと同じ WebUI のページを確認します。信用するかどうかを考えなければならない別のレポートはありません。
他のチームに伝えたいこと
- 間違いが安くすむ構造をエージェントに与える:バージョン、ステージ、そして理由を書き残す場所。
- 間違いはどれも、次のセッションが読む書かれたルールにする。会話の中だけでの訂正は残りません。
- 結果を伴う判断と、公開するものはすべて、人の手に残す。
- 判断ログを読む。見ていなかった作業を確認するいちばん速い方法です。
次は最終回です。100 万セルのチップが 1 台のノートパソコンでどれだけのメモリと実行時間を使うか、そしてマシンを増やすとどこで役に立つかを見ます。