
開源晶片工具通常只在小設計上展示:一個 GCD 模組、一個 UART、一顆小的 RISC-V 核心。這些 demo 證明工具能用,卻沒有說明要在真實系統晶片的規模上跑一個專案需要什麼:幾十個模組、一跑就是一天的執行、失敗的嘗試、在工具和人之間流動的設計資料,以及一週之後還得有人講得清楚的決定。
後面這一部分,正是我們的流程管理器 G2 要解決的。為了在真實的東西上測試它,我們找來一顆真實的 SoC。
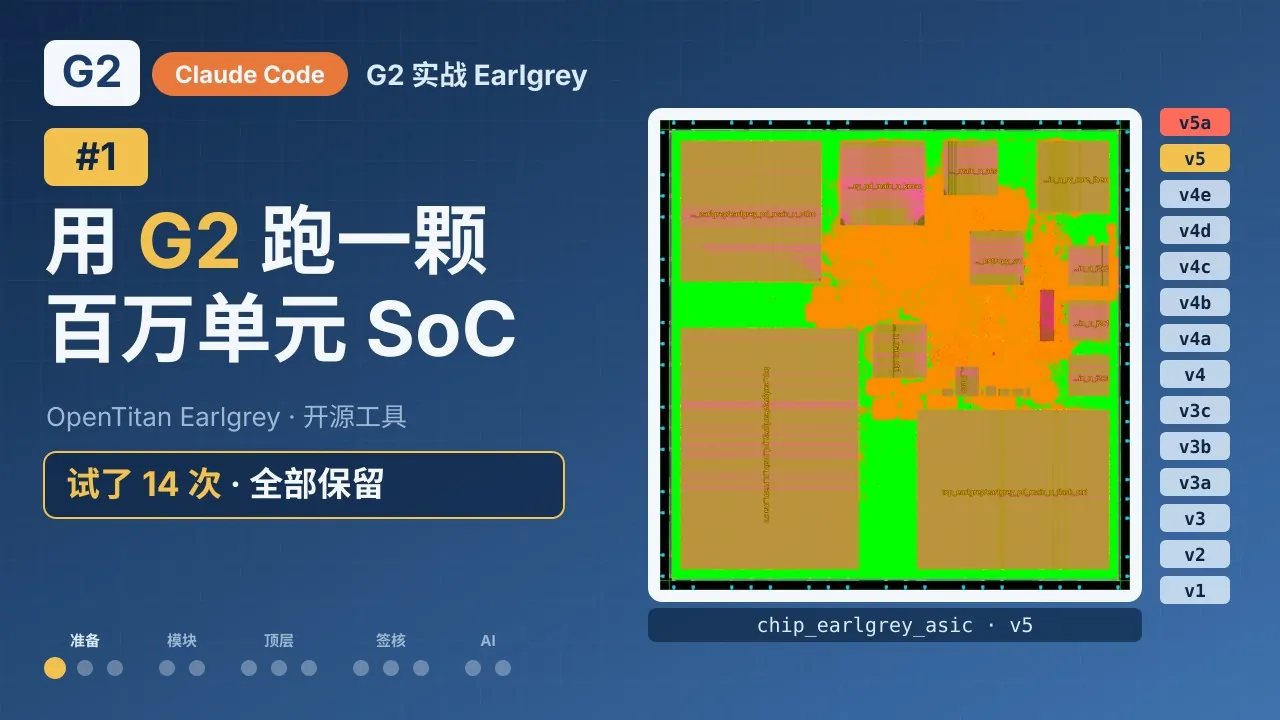
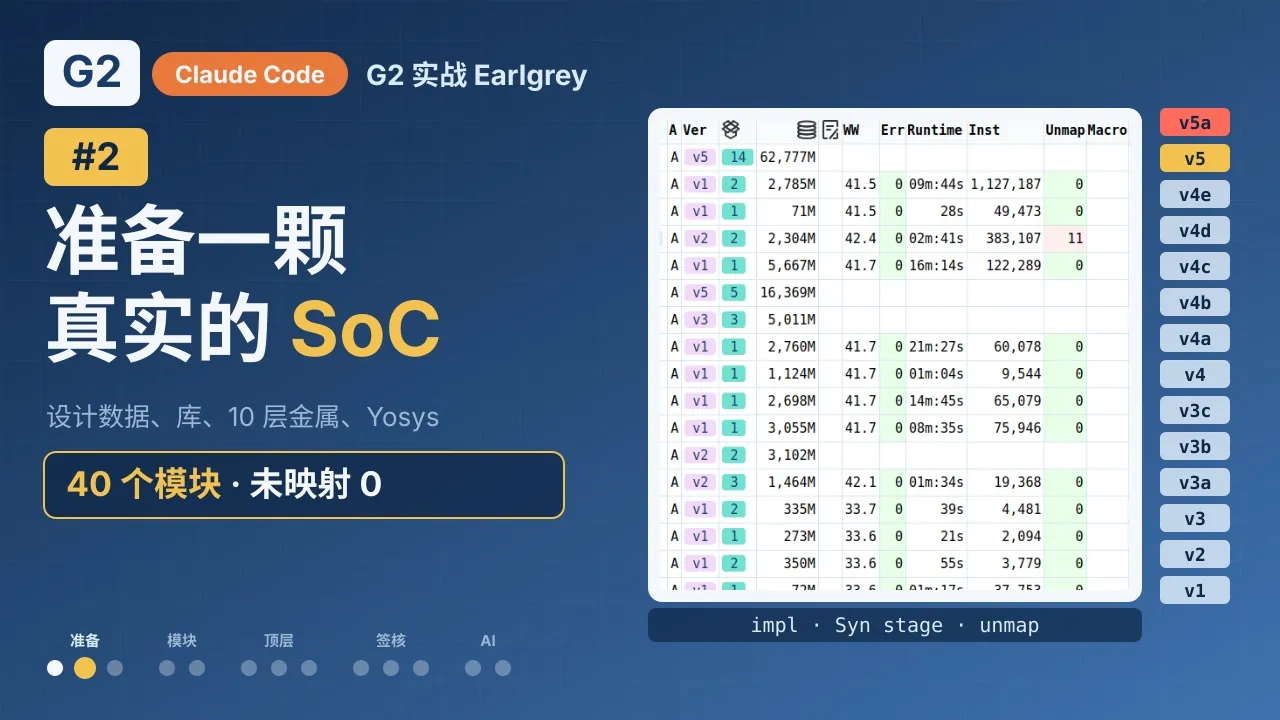
OpenTitan Earlgrey 是一顆開源、安全級的 RISC-V SoC:在 SkyWater 130 nm 上大約 113 萬個標準單元,23 塊記憶體、70 個訊號 pad、幾個加密引擎、一個 CPU 核心和一個大數加速器。我們只用開源 EDA 工具(Yosys、OpenROAD、OpenRCX、OpenSTA),把它從 RTL 做到一顆完成繞線、提取了寄生參數、並做了簽核式靜態時序分析的晶片。每一次執行、每一個輸入和每一個決定都經過 G2,而 Anthropic 的 AI 程式設計助手 Claude Code 在 G2 的規則之內完成了大部分動手的工作。
這第一篇把整個過程放在一起。系列的其餘幾篇再逐一深入。
 2:32
在 YouTube 觀看(英文) ↗在 Bilibili 觀看(中文) ↗
 3:13
在 YouTube 觀看(英文) ↗在 Bilibili 觀看(中文) ↗
最後的結果
五個步驟
- 扁平碰壁。 全部 40 個模組都用 Yosys 和 yosys-slang 乾淨地完成合成。接著扁平晶片的佈局花了 24.7 小時,其中 22.5 小時是單執行緒的時序修復,結果到處都擁擠,reg2reg setup slack 是 −164 ns。它不可能繞得通。
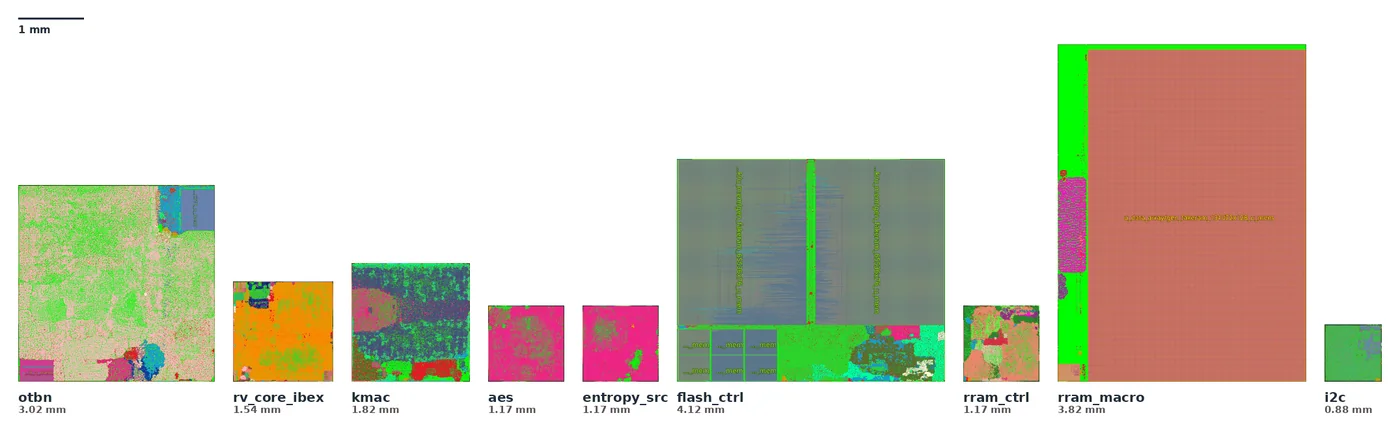
- 層次化,就像晶片團隊的做法。 我們由下而上硬化了九個模組:otbn、Ibex 核心、kmac、aes、entropy_src、flash 和 RRAM 控制器、RRAM 陣列,以及 i2c(用了三次)。每個模組都在 G2 裡走過 floorplan、佈局、CTS 和繞線,用晶片時脈重新分析時序,再變成 IP:抽象 LEF、兩個 corner 的時序模型和一個 black box stub,登記在 G2 的元件庫管理裡。頂層合成和 OpenROAD 再把它們當作硬 macro 使用。層次化的佈局只花了 2.8 小時,而不是 24.7 小時。
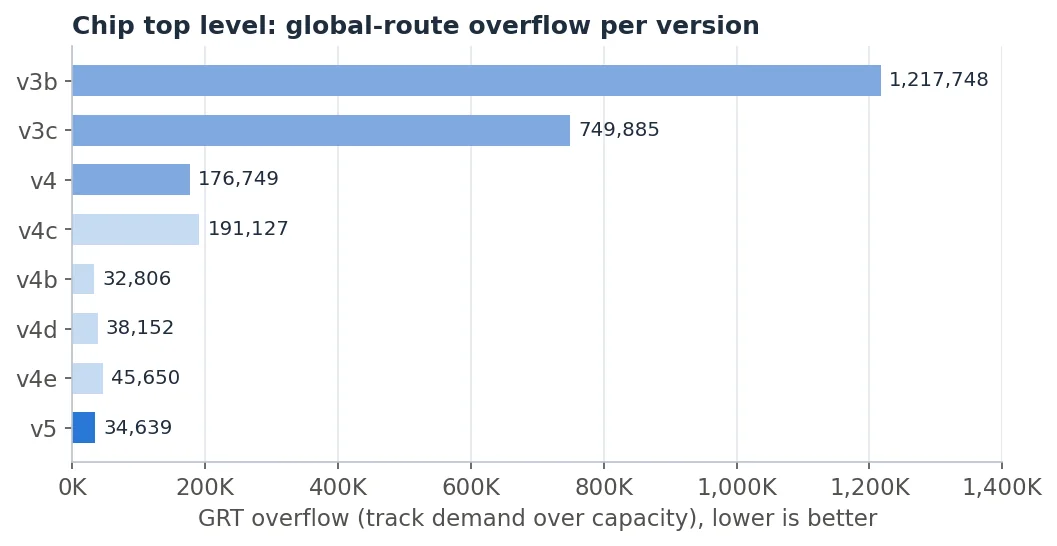
- 靠數據讓頂層繞得通。 頂層第一次全域繞線顯示有 122 萬條走線溢位。調低一個 GRT 降額、加大 die 有幫助(v4 是 176,749),但還不夠。我們沒有用猜的,而是追查溢位從哪裡來(87% 在兩個模組上方;最大的單一原因是金鑰管理器的邏輯擠在一條通道裡),做了一個模組擺放的快速假設分析模型,用很短的全域佈局執行檢查候選方案,最後才跑真正的流程。版本 v5 落在 34,639,接近最大模組還能繞通的程度。
- 在獨立工具裡做簽核時序,找到兩個 OpenROAD 的 bug。 和業界一樣,我們不拿佈局繞線工具自己的時序當簽核。我們用 OpenRCX 提取寄生參數,再用獨立的 OpenSTA 讀取寫出來的網表和 SPEF。這揭露了兩個只在層次化流程裡才出現的 bug:
write_spef丟掉了 CTS 在子模組裡建立的物件的模組路徑;CTS 把 dummy load 放錯了模組,讓網表裡 13,566 條時脈 net 被拆開。我們把兩個 bug 都追到原始碼,加上迴歸測試修好,在晶片上驗證,並提交到上游(OpenROAD issue #11839/#11840、PR #11841/#11842,仍在審查中)。 - 檢查我們自己的工作。 工具升級之後,我們對最終的晶片做了兩項檢查。電源網路檢查發現核心電源沒有連到 pad 環,這是一個一直藏到那時的真正 PDN 錯誤。寄生參數探測則顯示,73,824 個沒有 SPEF 資料的驅動端裡,只有 120 個真的驅動著東西。一個是壞消息,一個是好消息,兩個都已經記錄下來。
G2 怎麼讓它保持可控
手動做一次是可能的;再做一次,或事後把它講清楚,就不可能了。有五件事起了關鍵作用:
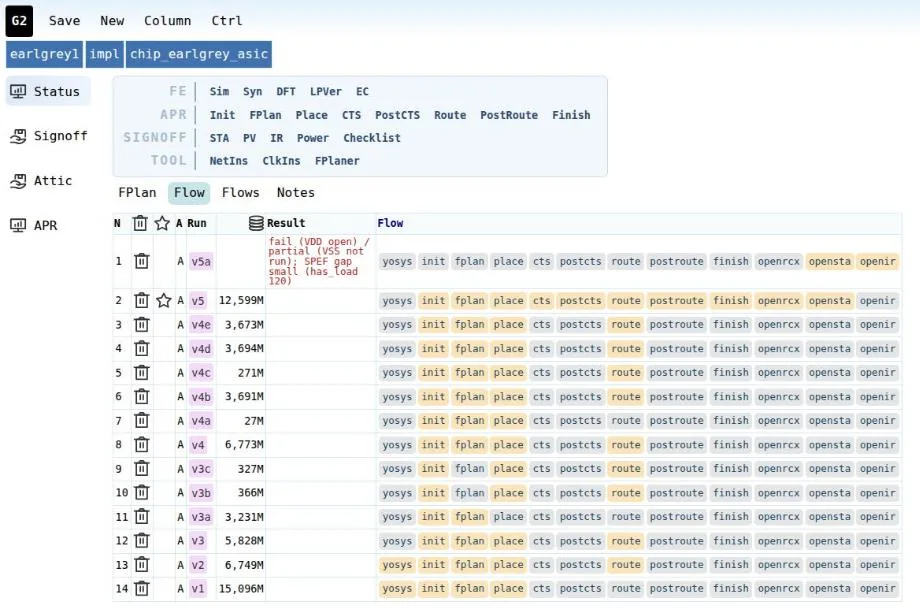
- 每次改動的執行都建一個新版本。 晶片一共有 14 個版本(v1 到 v5a)。沒有任何東西被覆蓋,所以這個系列裡的每個數字都能追溯到產生它的那次執行。
- 設計資料和 IP 都是被管理的物件。 RTL、網表、SDC 和佈局繞線的每個階段,都在 G2 的設計資料管理器裡有版本並發布;硬化好的模組是元件庫管理裡的條目,而不是在目錄之間複製來複製去的檔案。
- 書面的決策記錄。 每個不顯而易見的選擇都有一行:決定了什麼、什麼時候、為什麼。七天裡一共記了一百零一條。
- Claude Code 在這些規則裡工作。 在無人值守的一個晚上,它診斷並修好了最大模組的四次繞線失敗,生成了七個模組的硬 macro 視圖,並記下十六個附上原因的決定。它也犯了錯。在 SPEF 的 bug 裡,它一開始怪錯了工具;是工程師問寫檔案的程式哪裡寫對了,才找到真正的原因。後面會再談這種合作是怎麼進行的。
- 硬性限制。 一次一個 EDA 任務、10 個執行緒、每個任務 22 GB 記憶體上限。在這個規模下,決定什麼能跑的是記憶體,不是 CPU。
這不是什麼
這些都不改變主要的結果:有了開源工具、一個 AI 助手,以及一個記錄一切的流程管理器,一顆百萬單元的 SoC 就是一個真的能跑、能講清楚、能重複的專案。而且它是在一台筆電上跑的:晶片的佈局繞線在一台 Intel Core Ultra 7 155H(22 個執行緒)、30 GB 記憶體的機器上完成,另外幾台小機器在 Slurm 上跑比較輕的任務。難的地方在於規模、記憶體,以及讓幾個工具對同一個設計取得一致,而這正是這個系列其餘幾篇要講的。