
开源芯片工具通常只在小设计上展示:一个 GCD 模块、一个 UART、一颗小的 RISC-V 核心。这些 demo 证明工具能用,却没有说明要在真实系统芯片的规模上跑一个项目需要什么:几十个模块、一跑就是一天的运行、失败的尝试、在工具和人之间流动的设计数据,以及一周之后还得有人讲得清楚的决定。
后面这一部分,正是我们的流程管理器 G2 要解决的。为了在真实的东西上测试它,我们找来一颗真实的 SoC。
OpenTitan Earlgrey 是一颗开源、安全级的 RISC-V SoC:在 SkyWater 130 nm 上大约 113 万个标准单元,23 块存储器、70 个信号 pad、几个加密引擎、一个 CPU 核心和一个大数加速器。我们只用开源 EDA 工具(Yosys、OpenROAD、OpenRCX、OpenSTA),把它从 RTL 做到一颗完成绕线、提取了寄生参数、并做了签核式静态时序分析的芯片。每一次运行、每一个输入和每一个决定都经过 G2,而 Anthropic 的 AI 编程助手 Claude Code 在 G2 的规则之内完成了大部分动手的工作。
这第一篇把整个过程放在一起。系列的其余几篇再逐一深入。
 2:32
在 YouTube 观看(英文) ↗在 Bilibili 观看(中文) ↗
 3:13
在 YouTube 观看(英文) ↗在 Bilibili 观看(中文) ↗
最后的结果
五个步骤
- 扁平碰壁。 全部 40 个模块都用 Yosys 和 yosys-slang 干净地完成综合。接着扁平芯片的布局花了 24.7 小时,其中 22.5 小时是单线程的时序修复,结果到处都拥挤,reg2reg setup slack 是 −164 ns。它不可能绕得通。
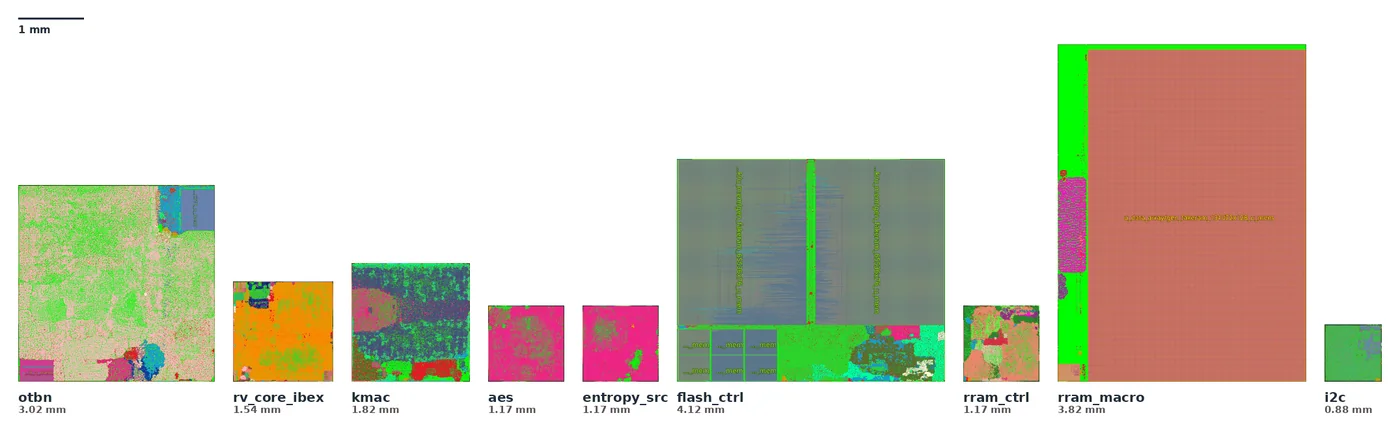
- 层次化,就像芯片团队的做法。 我们由下而上硬化了九个模块:otbn、Ibex 核心、kmac、aes、entropy_src、flash 和 RRAM 控制器、RRAM 阵列,以及 i2c(用了三次)。每个模块都在 G2 里走过 floorplan、布局、CTS 和绕线,用芯片时钟重新分析时序,再变成 IP:抽象 LEF、两个 corner 的时序模型和一个 black box stub,登记在 G2 的库管理里。顶层综合和 OpenROAD 再把它们当作硬 macro 使用。层次化的布局只花了 2.8 小时,而不是 24.7 小时。
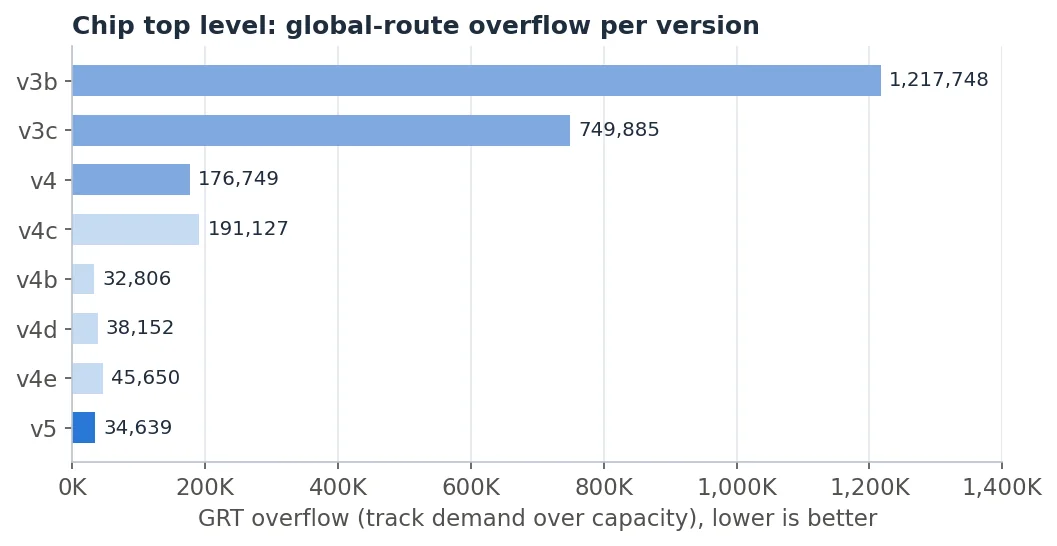
- 靠数据让顶层绕得通。 顶层第一次全局绕线显示有 122 万条走线溢出。调低一个 GRT 降额、加大 die 有帮助(v4 是 176,749),但还不够。我们没有用猜的,而是追查溢出从哪里来(87% 在两个模块上方;最大的单一原因是密钥管理器的逻辑挤在一条通道里),做了一个模块摆放的快速假设分析模型,用很短的全局布局运行检查候选方案,最后才跑真正的流程。版本 v5 落在 34,639,接近最大模块还能绕通的程度。
- 在独立工具里做签核时序,找到两个 OpenROAD 的 bug。 和业界一样,我们不拿布局布线工具自己的时序当签核。我们用 OpenRCX 提取寄生参数,再用独立的 OpenSTA 读取写出来的网表和 SPEF。这揭露了两个只在层次化流程里才出现的 bug:
write_spef丢掉了 CTS 在子模块里建立的对象的模块路径;CTS 把 dummy load 放错了模块,让网表里 13,566 条时钟 net 被拆开。我们把两个 bug 都追到源代码,加上回归测试修好,在芯片上验证,并提交到上游(OpenROAD issue #11839/#11840、PR #11841/#11842,仍在审查中)。 - 检查我们自己的工作。 工具升级之后,我们对最终的芯片做了两项检查。电源网络检查发现核心电源没有连到 pad 环,这是一个一直藏到那时的真正 PDN 错误。寄生参数探测则显示,73,824 个没有 SPEF 数据的驱动端里,只有 120 个真的驱动着东西。一个是坏消息,一个是好消息,两个都已经记录下来。
G2 怎么让它保持可控
手动做一次是可能的;再做一次,或事后把它讲清楚,就不可能了。有五件事起了关键作用:
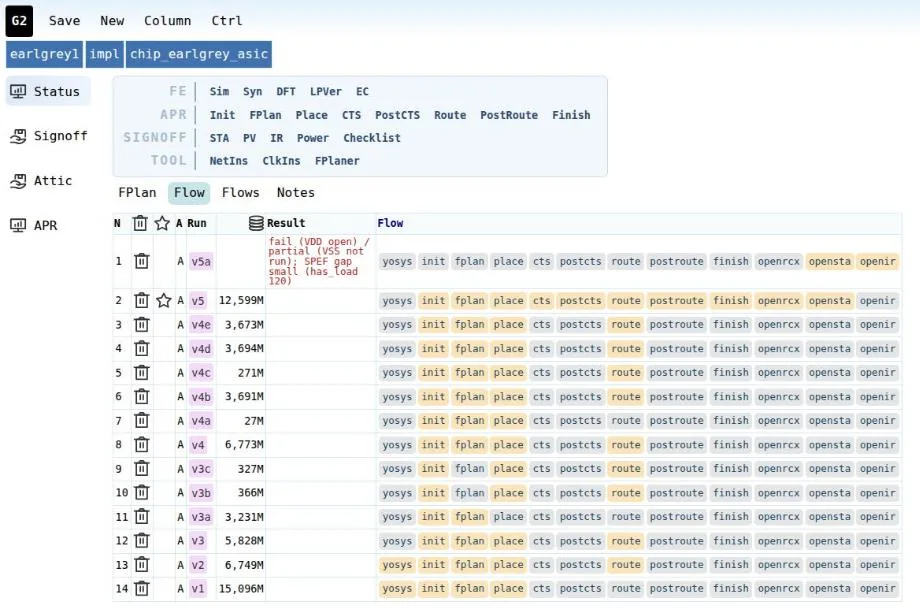
- 每次改动的运行都建一个新版本。 芯片一共有 14 个版本(v1 到 v5a)。没有任何东西被覆盖,所以这个系列里的每个数字都能追溯到产生它的那次运行。
- 设计数据和 IP 都是被管理的对象。 RTL、网表、SDC 和布局布线的每个阶段,都在 G2 的设计数据管理器里有版本并发布;硬化好的模块是库管理里的条目,而不是在目录之间复制来复制去的文件。
- 书面的决策记录。 每个不显而易见的选择都有一行:决定了什么、什么时候、为什么。七天里一共记了一百零一条。
- Claude Code 在这些规则里工作。 在无人值守的一个晚上,它诊断并修好了最大模块的四次绕线失败,生成了七个模块的硬 macro 视图,并记下十六个附上原因的决定。它也犯了错。在 SPEF 的 bug 里,它一开始怪错了工具;是工程师问写文件的程序哪里写对了,才找到真正的原因。后面会再谈这种合作是怎么进行的。
- 硬性限制。 一次一个 EDA 任务、10 个线程、每个任务 22 GB 内存上限。在这个规模下,决定什么能跑的是内存,不是 CPU。
这不是什么
这些都不改变主要的结果:有了开源工具、一个 AI 助手,以及一个记录一切的流程管理器,一颗百万单元的 SoC 就是一个真的能跑、能讲清楚、能重复的项目。而且它是在一台笔记本上跑的:芯片的布局布线在一台 Intel Core Ultra 7 155H(22 个线程)、30 GB 内存的机器上完成,另外几台小机器在 Slurm 上跑比较轻的任务。难的地方在于规模、内存,以及让几个工具对同一个设计取得一致,而这正是这个系列其余几篇要讲的。