
오픈소스 칩 도구는 보통 작은 설계로 소개됩니다. GCD 블록, UART, 작은 RISC-V 코어 같은 것들입니다. 이런 데모는 도구가 동작한다는 것을 보여 줍니다. 하지만 실제 시스템 온 칩 규모에서 프로젝트를 운영하는 데 무엇이 필요한지는 보여 주지 않습니다. 수십 개의 블록, 하루가 걸리는 실행, 실패한 시도, 도구와 사람 사이를 오가는 설계 데이터, 그리고 일주일 뒤에도 누군가 설명할 수 있어야 하는 결정들 말입니다.
그 두 번째 부분을 위해 만든 것이 저희의 흐름 관리 도구 G2입니다. 실제 상황에서 시험하기 위해, 실제 SoC를 가져왔습니다.
OpenTitan Earlgrey는 공개된 보안 등급의 RISC-V SoC입니다. SkyWater 130 nm에서 약 113만 개의 표준 셀, 메모리 23개, 신호 패드 70개, 암호 엔진, CPU 코어, 큰 수 연산 가속기로 이루어져 있습니다. 저희는 오픈소스 EDA 도구(Yosys, OpenROAD, OpenRCX, OpenSTA)만으로 이 칩을 RTL에서 배선과 추출까지 마치고 사인오프 수준의 정적 타이밍 분석까지 진행했습니다. 모든 실행, 입력, 결정은 G2를 거쳤고, Anthropic의 AI 코딩 에이전트인 Claude Code가 G2의 규칙 안에서 실제 작업의 상당 부분을 맡았습니다.
이 첫 번째 글은 전체 흐름을 한곳에 정리합니다. 나머지 글에서 각 부분을 자세히 다룹니다.
 2:27
YouTube에서 보기(영어) ↗Bilibili에서 보기(중국어) ↗
 3:22
YouTube에서 보기(영어) ↗Bilibili에서 보기(중국어) ↗
최종 결과
다섯 단계로 본 전체 흐름
- 플랫은 벽에 부딪혔습니다. 블록 40개 모두 Yosys와 yosys-slang으로 문제없이 합성되었습니다. 그런데 플랫 칩의 배치에는 24.7시간이 걸렸고, 그중 22.5시간은 싱글 스레드 타이밍 수리였습니다. 결과는 전체가 혼잡했고 reg2reg 셋업 슬랙은 −164 ns였습니다. 배선이 될 리가 없었습니다.
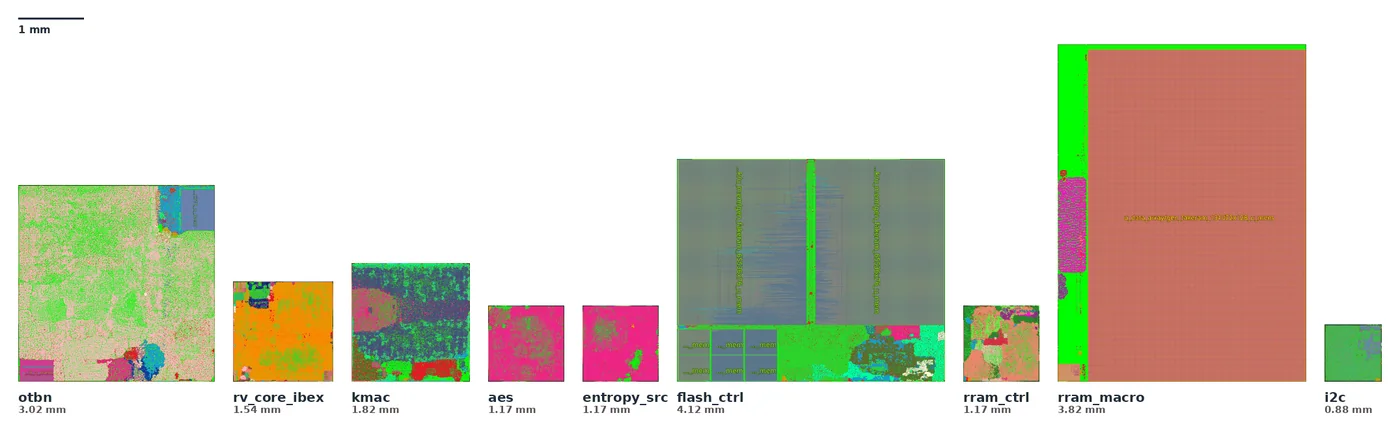
- 칩 팀이 하는 방식으로, 계층 설계. 블록 9개를 아래에서부터 하드닝했습니다. otbn, Ibex 코어, kmac, aes, entropy_src, 플래시와 RRAM 컨트롤러, RRAM 어레이, 그리고 i2c(세 번 사용)입니다. 각 블록은 G2에서 플로어플랜, 배치, CTS, 배선을 거쳤고, 칩 클록에서 타이밍을 다시 분석한 뒤 IP가 되었습니다. abstract LEF, 2코너 타이밍 모델, 블랙박스 스텁을 G2의 라이브러리 관리자에 등록했습니다. 그다음 톱 레벨 합성과 OpenROAD가 이들을 하드 매크로로 사용했습니다. 계층 배치는 24.7시간 대신 2.8시간이 걸렸습니다.
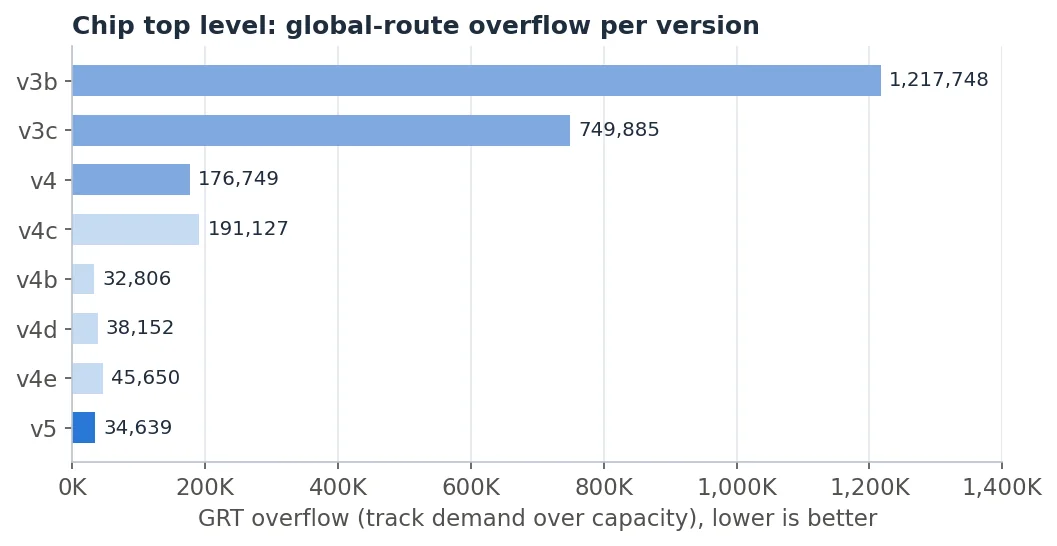
- 데이터로 톱 레벨을 배선 가능하게. 첫 번째 톱 레벨 글로벌 라우팅에서는 오버플로 트랙이 122만 개였습니다. GRT 디레이트를 낮추고 다이를 키우니 줄어들었지만(v4에서 176,749) 충분하지 않았습니다. 추측하는 대신 오버플로가 어디서 오는지 추적했습니다(87%가 두 블록 위에 있었고, 가장 큰 단일 원인은 한 채널에 몰린 키 매니저 로직이었습니다). 블록 배치를 위한 간단한 가정 모델을 만들고, 짧은 글로벌 배치 실행으로 후보를 확인한 뒤에야 실제 실행을 했습니다. v5는 34,639에 도달했고, 이는 가장 큰 블록이 그래도 배선되었던 수준에 가깝습니다.
- 별도 도구에서 한 사인오프 타이밍이 OpenROAD 버그 두 개를 찾았습니다. 업계와 마찬가지로 배치 배선 도구 자체의 타이밍을 사인오프로 믿지 않았습니다. OpenRCX로 기생 성분을 추출하고, 출력된 넷리스트와 SPEF에 대해 독립 실행 OpenSTA를 돌렸습니다. 그 결과 계층 흐름에서만 나타나는 버그 두 개가 드러났습니다.
write_spef가 CTS가 서브모듈 안에 만든 객체의 모듈 경로를 빠뜨렸고, CTS가 더미 부하를 잘못된 모듈에 넣어 넷리스트의 클록 넷 13,566개를 둘로 나눴습니다. 두 버그 모두 소스까지 추적해 회귀 테스트와 함께 고쳤고, 칩에서 검증한 뒤 업스트림에 보냈습니다(OpenROAD 이슈 #11839/#11840, PR #11841/#11842, 아직 리뷰 중). - 우리 작업을 스스로 점검. 도구를 업그레이드한 뒤 최종 칩에 두 가지 검사를 돌렸습니다. 전원 그리드 검사에서 코어 전원이 패드 링에 연결되어 있지 않다는 것을 발견했습니다. 그때까지 숨어 있던 실제 PDN 실수였습니다. 기생 성분 프로브는 SPEF 데이터가 없는 드라이버 73,824개 중 실제로 무언가를 구동하는 것은 120개뿐이라는 것을 보여 주었습니다. 하나는 나쁜 소식이고 하나는 좋은 소식이며, 둘 다 이제 기록에 남아 있습니다.
G2가 관리를 가능하게 한 방법
이 작업을 손으로 한 번 하는 것은 가능할 수 있습니다. 하지만 다시 하거나 나중에 설명하는 것은 불가능합니다. 다섯 가지가 차이를 만들었습니다.
- 실행이 바뀔 때마다 새 버전. 칩은 버전 14개(v1~v5a)를 거쳤습니다. 덮어쓴 것이 없으므로 이 시리즈의 어떤 수치든 그것을 만든 실행까지 추적할 수 있습니다.
- 관리되는 객체로서의 설계 데이터와 IP. RTL, 넷리스트, SDC, 배치 배선의 각 단계는 G2의 설계 데이터 관리자에서 버전이 관리되고 게시됩니다. 하드닝한 블록은 디렉터리 사이에 복사되는 파일이 아니라 라이브러리 관리자의 항목입니다.
- 기록된 결정 추적. 자명하지 않은 모든 선택에는 한 줄이 남았습니다. 무엇을, 언제, 왜 결정했는지입니다. 7일 동안 101건이 기록되었습니다.
- 그 규칙 안에서 일하는 Claude Code. 무인으로 진행한 하룻밤 동안 가장 큰 블록의 배선 실패 네 건을 진단하고 고쳤고, 블록 일곱 개의 하드 매크로 뷰를 생성했으며, 결정 16건을 이유와 함께 기록했습니다. 실수도 했습니다. SPEF 버그에서는 처음에 엉뚱한 도구를 탓했고, 출력기가 무엇을 제대로 하는지 묻는 엔지니어의 질문이 진짜 원인으로 이끌었습니다. 이 협업이 어떻게 이루어지는지는 뒤에서 다시 다룹니다.
- 엄격한 제한. EDA 작업은 한 번에 하나, 스레드 10개, 작업당 메모리 22 GB 상한. 이 규모에서는 CPU가 아니라 메모리가 무엇을 실행할 수 있는지를 정합니다.
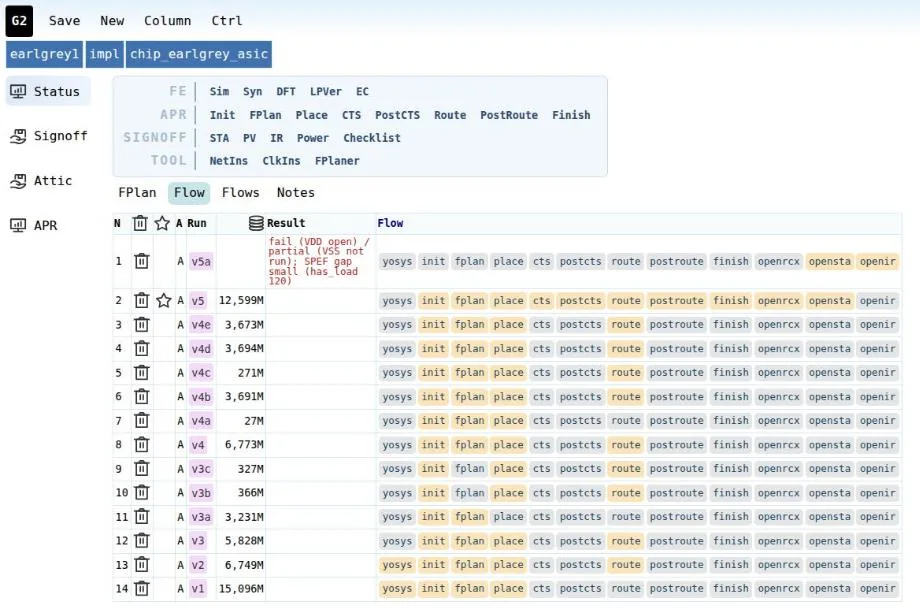
이것이 아닌 것
이 중 어느 것도 핵심 결과를 바꾸지 않습니다. 오픈 도구, AI 에이전트, 모든 것을 추적하는 흐름 관리 도구가 있으면, 백만 셀 SoC는 실제로 운영하고, 설명하고, 반복할 수 있는 프로젝트가 됩니다. 그리고 노트북 한 대에서 돌아갔습니다. 칩의 배치와 배선은 Intel Core Ultra 7 155H(22 스레드)와 30 GB RAM을 갖춘 한 대의 컴퓨터에서 실행했고, 가벼운 작업에는 Slurm의 작은 컴퓨터 몇 대를 썼습니다. 어려운 부분은 규모, 메모리, 그리고 여러 도구가 하나의 설계에 대해 같은 결론을 내게 만드는 것이며, 이 시리즈의 나머지가 바로 그 부분을 다룹니다.