
在第 1 篇裡,我們講了整個過程:OpenTitan Earlgrey,在 SkyWater 130 上大約 113 萬個標準單元,用開源工具從 RTL 做到簽核時序,由 G2 組織,Claude Code 完成大部分動手的工作。這一篇講這個故事的第一個大轉折:我們先試了扁平的晶片,行不通,於是改成晶片團隊會用的做法,由下而上。
按資料決定扁平晶片的大小
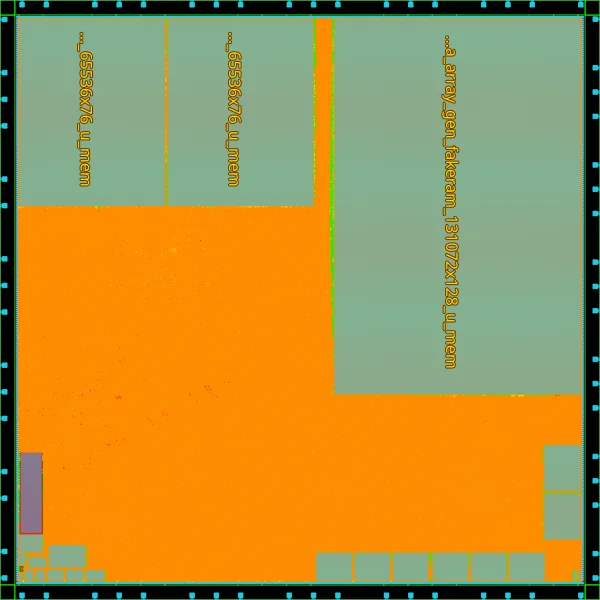
全部 40 個模組都用 Yosys 和 yosys-slang 乾淨地完成合成。佈局之前,我們先按網表決定 die 的大小:113 萬個單元加 23 塊記憶體大約需要 41 mm²,所以扁平晶片用了 8.1 mm 的 die。第一次執行之前要改一個設定:光是預設的單元間距就讓佈局面積翻倍,所以我們把它調小。
在 G2 裡,扁平晶片是版本 v1,一次 OpenROAD 簽出,每個階段一個目錄(init、floorplan、place、CTS、route 等等),每個目錄都有自己的日誌、報告、QoR 摘要和 README。
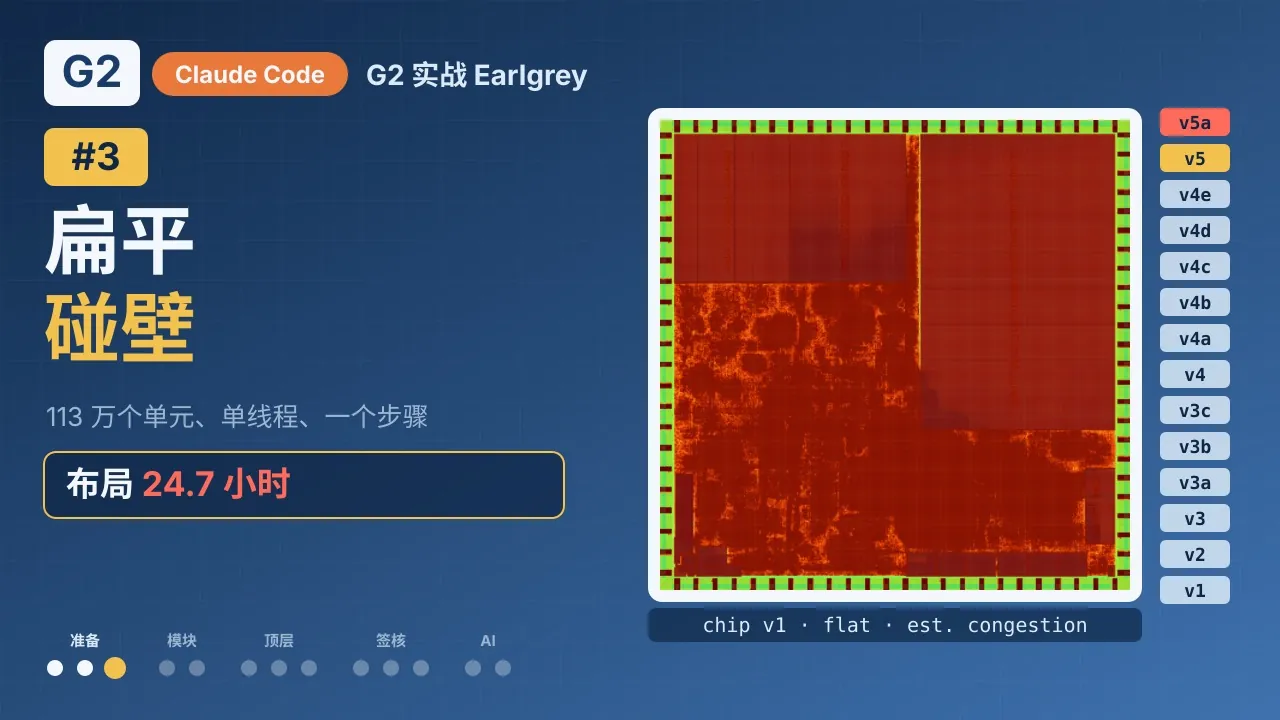 2:19
在 YouTube 觀看(英文) ↗在 Bilibili 觀看(中文) ↗
24.7 小時,幾乎全花在一個步驟上
初始化花了 7 分鐘,floorplan 花了 23 分鐘。佈局花了 24 小時 43 分鐘。
其中大約 22.5 小時是同一個步驟:repair_design,它用調整單元大小和插入 buffer 的方式修正 slew、電容和扇出。它要走過晶片裡的每一個驅動端,而且只用單執行緒。到最後,它的進度表要將近一小時才前進一行。總共插入了大約 76,000 個 buffer。
結果沒辦法用:
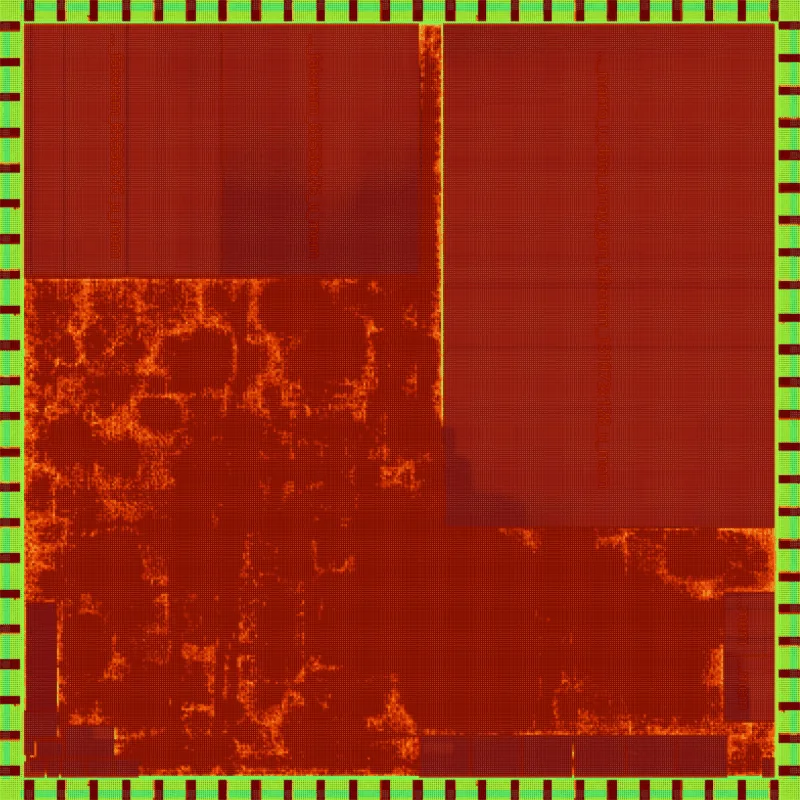
- 到處都擁擠。 估計的繞線擁擠度圖在整片標準單元區域都是紅的,不只是幾個熱點。
- 慢速 corner 的 reg2reg 路徑有 −164 ns 的 setup slack,最差路徑在大數加速器 otbn 裡。
- 細部佈局把單元移動了最多 2.8 mm 才找到合法的位置。
- 日誌裡有一個錯誤: 電源網路檢查發現 VDD 和一個記憶體 macro 的兩個 pin 短路。
症狀不同,原因一樣:太多邏輯擠在同一個地方。在同一個扁平 floorplan 上再多花力氣,也改變不了這一點。
跑一整天學到的規則
跑這麼久的執行,每失敗一次就是一天,它也讓我們學到幾條規則,在專案的其餘部分一直遵守:
- 長時間的 EDA 執行不設 timeout。 更早的一次嘗試被我們自己設的四小時 timeout 殺掉,什麼輸出都沒有,也什麼都沒學到。
- 全域佈局之後存一個 checkpoint, 後面失敗時就不用從零開始。
- 要求工具輸出進度, 才分得出一個步驟是慢還是卡住了。
- 在每個工具裡明確設定執行緒數。
改成層次化
我們選了九個模組單獨硬化:otbn、Ibex CPU 核心、kmac、aes、entropy_src、flash 和 RRAM 控制器、RRAM 陣列,以及晶片用了三次的 i2c。加起來是 11 個實例。將近 700,000 個單元離開頂層,大約 440,000 個留下。
扁平晶片留作 v1,記錄發生過的事。沒有任何東西被覆蓋。層次化的晶片是 v2。
在 G2 裡硬化一個模組
每個模組都走同樣的步驟:一個新版本、一次 OpenROAD 簽出,然後一個階段接一個階段,每個階段都在自己的目錄裡。佈局之後,全域繞線檢查幾分鐘就能告訴我們這個模組到底繞不繞得通,再決定要不要花好幾個小時做時脈樹合成和細部繞線。
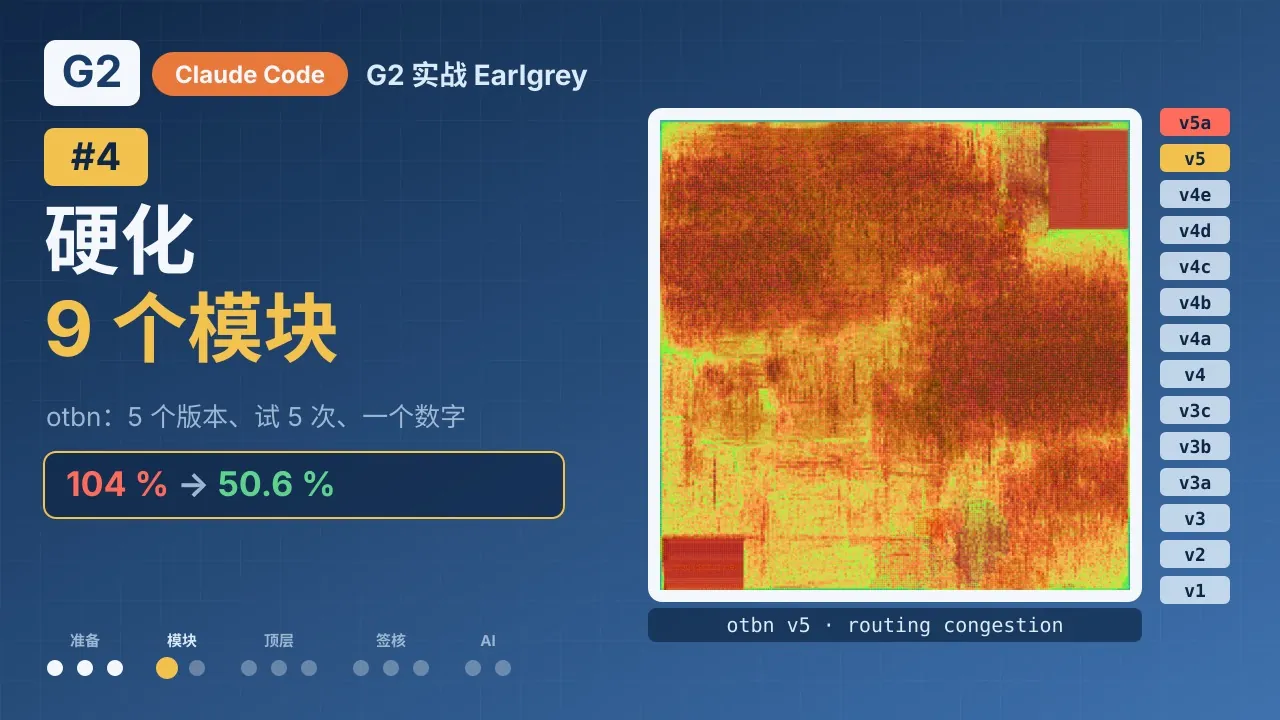 2:32
在 YouTube 觀看(英文) ↗在 Bilibili 觀看(中文) ↗
otbn 是最難的模組,一共走了五個版本:
- v2: 即使在 10 MHz,它很寬的資料通路還是差了大約 40 ns 的時序,所以在新的約束版本(SDC v03)裡加了兩週期路徑。
- v3,2.1 mm core: 全域繞線需要 104% 的可用走線。我們把它停掉。
- v4,2.6 mm: 83.5%,還有大約 100,000 條溢位的走線。
- v5,3.0 mm: 50.6%,溢位為零。可以繞通。
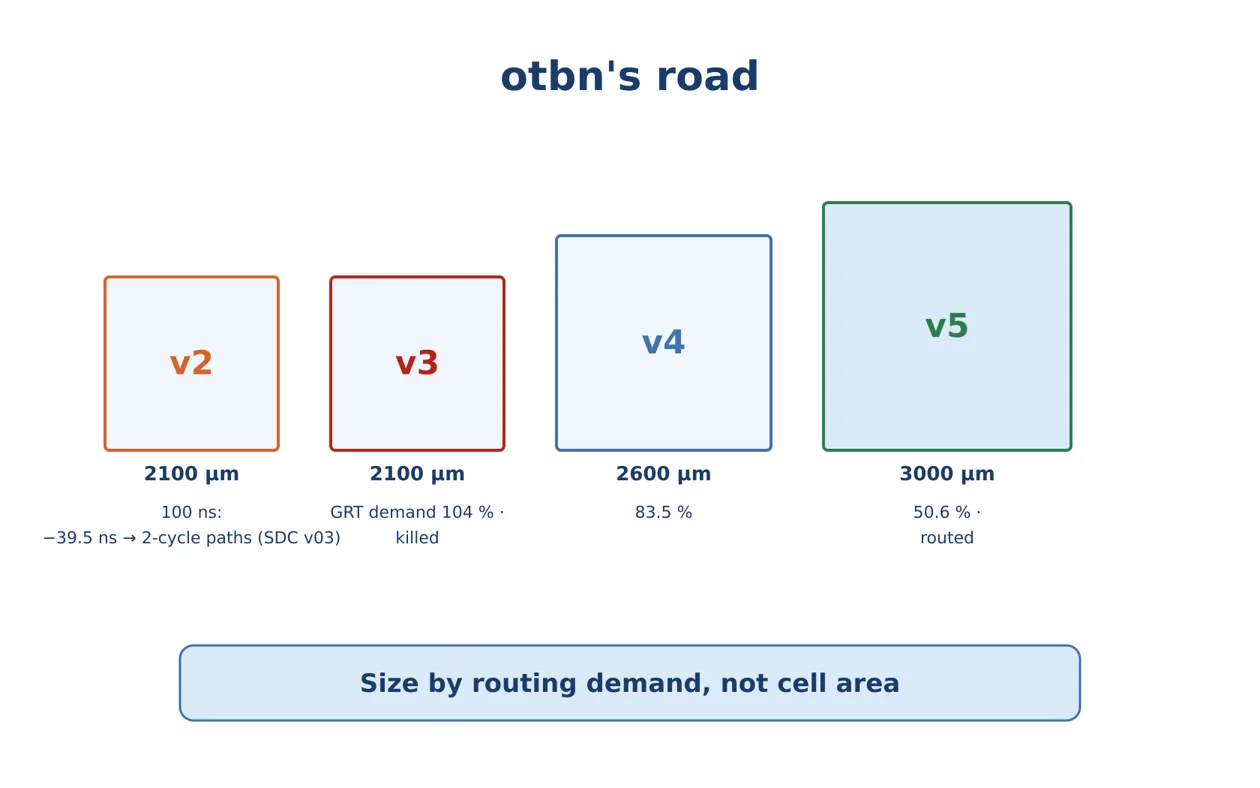
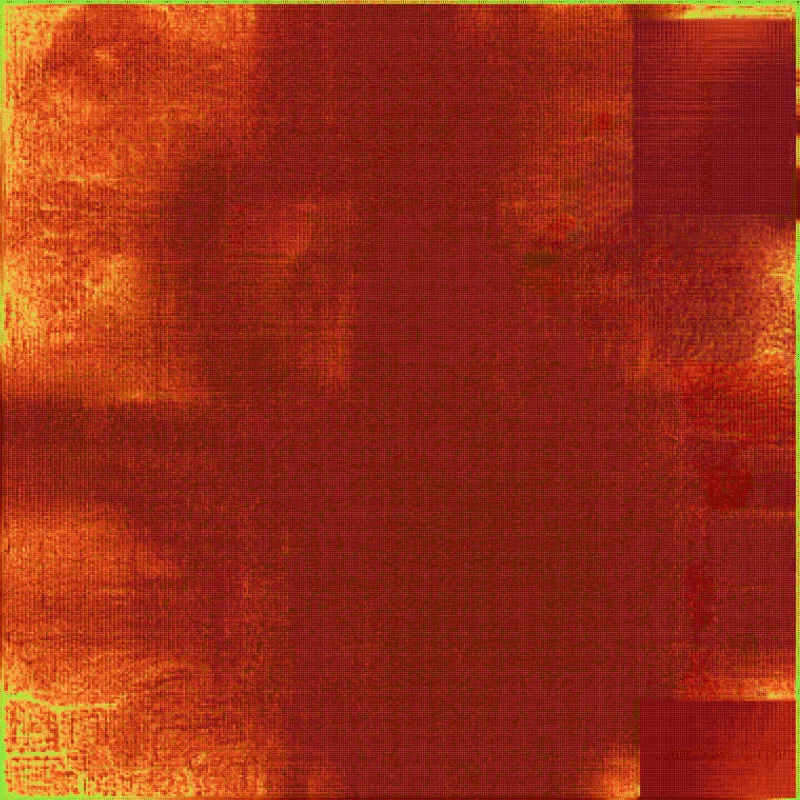
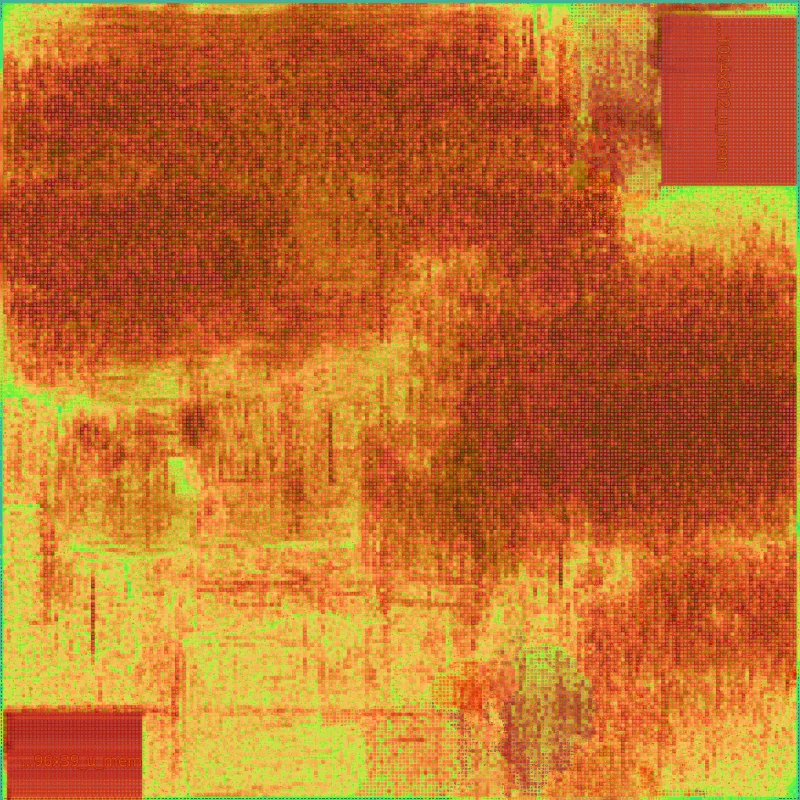
即使是 v5,也試了五次才繞通。每一次失敗都寫在這次執行的 README 裡,附上顯示問題的日誌和修正:一個永遠跑不完的修復步驟、一個洩漏到後續重繞的參數,以及細部繞線器連不上的 guide。
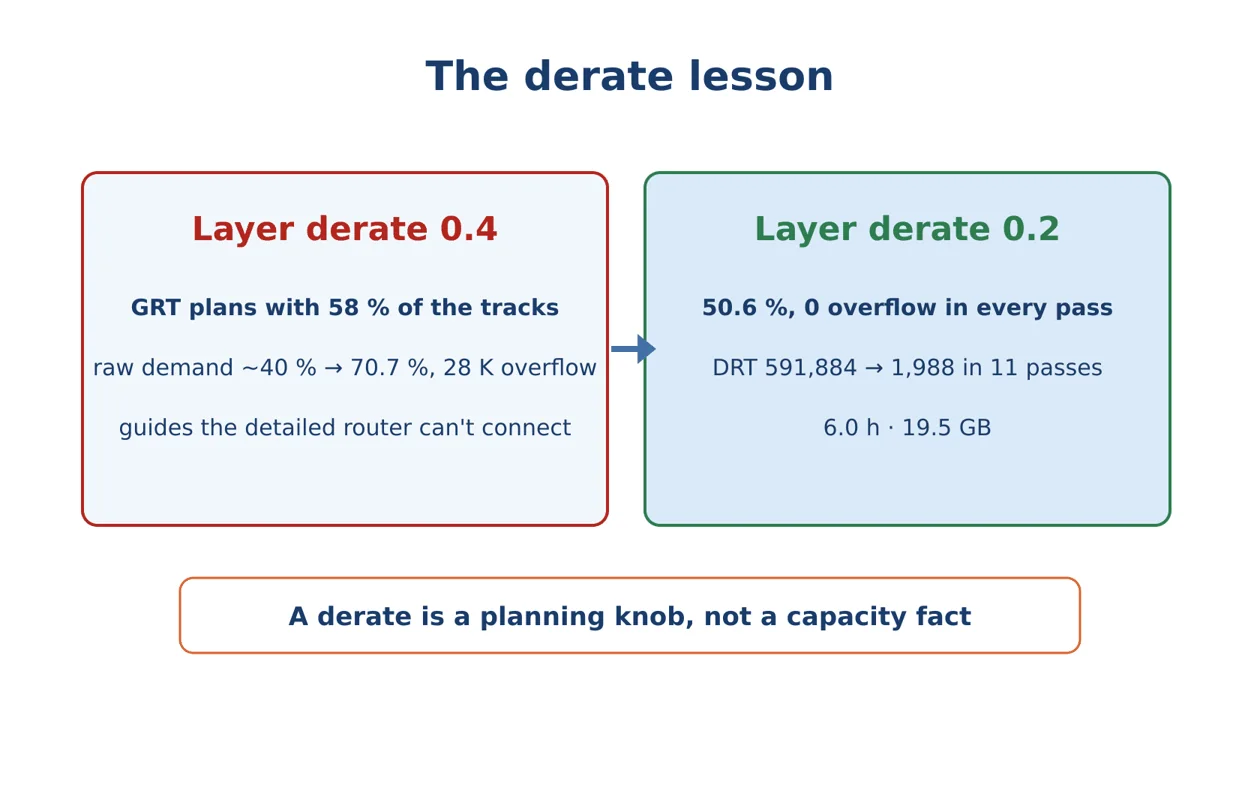
真正的解法只是一個數字。全域繞線器原本只用 58% 的走線來規劃,所以報告了其實不存在的溢位,做出細部繞線器用不了的 guide。把層的降額設成 0.2 之後,全域繞線的溢位變成零,細部繞線也從第一輪之後的 591,884 個違例,降到十一輪之後的 1,988 個。這次繞線花了六個小時。
另外八個模組,以及一次時脈變更
另外八個模組比較容易:九個模組的佈局繞線加起來大約 20 小時。下圖彙整了九個模組的結果。負的 slack 是模組的輸入輸出預算和很小的 hold 差額,不是核心邏輯的失敗。例如 flash_ctrl 的 −38.1 ns 是一條輸入到輸出的路徑;它的 reg2reg slack 是 +26.8 ns。
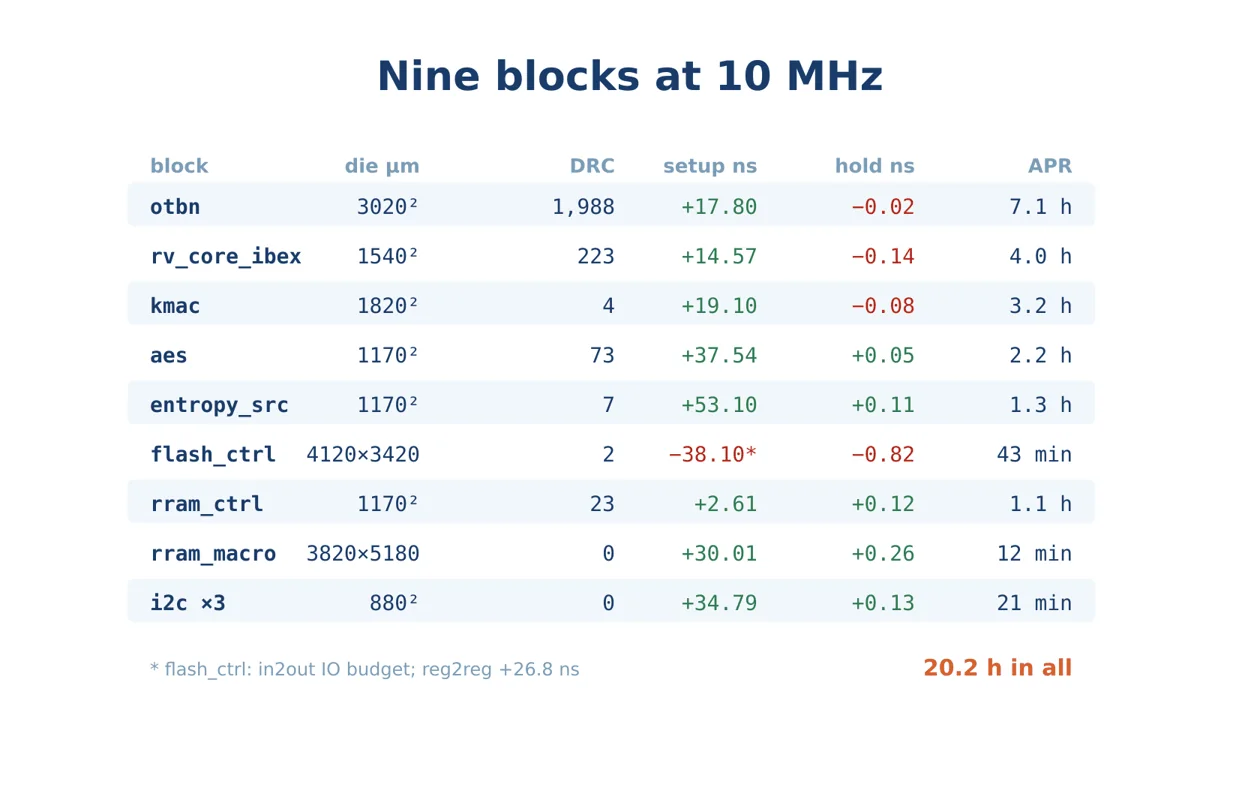
其中七個模組,是在我們決定晶片時脈用 10 MHz 之前就繞好的。在 G2 裡,時脈是發布的約束版本的一部分,所以由一個 G2 階段用新的時脈重新分析這些繞好的模組的時序。沒有任何東西需要重新佈局或繞線。
把繞好的模組變成 IP
繞好的模組要變成可重複使用的 IP,靠三個視圖,全部由 finish 階段寫出:
- 抽象 LEF: 外框、pin 和被阻擋的區域。
- 時序模型,兩個 corner(ss 1.60 V 和 ff 1.95 V,都是 100 °C)。
- black box 的 Verilog stub,只有埠。
有一個坑。OpenROAD 的抽象 LEF 寫出程式把模組裡每一個電源圖形都當作 pin 幾何匯出,卻沒有連接它們的 via。到了上一層,這些 pin 會是浮空的。我們只保留最上層的電源條作為電源 pin:模組使用 metal 1 到 7,頂層在它上方繞線。
 2:04
在 YouTube 觀看(英文) ↗在 Bilibili 觀看(中文) ↗
在 G2 裡,這些視圖放進元件庫管理,成為硬 IP:每個模組一個版本,每個 corner 一個 liberty 檔案,就像供應商提供的 IP 一樣。一共十一個條目:九個模組,加上 OpenTitan 的兩個類比 stub(ast 和 USB 差分接收器)。
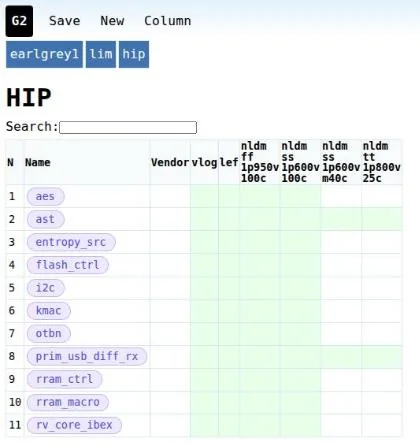
在頂層,每個模組一行,決定它要怎麼處理。合成的那一行讓模組保持成邏輯。hardmacro 那一行帶進 black box,OpenROAD 再從元件庫裡讀它的版圖和時序。主電源域有九行硬 macro;i2c 是一行、三個實例。
每份報告都說「沒問題」的 bug
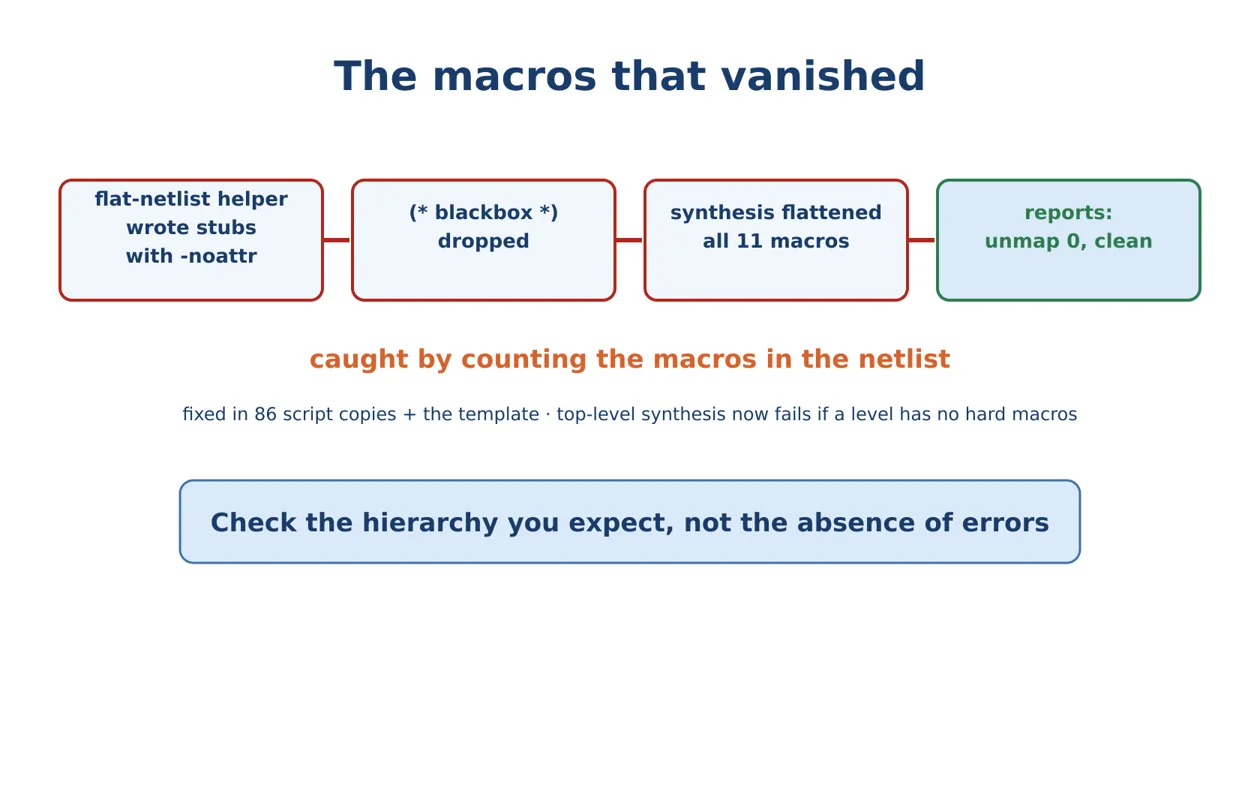
有一次,十一個 macro 全部消失了,而每一份報告看起來都還很乾淨。一個寫扁平網表的輔助程式把 black box 屬性弄丟了,所以合成把這些 macro 全部展平掉,報告的卻是未映射單元為零,而這通常代表成功。
我們是靠數網表裡的 macro 才發現的。現在只要某一層應該有硬 macro 卻一個都沒有,流程就會失敗。教訓是:要檢查你期望的層次結構,而不只是檢查有沒有錯誤。
結果
新的頂層有 529,205 個實例,而不是 113 萬個,佈局只要幾個小時。執行時間的問題解決了。繞線的問題還沒有:在下一篇裡,頂層第一次繞線檢查顯示有 122 萬條溢位的走線,我們得找出它們從哪裡來。