
在第 2 篇的最後,晶片已經是層次化的:九個硬化模組、十一個實例,以及一個有 529,205 個實例的頂層,佈局只要大約三小時,而不是二十五小時。這一篇講下一個問題,也就是頂層的繞線,以及解決了大部分問題的方法。
第一次繞線檢查還沒開始就停了
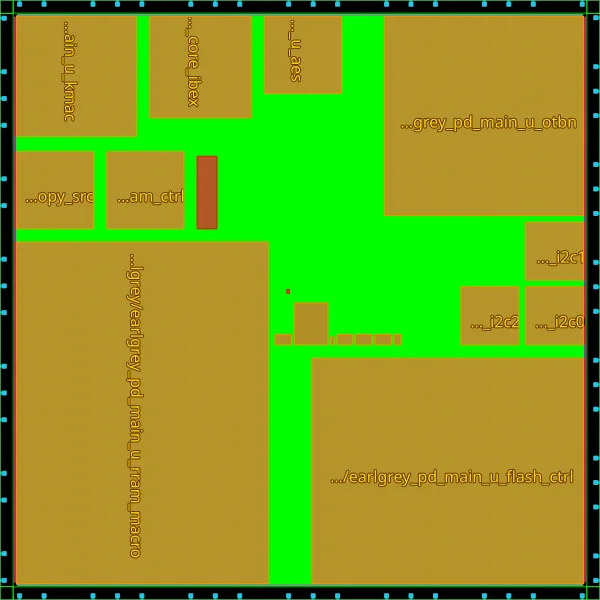
晶片 v2 用的是手動 floorplan:硬化模組沿著 8.6 mm core 的四邊擺放,記憶體在中間排成一排,模組之間留出通道給頂層的邏輯。層次化解決了執行時間:repair_design 只花了大約 2 小時,而不是 22.5 小時。但是頂層的單元現在擠在很窄的通道裡,佈局器估計的擁擠度反而比扁平晶片還差。
接著,全域繞線檢查在 pin 接入這一步就停了:有一個記憶體的 pin 沒有合法的接入點。十八個記憶體 LEF 裡,有四個的 pin 跑到 macro 外面最多 59 µm。我們在 G2 裡把它們修好,做成新的記憶體元件庫版本。同一個 pin 又失敗了:它比一個繞線阻擋區高了 0.08 µm。於是又需要第二個元件庫版本。扁平晶片從來沒有走到這一步,所以這兩個 bug 都沒被發現。
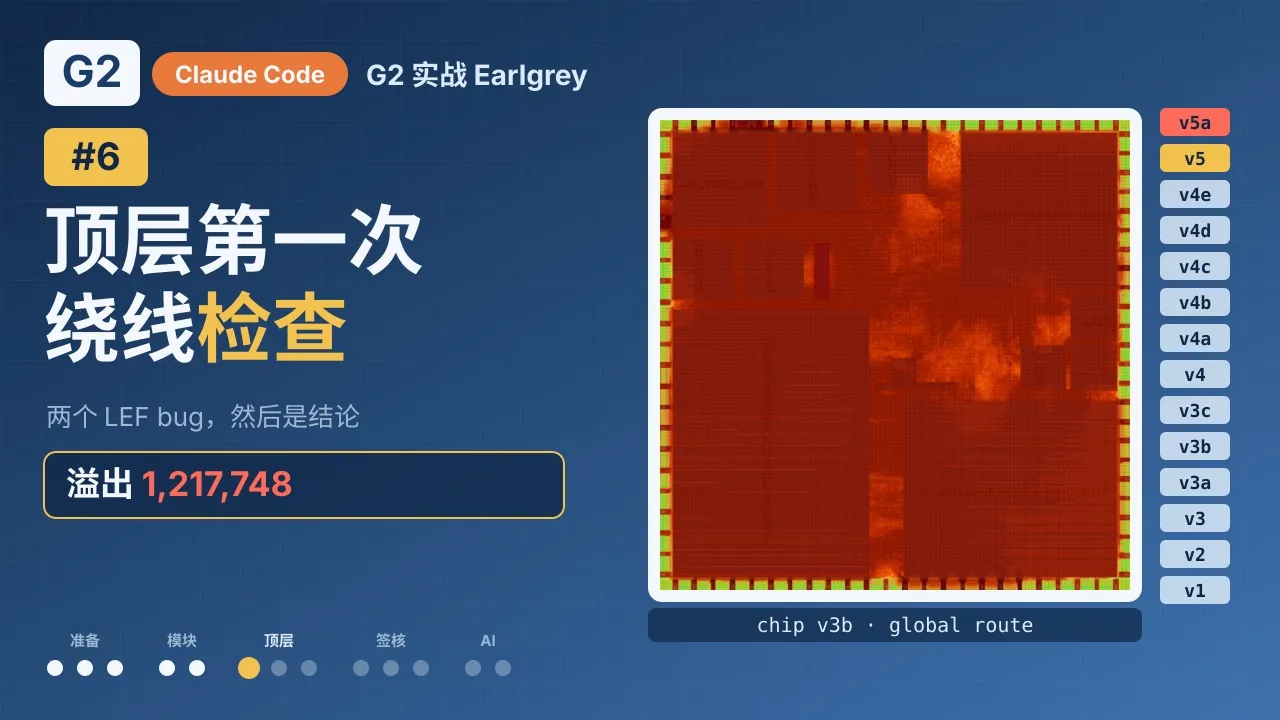 2:13
在 YouTube 觀看(英文) ↗在 Bilibili 觀看(中文) ↗
不從頭來,測試一個修正
為了測試第二個修正,我們沒有重新佈局晶片。一個小的測試版本(v3b)以唯讀方式連結已經佈好局的設計,直接在記憶體中修補那一個記憶體 macro,只跑全域繞線檢查:28 分鐘,而不是先花三小時佈局。在 G2 裡,這只是另一個版本,有自己的階段目錄和 README,所以這個捷徑和其他執行一樣都有記錄。
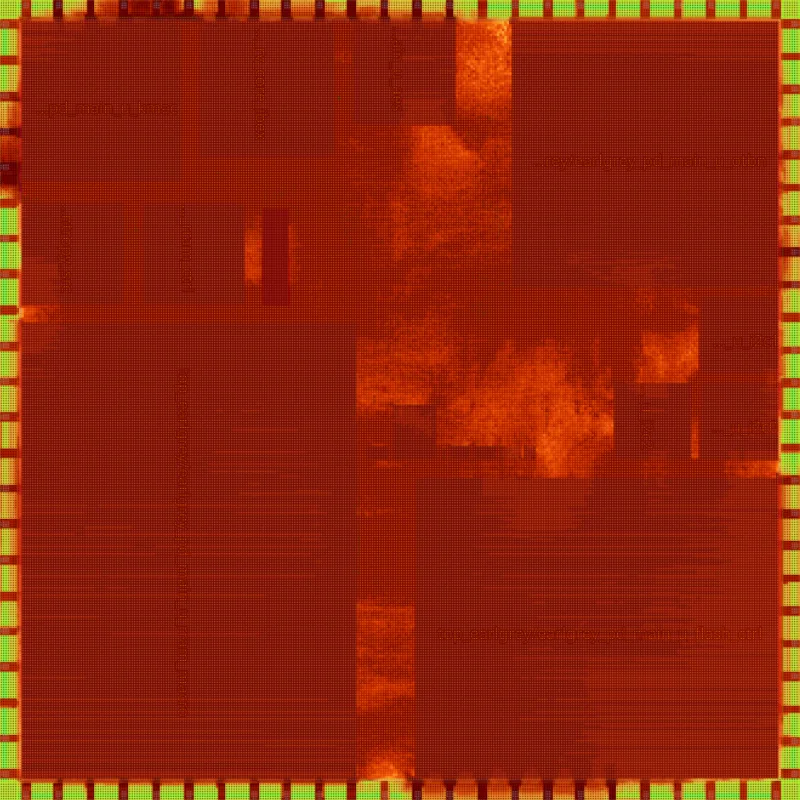
結果是:1,217,748 條溢位的走線,到處都是紅的,大約是最大模組能繞通時溢位的 43 倍。
四條出路,最便宜的先試
我們寫下了四個選項:
- A. 改一個全域繞線設定(修好 otbn 的那個層降額):30 分鐘就能測試。
- B. 更大的 core、更寬的通道。
- C. 從頂層來決定模組 pin 的位置。
- D. 硬化更多模組。
我們先試最便宜的。A 讓溢位少了三分之一,降到 749,885。B 用 9.6 mm 的 core,少了四分之三,降到 176,749。這仍然是 otbn 能繞通時的六倍。
不過這些數字透露了有用的資訊。平均走線需求只有 22%,橫向的金屬層卻在溢位。這種模式代表區域性的熱點,而不是晶片太小。下一個問題就是:熱點在哪裡。
第一步:測量
一個測試版本(v4a)連結 v4 已經佈好局的設計,多跑一個階段,也就是探測。它在 15 秒內、用 1.6 GB 記憶體,把每條擁擠 net 的端點、每個模組的 pin 和每個單元都匯出來。它的 README 說明溢位從哪裡來、是哪些 net 造成的,以及下一步可以試什麼。
 2:25
在 YouTube 觀看(英文) ↗在 Bilibili 觀看(中文) ↗
它找到的東西:
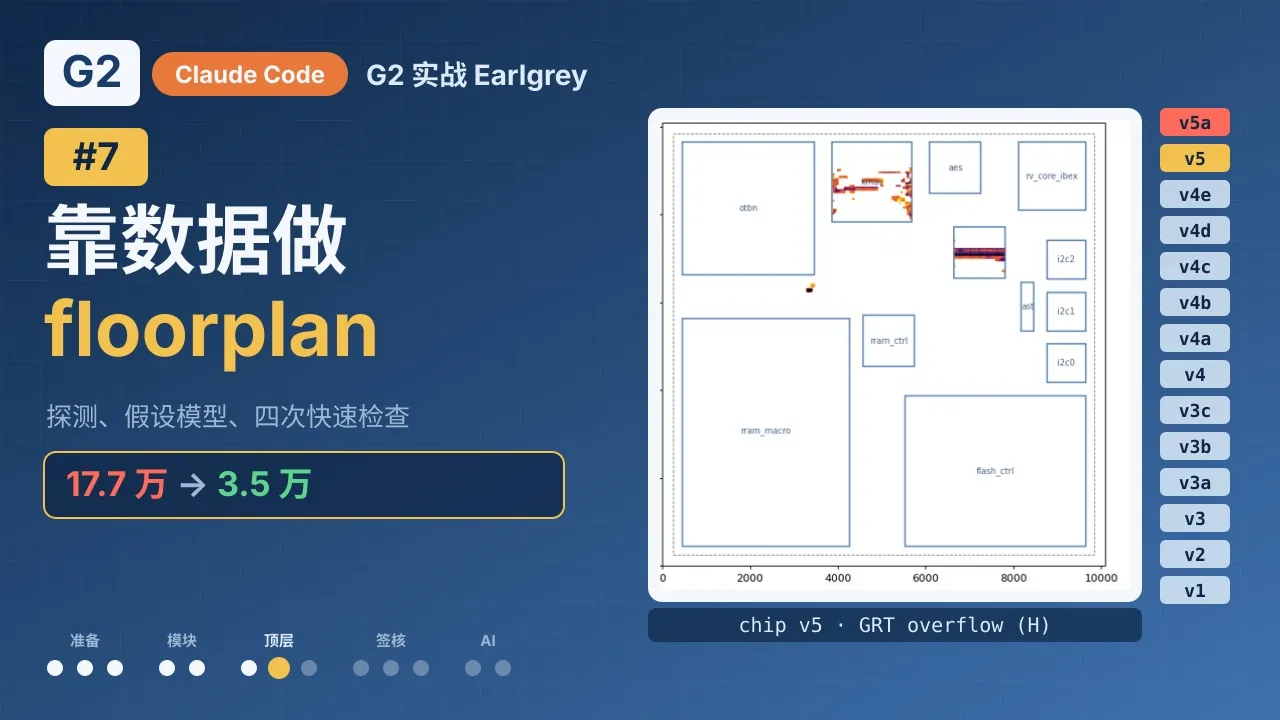
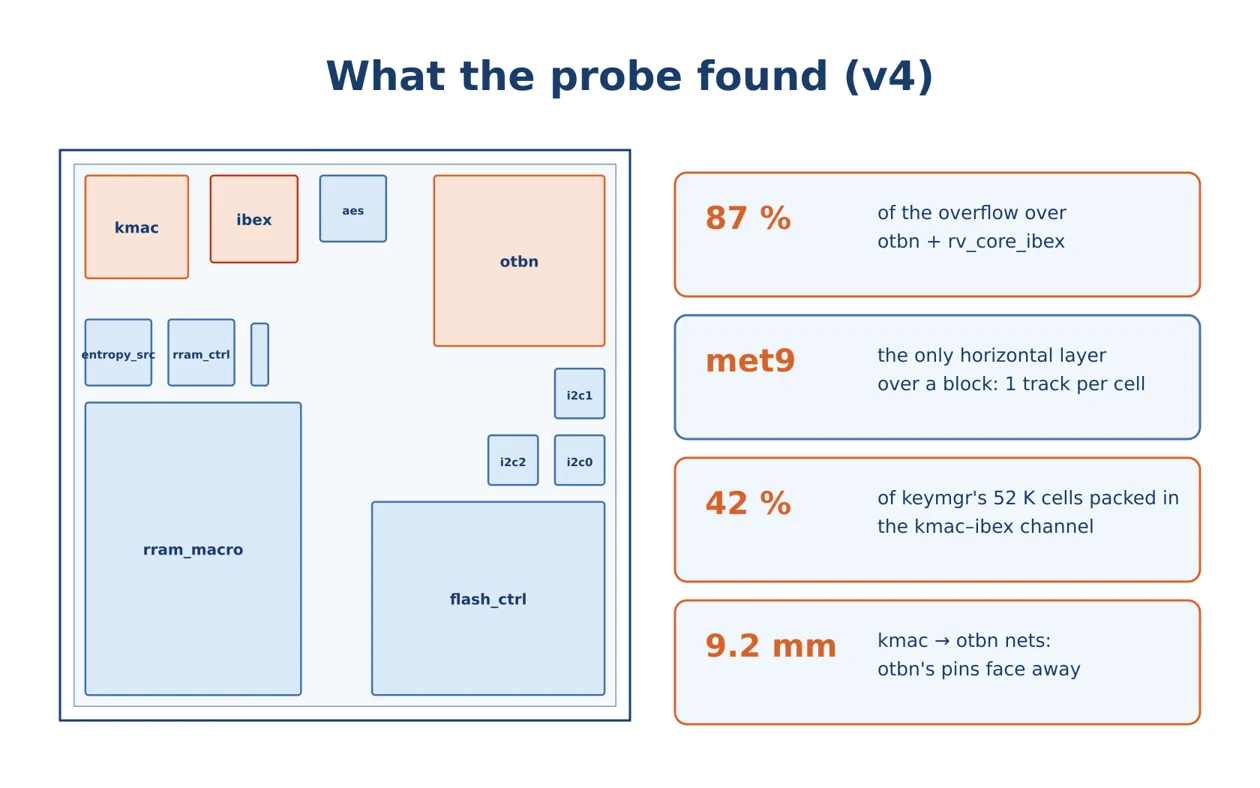
- 87% 的溢位在兩個模組上方: otbn(40%)和 Ibex 核心(39%),其中 85% 是橫向的。
- 在硬模組上方,只有一層金屬是橫向的(我們的堆疊裡是 metal 9),而且繞線網格的每一格只有一條走線。任何橫向跨過模組的頂層連線,都在搶這一條走線。
- 金鑰管理器的邏輯(51,757 個單元)擠在 kmac 和 Ibex 核心之間 400 µm 寬的通道裡:42% 都在這一條通道。
- otbn 的 pin 背對著 kmac,所以有些 kmac 到 otbn 的 net 長達 9 mm 以上。
第二步:不跑 EDA,用模型給候選方案排序
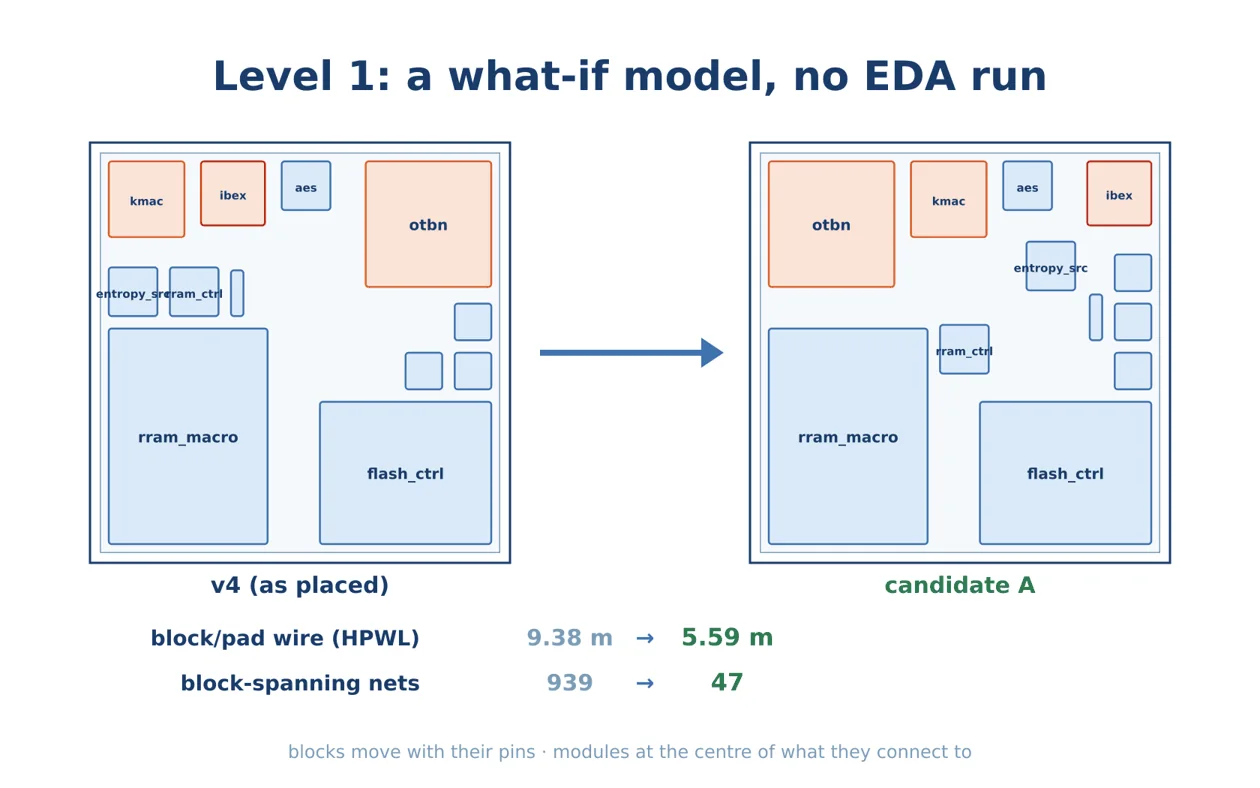
「第一級」模型是一個快速的假設分析腳本,不是 EDA 執行。它移動模組,pin 跟著一起移動,把每個頂層模組放在它所連接物件的中心,然後估算連線。候選方案 A 把 otbn 放在角落、kmac 放在旁邊,鏡像兩個大 macro,並把中間空出來。估計的模組之間連線從 9.38 m 降到 5.59 m,跨過模組的 net 數量從 939 條降到 47 條。
第三步:用很短的真實執行檢查最好的候選方案
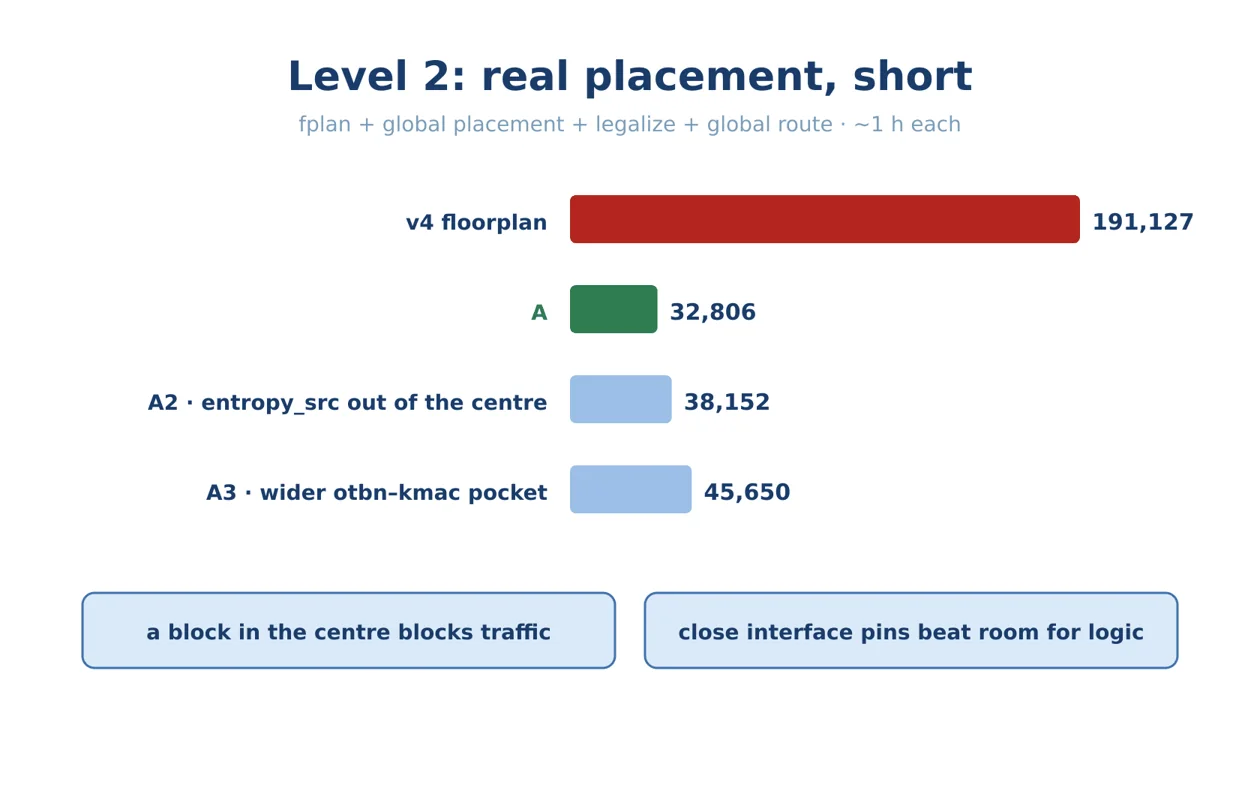
「第二級」是真實的,但很短:全域佈局、合法化和一次全域繞線檢查,每個候選方案大約一小時,各自是一個測試版本。
| 候選方案 | 改了什麼 | GRT 溢位 |
|---|---|---|
| v4c | 原來的 floorplan,同樣的短流程(基準) | 191,127 |
| A | otbn 放在角落、kmac 在旁邊,中間空出來 | 32,806 |
| A2 | A 的一個變化版本 | 38,152 |
| A3 | A 的一個變化版本 | 45,650 |
兩個變化版本也讓我們學到東西:放在中間的模組會擋住走線,而讓介面 pin 彼此靠近,比給邏輯更多空間更有效。
第四步:完整的執行
接著我們把候選方案 A 真正佈局成晶片 v5。預測成立:34,639 條溢位的走線(比 v4 少 80%),平均需求 17%,連線少了 22%(103.0 m → 80.1 m)。
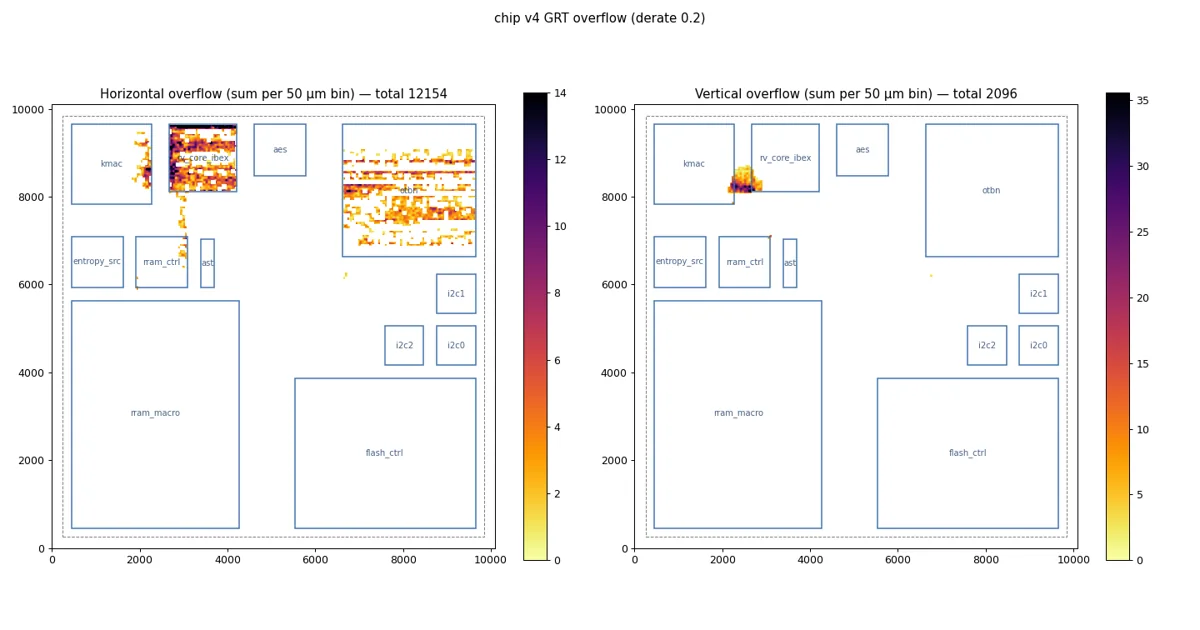
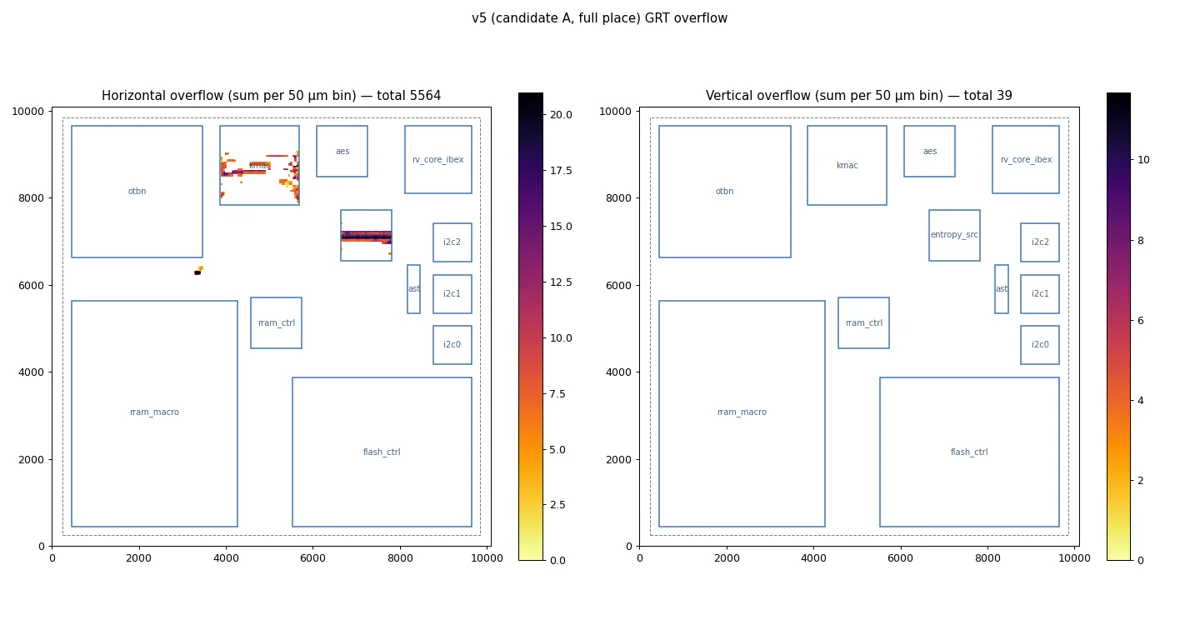
剩下的是兩條帶狀區域,在 kmac(59%)和 entropy_src(35%)上方,主要是金鑰管理器連到 kmac 的匯流排。這大約就是最大模組能繞通的程度,所以我們決定去繞線。模型也有侷限:它放置模組的位置大約偏差一毫米,這就是為什麼第二級的檢查才是真正的測試。
整個方法可以用一句話概括:測量、排序、檢查,然後才執行。 便宜的步驟先做。
晶片的繞線:26 小時,以及預測漏掉了什麼
佈局之後是時脈樹合成、它的修復、繞線、繞線後處理和 finish。紙面上是六個階段。實際上試了二十次,大部分是因為記憶體。(這個故事在第 6 篇。)
 2:08
在 YouTube 觀看(英文) ↗在 Bilibili 觀看(中文) ↗
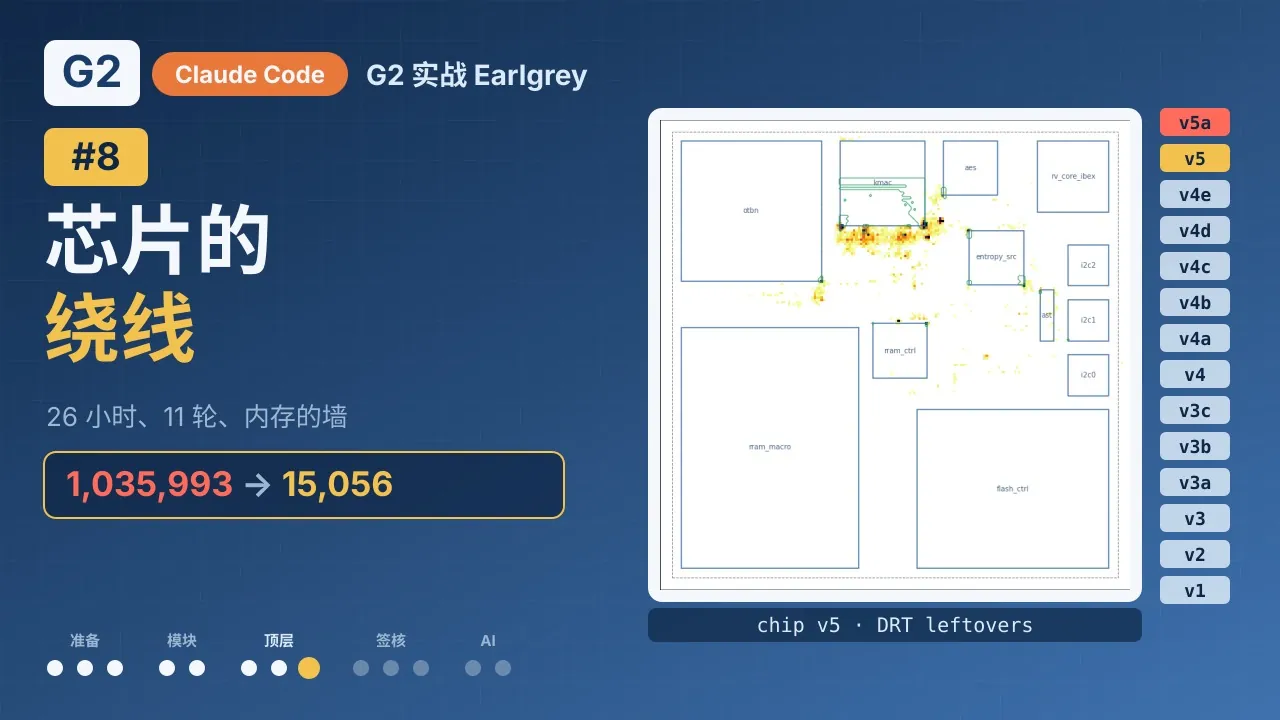
細部繞線跑了 26 小時、11 輪,從第一輪之後的 1,035,993 個違例,降到最後一輪之後的 15,056 個。前三輪,晶片的表現和模組一樣。到了第 3 輪,模組的違例會降 4 到 20 倍;晶片只降了 3.2 倍。之後每一輪都更久,清掉的卻更少。
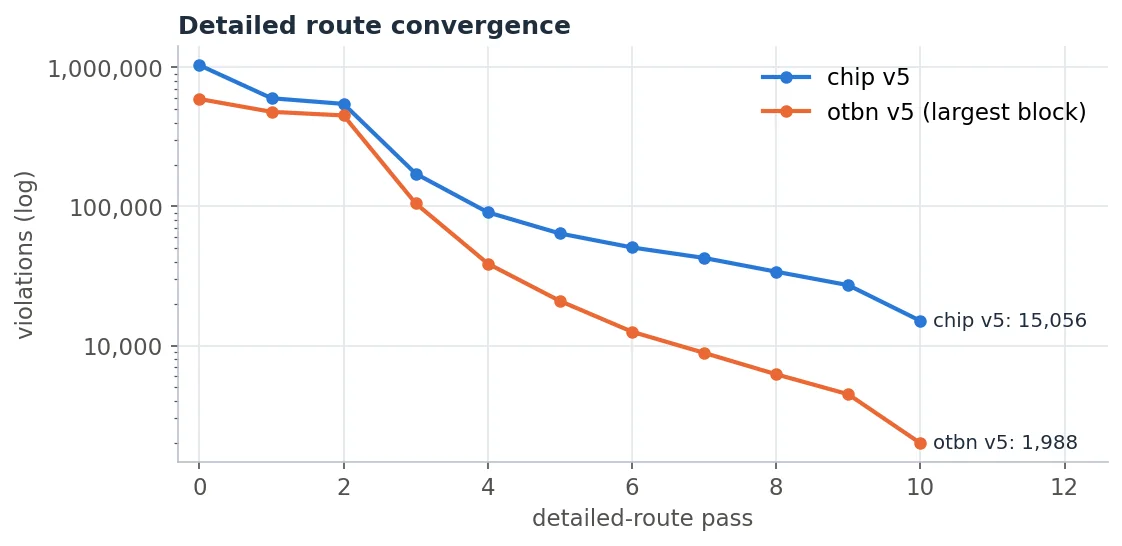
剩下的違例,正好在全域繞線器說的地方。它發現 80% 的溢位在 kmac 上方。細部繞線器也塞不下這些線,就把它們推到 kmac 正南邊的通道裡:81% 的違例集中在 2.5 mm² 裡。
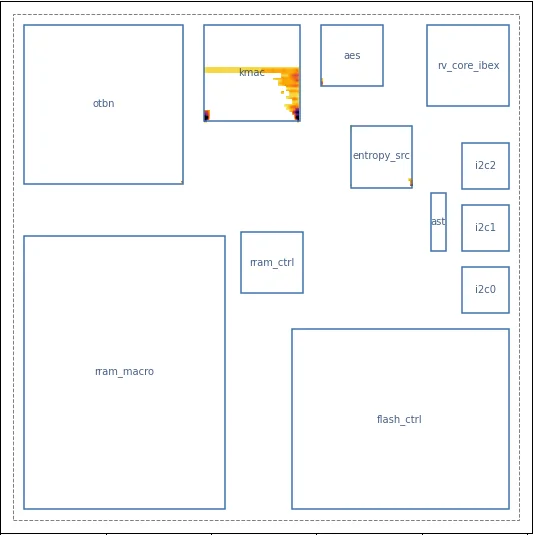
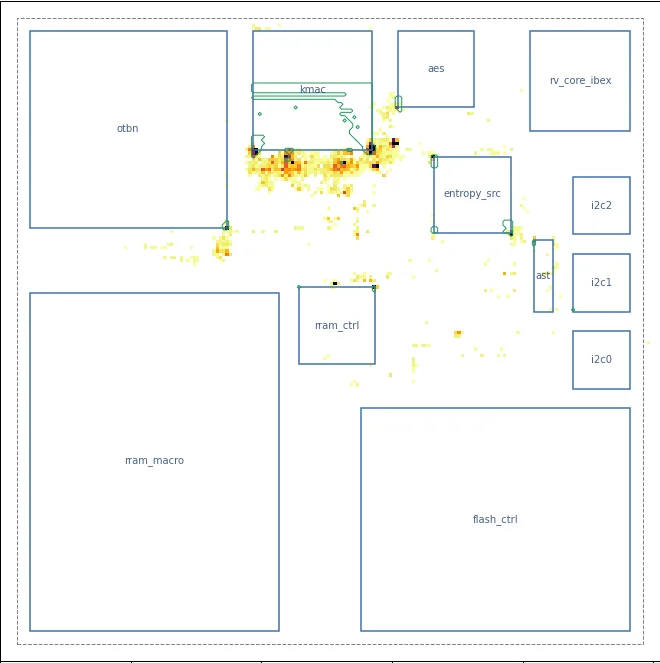
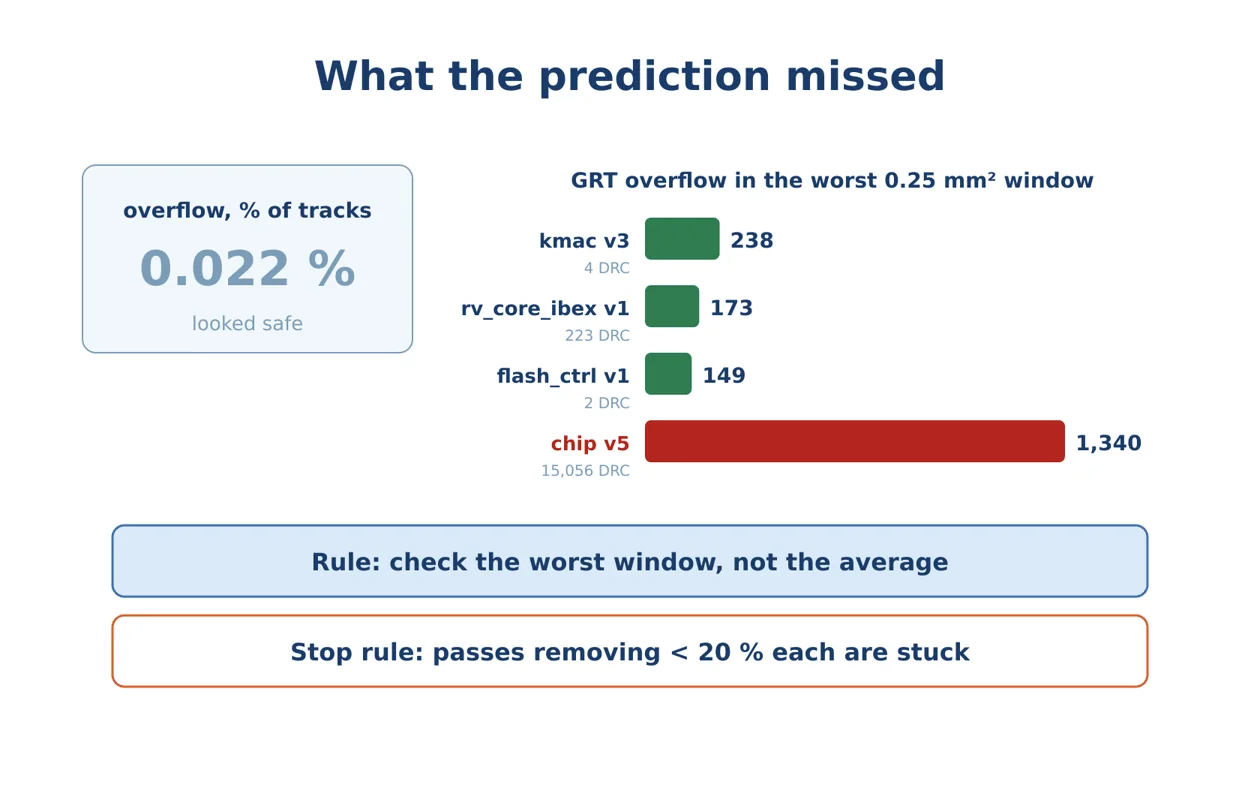
我們的預測原本認為晶片繞得通,因為溢位只佔所有走線的 0.022%。結果這是錯誤的指標。由此得到兩條規則:
- 看最差的小區域,而不是總數。 在最差的 0.25 mm² 全域繞線區域裡,晶片有 1,340 條溢位的走線。能繞通的模組只有 149 到 238 條。
- 每一輪停滯時就停下來。 當每一輪細部繞線清掉的不到剩餘的五分之一,再多跑幾輪也完成不了。
接著要做一個決定:修 kmac 周圍的 floorplan,大約還要兩天;或者現在就完成,把剩下的問題寫下來。這是流程示範,不是下線,所以我們完成它。繞線後處理和 finish 都完成了,每個剩下的問題都寫在這個版本的筆記裡。修好 kmac 通道,並在繞線前用最差區域規則檢查,是晶片 v6 的第一項工作。
G2 帶來了什麼
這裡的每一步都是一個附帶 README 的 G2 版本:探測、四次短檢查,以及避免重新佈局的那次唯讀測試。正因如此,這個方法才能便宜地照著做。資料、決定和下一步都留在產生它們的執行旁邊,floorplan 的選擇可以靠數字追溯,而不是靠記憶。
下一篇:完成的晶片要在獨立的工具裡做簽核,而這揭露了 OpenROAD 的兩個 bug。