
1편에서는 전체 흐름을 소개했습니다. SkyWater 130에서 약 113만 개의 표준 셀로 이루어진 OpenTitan Earlgrey를 오픈소스 도구로 RTL부터 사인오프 타이밍까지 진행했고, G2로 관리했으며, Claude Code가 실제 작업의 상당 부분을 맡았습니다. 이 글은 그 이야기의 첫 번째 큰 전환점을 다룹니다. 칩을 플랫으로 시도했지만 되지 않았고, 칩 팀이 하는 방식인 아래에서부터 쌓아 올리는 방식으로 바꿨습니다.
데이터로 플랫 칩의 크기 정하기
블록 40개 모두 Yosys와 yosys-slang으로 문제없이 합성되었습니다. 무엇이든 배치하기 전에 넷리스트로 다이 크기를 정했습니다. 셀 113만 개와 메모리 23개에는 약 41 mm²가 필요하므로, 플랫 칩에는 8.1 mm 다이를 주었습니다. 첫 실행 전에 바꿔야 할 설정이 하나 있었습니다. 기본 셀 패딩만으로 배치 면적이 두 배가 되었기 때문에 이를 줄였습니다.
G2에서 플랫 칩은 버전 v1입니다. 단계마다(init, 플로어플랜, 배치, CTS, 배선 등) 디렉터리가 하나씩 있는 OpenROAD 체크아웃이며, 각 디렉터리에는 로그, 리포트, QoR 요약, README가 있습니다.
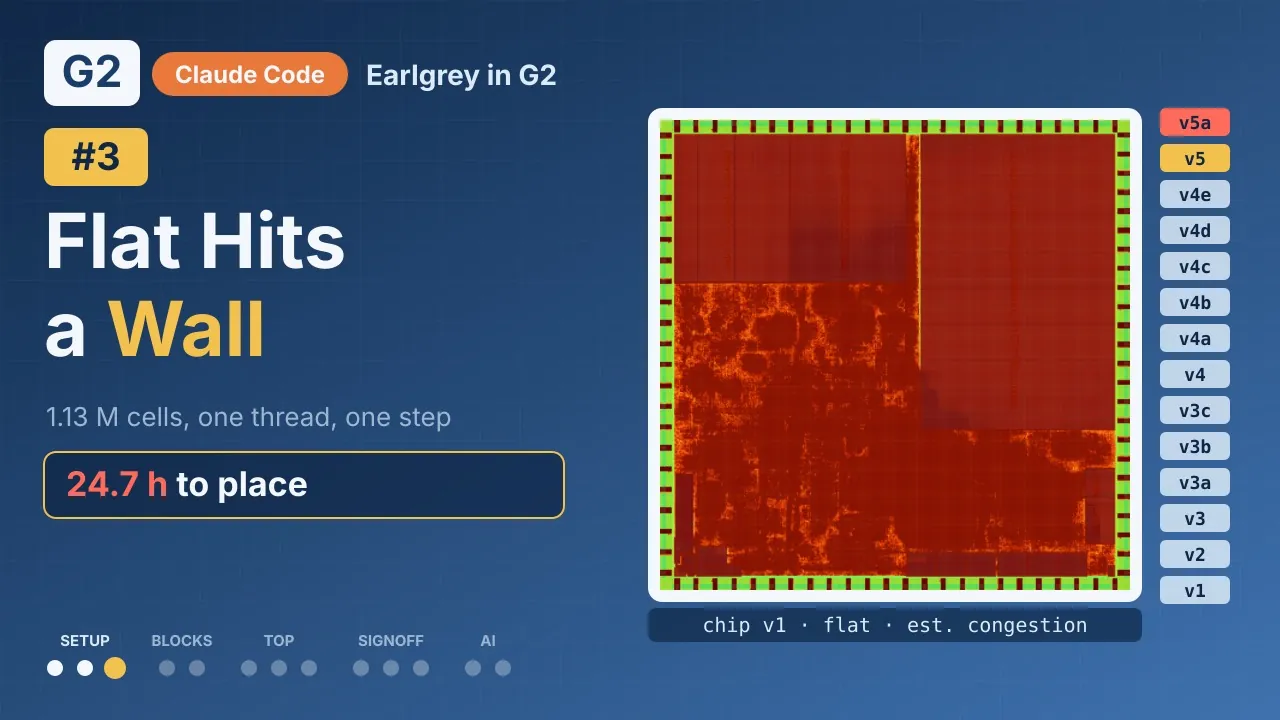 2:19
YouTube에서 보기(영어) ↗Bilibili에서 보기(중국어) ↗
24.7시간, 거의 전부가 한 단계
초기화에 7분, 플로어플랜에 23분이 걸렸습니다. 배치에는 24시간 43분이 걸렸습니다.
그중 약 22.5시간이 한 단계였습니다. 셀 크기를 바꾸고 버퍼를 추가해 슬루, 커패시턴스, 팬아웃을 고치는 repair_design입니다. 이 단계는 칩의 모든 드라이버를 싱글 스레드로 하나씩 처리합니다. 끝 무렵에는 진행 표의 한 행에 거의 한 시간이 걸렸습니다. 전체적으로 약 76,000개의 버퍼가 추가되었습니다.
결과는 쓸 수 없었습니다.
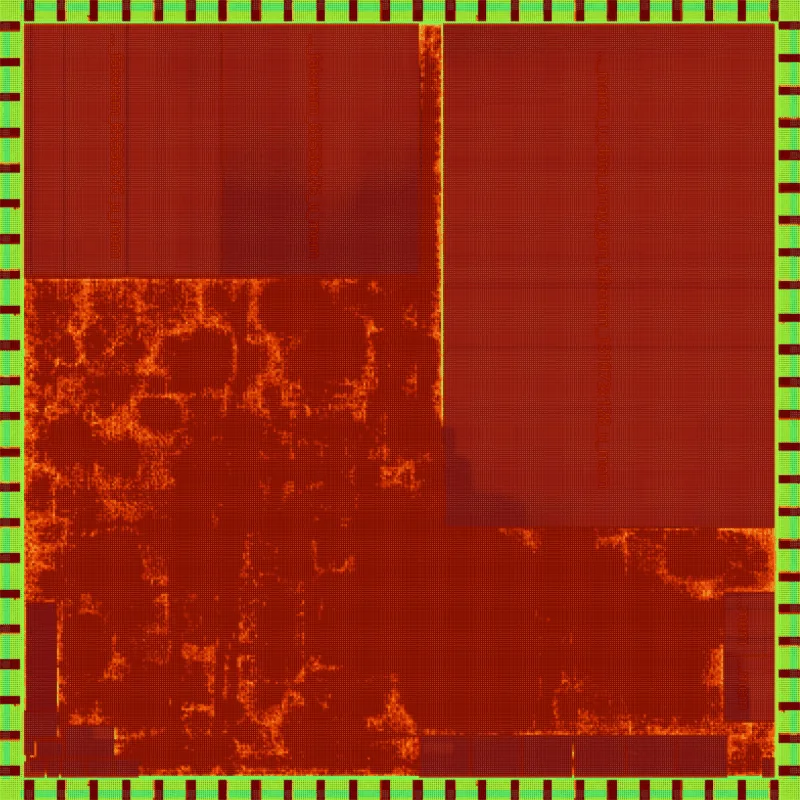
- 전체가 혼잡. 추정 배선 혼잡도 맵이 몇몇 핫스폿이 아니라 표준 셀 영역 전체에 걸쳐 빨간색이었습니다.
- 저속 코너의 reg2reg 경로에서 셋업 슬랙 −164 ns, 최악 경로는 큰 수 연산 가속기인 otbn에 있었습니다.
- 상세 배치가 합법적인 자리를 찾으려고 셀을 최대 2.8 mm까지 이동시켰습니다.
- 로그의 오류 하나: 전원 그리드 검사에서 VDD가 메모리 매크로의 핀 두 개와 단락되어 있었습니다.
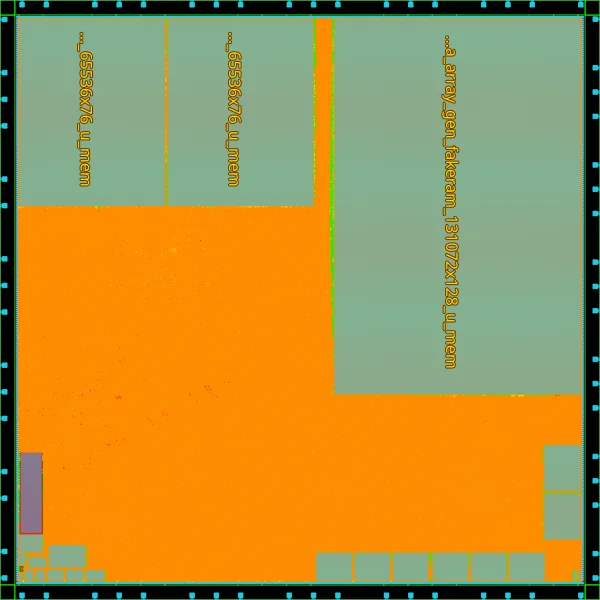
증상은 달라도 원인은 하나입니다. 한곳에 로직이 너무 많다는 것입니다. 같은 플랫 플로어플랜에 노력을 더 들여도 이것은 바뀌지 않습니다.
하루짜리 실행에서 얻은 규칙
이렇게 긴 실행은 실패할 때마다 하루가 날아갑니다. 그래서 프로젝트 내내 지킨 규칙 몇 가지를 얻었습니다.
- 긴 EDA 실행에는 타임아웃을 두지 않습니다. 이전 시도는 저희가 직접 설정한 4시간 타임아웃 때문에 중단되었습니다. 아무 출력도 남지 않았고 아무것도 배우지 못했습니다.
- 글로벌 배치 후 체크포인트를 저장합니다. 그래야 나중에 실패해도 처음부터 다시 시작하지 않습니다.
- 도구에 진행 상황 출력을 요청합니다. 그래야 느린 단계와 멈춘 단계를 구별할 수 있습니다.
- 모든 도구에서 스레드 수를 명시적으로 설정합니다.
계층 설계로
따로 하드닝할 블록 9개를 골랐습니다. otbn, Ibex CPU 코어, kmac, aes, entropy_src, 플래시와 RRAM 컨트롤러, RRAM 어레이, 그리고 칩에서 세 번 쓰이는 i2c입니다. 그래서 인스턴스는 11개입니다. 거의 70만 개의 셀이 톱 레벨에서 빠져나가고 약 44만 개가 남습니다.
플랫 칩은 일어난 일의 기록으로 v1에 그대로 남겼습니다. 덮어쓴 것은 없습니다. 계층 칩은 v2가 되었습니다.
G2에서 블록 하드닝하기
모든 블록은 같은 단계를 따릅니다. 새 버전, OpenROAD 체크아웃, 그리고 각자의 디렉터리에서 하나씩 진행하는 단계들입니다. 배치 후에는 글로벌 라우팅 검사가 몇 분 만에 끝나고, 몇 시간짜리 클록 트리 합성과 상세 배선에 앞서 블록이 애초에 배선될 수 있는지 알려 줍니다.
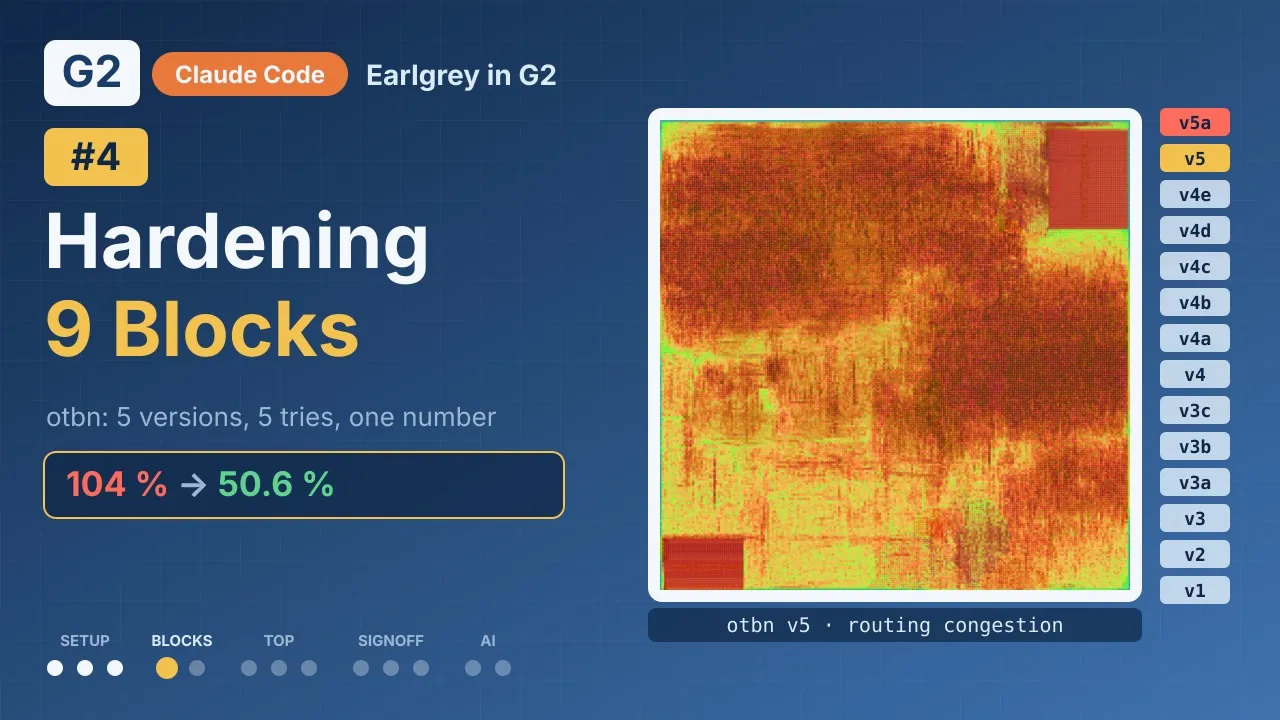 2:29
YouTube에서 보기(영어) ↗Bilibili에서 보기(중국어) ↗
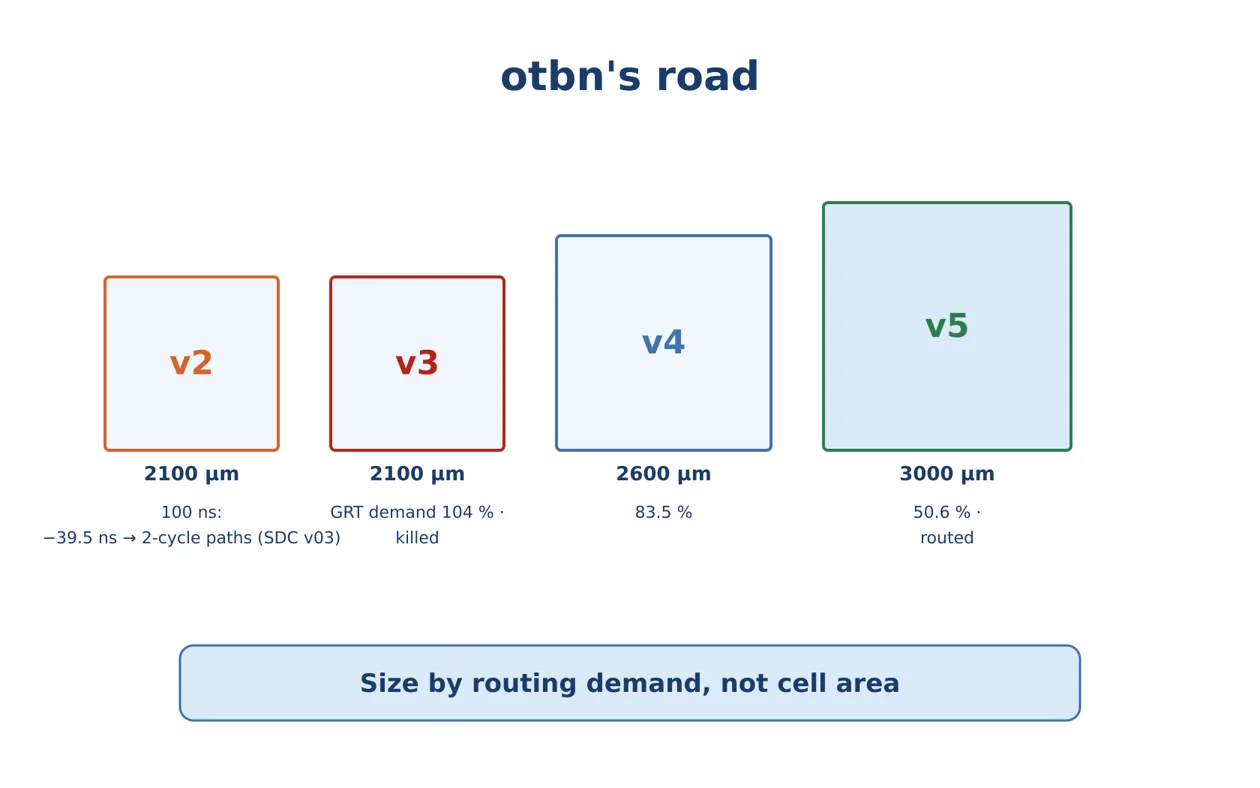
otbn이 가장 어려운 블록이었고, 버전 다섯 개를 거쳤습니다.
- v2: 10 MHz에서도 넓은 데이터 경로가 타이밍을 약 40 ns 놓쳐서, 새 제약 조건 버전(SDC v03)에서 2사이클 경로를 주었습니다.
- v3, 2.1 mm 코어: 글로벌 라우팅이 사용 가능한 트랙의 104%를 필요로 했습니다. 중단했습니다.
- v4, 2.6 mm: 83.5%, 여전히 오버플로 트랙이 약 100,000개.
- v5, 3.0 mm: 50.6%, 오버플로 0. 배선 가능.
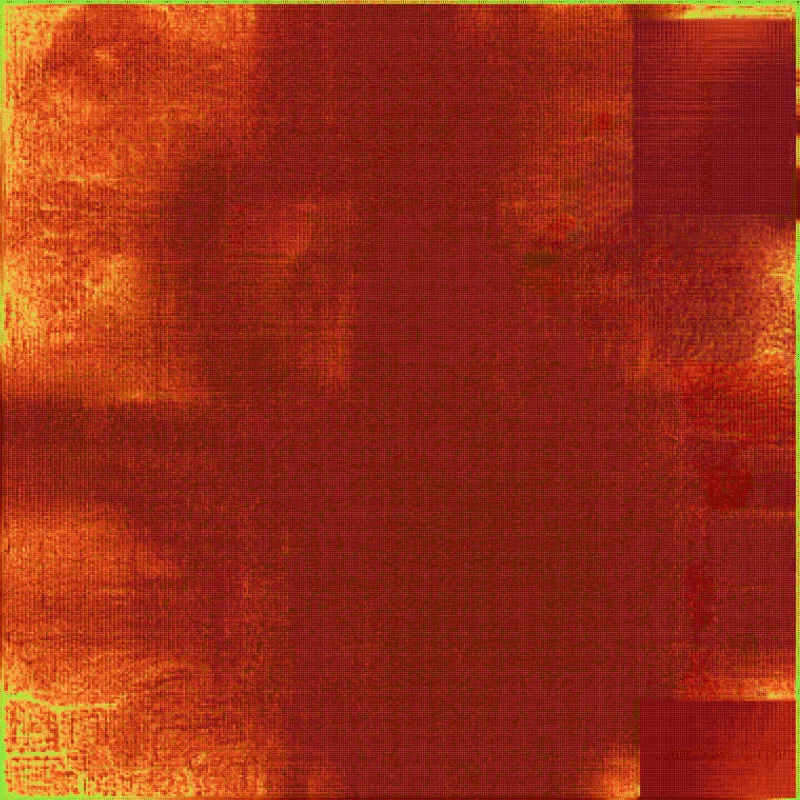
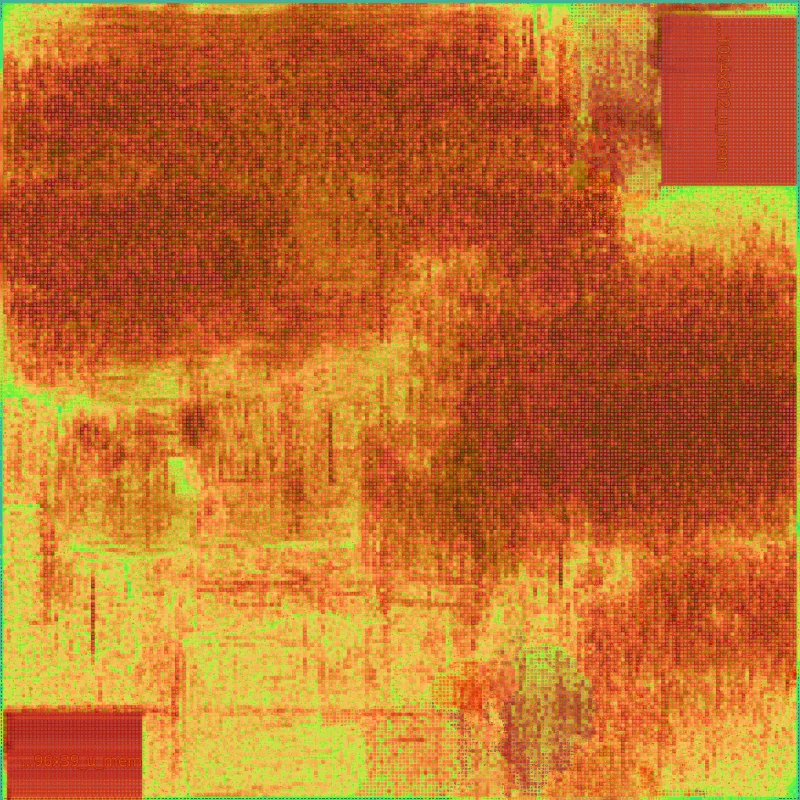
v5도 배선에 다섯 번의 시도가 필요했습니다. 실패마다 그것을 보여 준 로그와 수정 방법이 실행의 README에 남아 있습니다. 끝나지 않는 수리 단계, 이후의 재배선으로 새어 들어간 플래그, 그리고 상세 라우터가 연결하지 못하는 가이드였습니다.
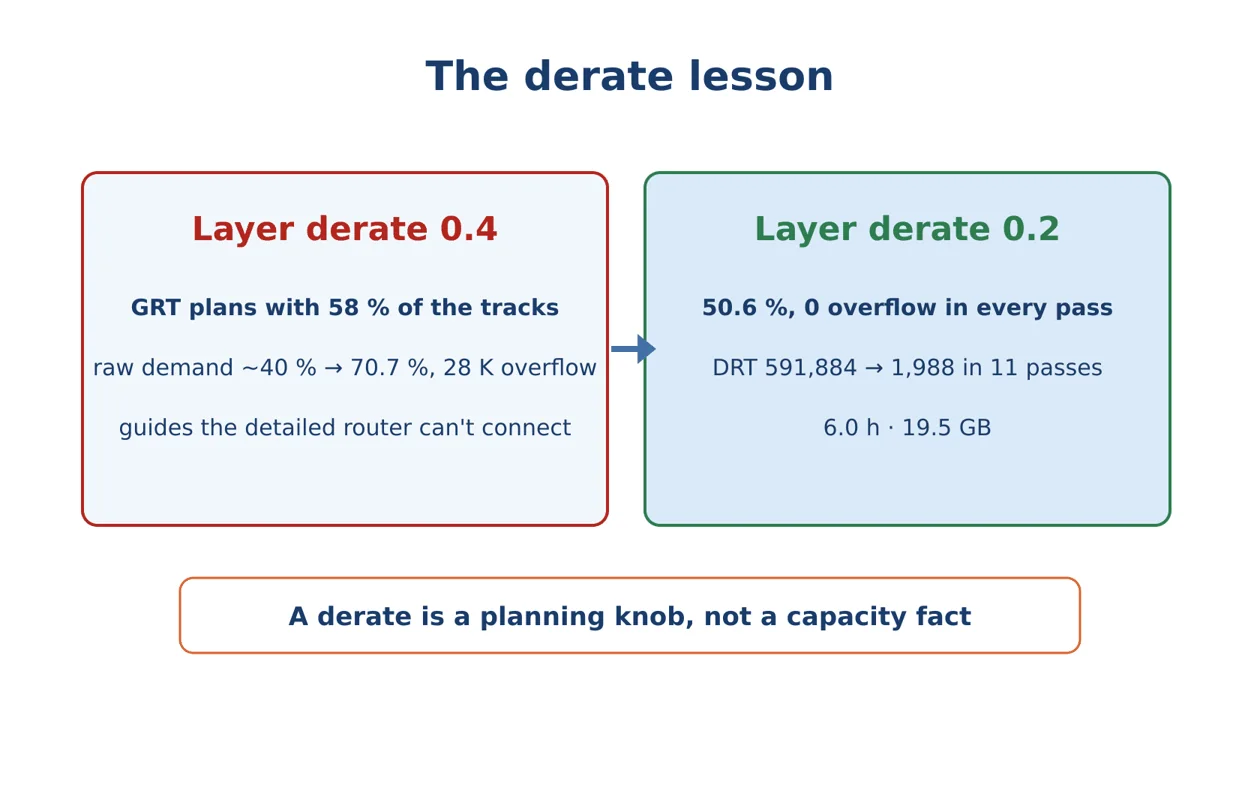
진짜 해결책은 숫자 하나였습니다. 글로벌 라우터가 트랙의 58%만으로 계획하고 있었기 때문에, 존재하지 않는 오버플로를 보고하고 상세 라우터가 쓸 수 없는 가이드를 만들었습니다. 층 디레이트를 0.2로 설정하자 글로벌 라우팅의 오버플로가 0이 되었고, 상세 배선은 첫 패스 후 위반 591,884개에서 열한 번째 패스 후 1,988개로 줄었습니다. 그 배선에는 여섯 시간이 걸렸습니다.
나머지 여덟 개, 그리고 클록 변경 하나
나머지 블록 여덟 개는 더 쉬웠습니다. 아홉 개 전체의 배치 배선에 약 20시간이 걸렸습니다. 아래 그림에 아홉 블록의 결과를 정리했습니다. 음수 슬랙은 블록의 입출력 예산과 작은 홀드 미달이며, 코어 로직의 실패가 아닙니다. 예를 들어 flash_ctrl의 −38.1 ns는 입력에서 출력으로 가는 경로이고, reg2reg 슬랙은 +26.8 ns입니다.
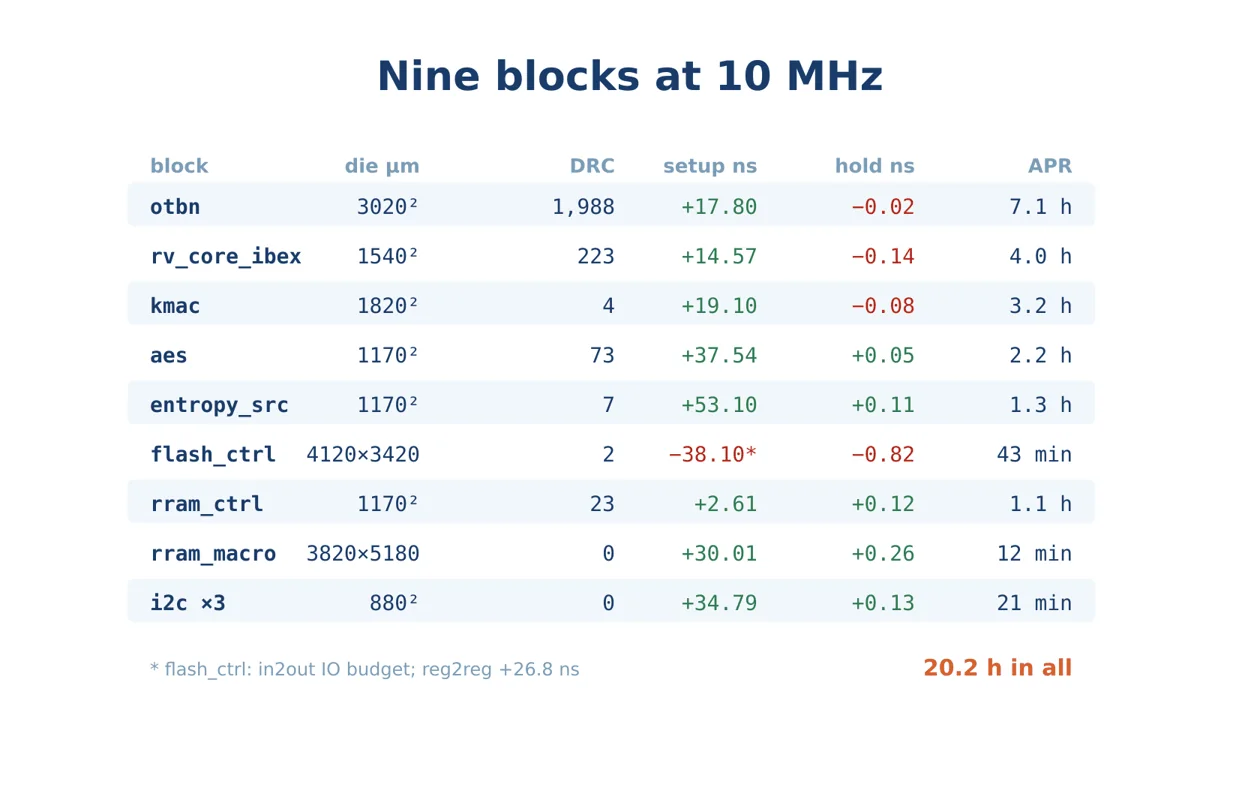
블록 중 일곱 개는 칩 클록을 10 MHz로 정하기 전에 배선되었습니다. G2에서 클록은 게시된 제약 조건 버전의 일부이므로, G2 단계 하나가 배선된 블록들의 타이밍을 새 클록에서 다시 분석했습니다. 배치나 배선을 다시 한 것은 없습니다.
배선된 블록을 IP로
배선된 블록은 세 가지 뷰를 통해 재사용 가능한 IP가 되며, 모두 finish 단계에서 출력됩니다.
- abstract LEF: 외곽, 핀, 막힌 영역.
- 두 코너(ss 1.60 V와 ff 1.95 V, 둘 다 100 °C)의 타이밍 모델.
- 포트만 있는 블랙박스 Verilog 스텁.
함정이 하나 있었습니다. OpenROAD의 abstract 출력기는 블록 안의 모든 전원 도형을, 이를 잇는 비아 없이 핀 형상으로 내보냈습니다. 한 단계 위에서는 이 핀들이 떠 있게 됩니다. 저희는 최상위 스트랩만 전원 핀으로 남겼습니다. 블록은 메탈 1부터 7까지를 쓰고, 톱 레벨은 그 위로 배선합니다.
 2:05
YouTube에서 보기(영어) ↗Bilibili에서 보기(중국어) ↗
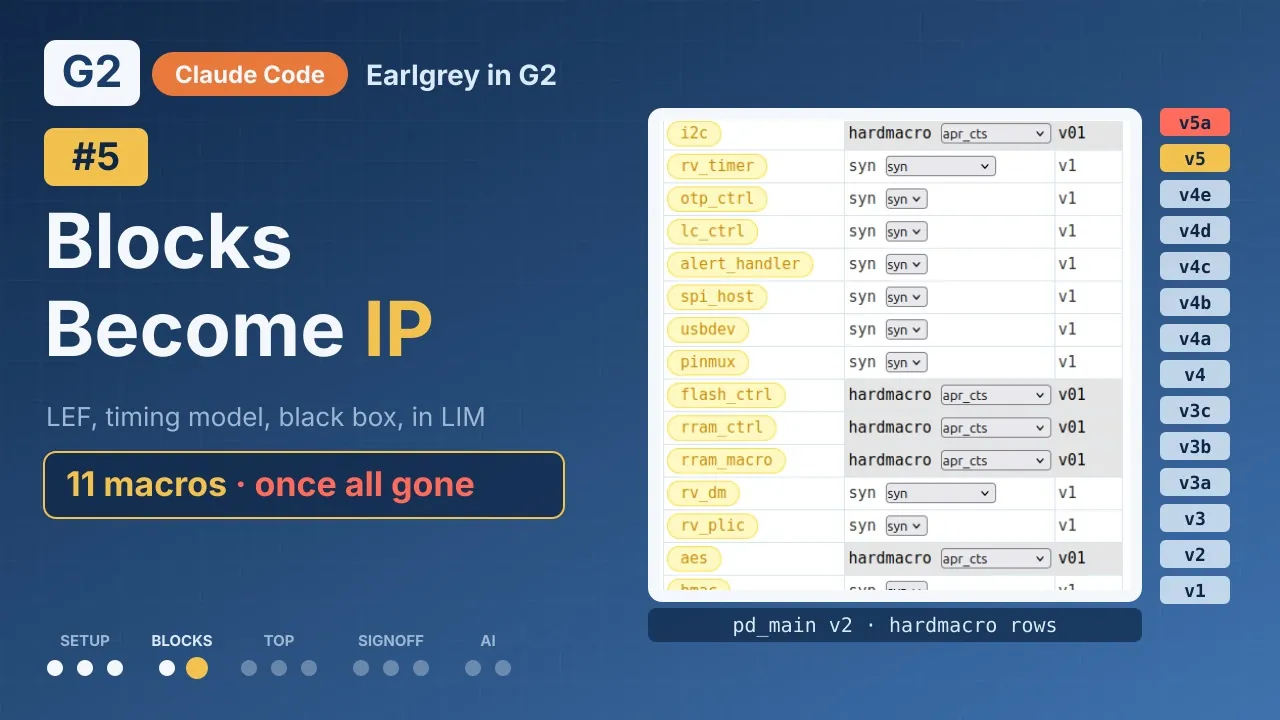
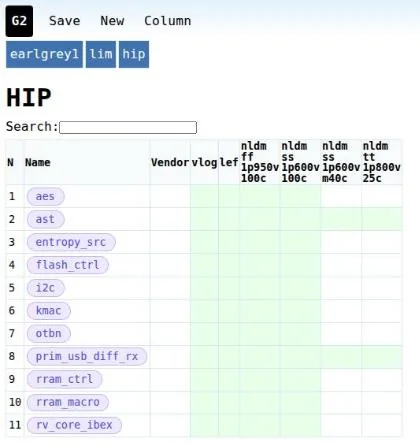
G2에서 이 뷰들은 하드 IP로 라이브러리 관리자에 들어갑니다. 벤더의 IP처럼 블록마다 버전 하나, 코너마다 liberty 파일 하나입니다. 항목은 11개로, 블록 9개와 OpenTitan의 아날로그 스텁 두 개(ast와 USB 차동 수신기)입니다.
톱 레벨에서는 블록마다 한 줄이 그 블록을 어떻게 다룰지 정합니다. 합성 행은 블록을 로직으로 유지합니다. hardmacro 행은 블랙박스를 가져오고, OpenROAD가 그 레이아웃과 타이밍을 라이브러리에서 읽습니다. 주 전원 도메인에는 하드 매크로 행이 아홉 개 있으며, i2c는 한 행에 인스턴스 세 개입니다.
모든 리포트가 "괜찮다"고 한 버그
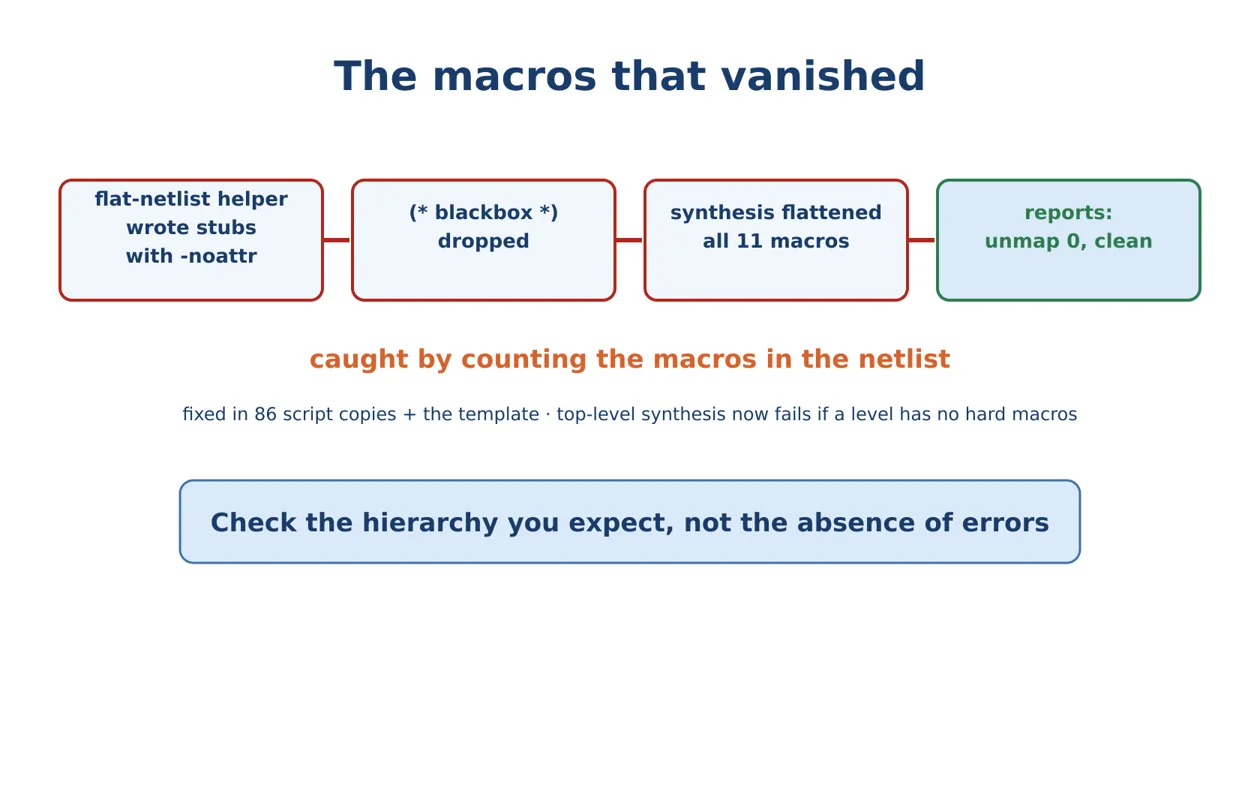
한번은 매크로 11개가 모두 사라졌는데도 모든 리포트가 깨끗해 보였습니다. 평탄화된 넷리스트를 쓰는 도우미가 블랙박스 속성을 빠뜨렸고, 그래서 합성이 매크로를 평탄화해 없애 버린 뒤 매핑되지 않은 셀 0개를 보고했습니다. 이는 보통 성공을 뜻합니다.
넷리스트의 매크로 수를 세어서 잡아냈습니다. 이제는 하드 매크로가 있어야 할 레벨에 하나도 없으면 흐름이 실패합니다. 교훈은 이렇습니다. 오류가 없다는 것만 확인하지 말고, 기대하는 계층이 있는지 확인하세요.
결과
새 톱 레벨은 인스턴스가 113만 개가 아니라 529,205개였고, 몇 시간 만에 배치되었습니다. 실행 시간 문제는 해결되었습니다. 배선은 아직 해결되지 않았습니다. 다음 편에서 첫 톱 레벨 배선 검사가 오버플로 트랙 122만 개를 보여 주었고, 그것이 어디서 오는지 찾아야 했습니다.