
2편이 끝났을 때 칩은 계층 구조였습니다. 하드닝한 블록 9개, 인스턴스 11개, 그리고 25시간 대신 약 3시간에 배치되는 529,205개 인스턴스의 톱 레벨입니다. 이 글은 다음 문제인 톱 레벨 배선과, 그 대부분을 해결한 방법에 관한 것입니다.
첫 배선 검사는 시작도 전에 멈췄습니다
칩 v2에는 손으로 만든 플로어플랜이 있었습니다. 하드닝한 블록을 8.6 mm 코어의 가장자리를 따라 두고, 메모리를 가운데에 한 줄로 놓고, 블록 사이에 톱 레벨 로직을 위한 채널을 두었습니다. 계층 구조는 실행 시간을 해결했습니다. repair_design은 22.5시간 대신 약 2시간이 걸렸습니다. 하지만 이제 톱 레벨 셀이 좁은 채널에 들어가 있었고, 배치기의 혼잡도 추정은 플랫 칩보다 나빴습니다.
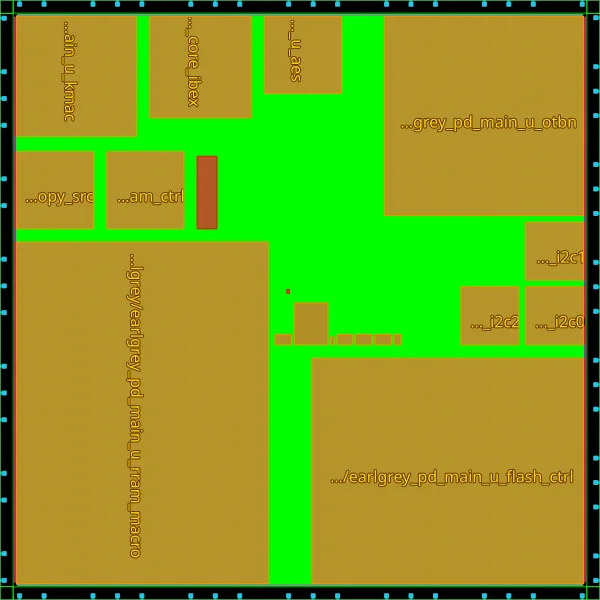
그다음 글로벌 라우팅 검사가 핀 접근에서 멈췄습니다. 메모리 핀 하나에 합법적인 접근 지점이 없었습니다. 메모리 LEF 18개 중 4개는 핀이 매크로 바깥으로 최대 59 µm까지 나가 있었습니다. G2에서 새 메모리 라이브러리 버전으로 이를 고쳤습니다. 같은 핀이 다시 실패했습니다. 배선 금지 영역보다 0.08 µm 위에 있었던 것입니다. 이를 위해 라이브러리 버전이 하나 더 필요했습니다. 플랫 칩은 두 버그 모두를 발견할 만큼 진행하지도 못했습니다.
 2:10
YouTube에서 보기(영어) ↗Bilibili에서 보기(중국어) ↗
처음부터 다시 하지 않고 수정 시험하기
두 번째 수정을 시험하려고 칩을 다시 배치하지 않았습니다. 작은 테스트 버전(v3b)이 배치된 설계를 읽기 전용으로 링크하고, 메모리 하나를 메모리상에서 패치한 뒤 글로벌 라우팅 검사만 실행했습니다. 먼저 3시간 배치를 하는 대신 28분이 걸렸습니다. G2에서 이는 자체 단계 디렉터리와 README가 있는 또 하나의 버전일 뿐이므로, 이 지름길도 다른 실행과 마찬가지로 기록에 남습니다.
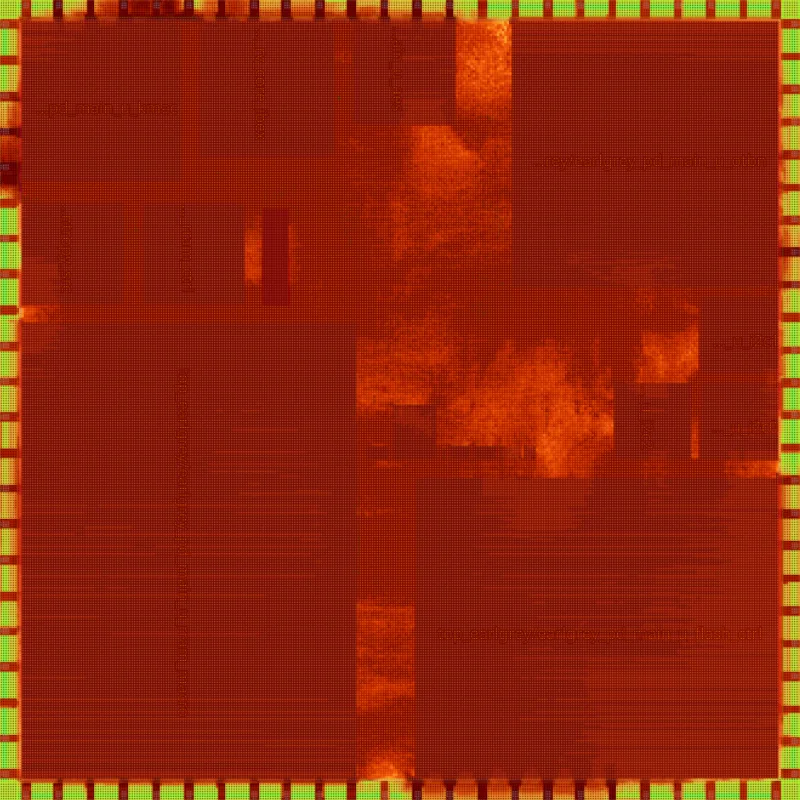
판정: 오버플로 트랙 1,217,748개, 전체가 빨간색이었고, 가장 큰 블록이 배선될 때의 오버플로의 약 43배였습니다.
빠져나갈 길 네 가지, 싼 것부터
선택지 네 개를 적었습니다.
- A. 글로벌 라우팅 설정 하나 바꾸기(otbn을 고친 층 디레이트): 30분짜리 시험.
- B. 채널이 더 넓은 더 큰 코어.
- C. 톱 레벨에서 블록의 핀 배치하기.
- D. 블록을 더 하드닝하기.
가장 싼 것부터 시도했습니다. A는 오버플로를 3분의 1 줄여 749,885로 만들었습니다. 9.6 mm 코어의 B는 4분의 3을 줄여 176,749로 만들었습니다. 그래도 otbn이 배선될 때의 여섯 배였습니다.
하지만 숫자가 유용한 것을 말해 주었습니다. 평균 트랙 수요는 22%에 불과했는데 수평 층이 오버플로되었습니다. 이 패턴은 칩이 너무 작은 것이 아니라 국소적인 핫스폿이 있다는 뜻입니다. 다음 질문은 그것이 어디에 있느냐였습니다.
1단계: 측정
테스트 버전(v4a)이 v4의 배치된 설계를 링크하고 추가 단계 하나, 프로브를 실행했습니다. 15초 동안 1.6 GB로 혼잡한 모든 넷의 끝점, 모든 블록 핀, 모든 셀을 출력했습니다. 그 README에는 오버플로가 어디서 오는지, 어떤 넷이 원인인지, 다음에 무엇을 시도할지가 적혀 있습니다.
 2:20
YouTube에서 보기(영어) ↗Bilibili에서 보기(중국어) ↗
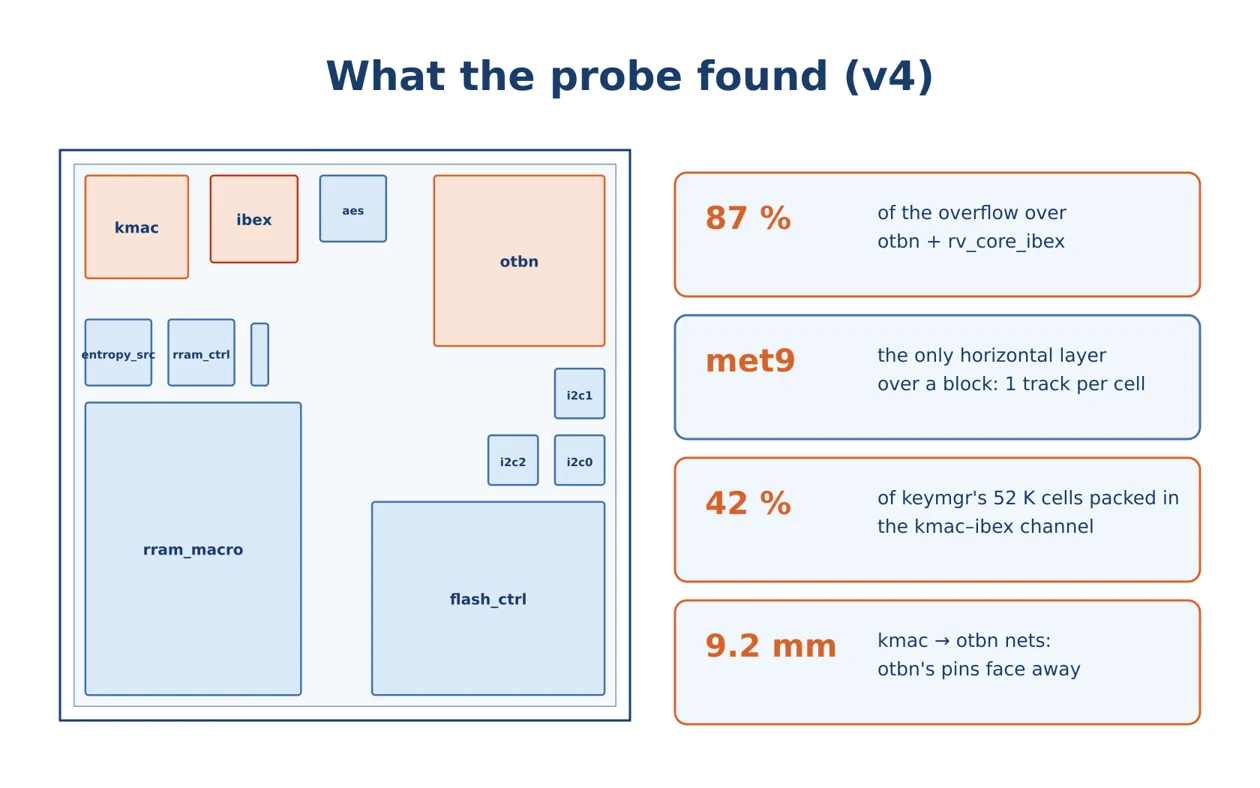
프로브가 찾은 것:
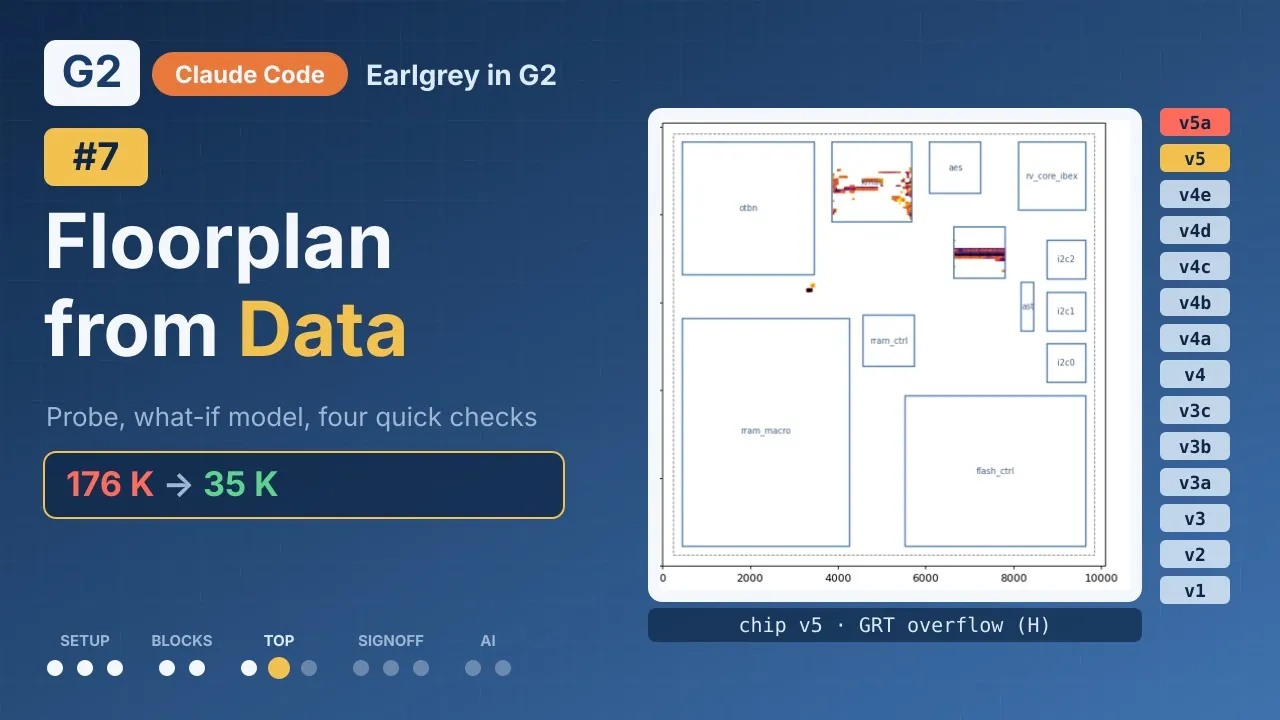
- 오버플로의 87%가 두 블록 위에 있었습니다: otbn(40%)과 Ibex 코어(39%)였고, 85%가 수평 방향이었습니다.
- 하드 블록 위에서는 수평으로 지나가는 층이 하나뿐이며(저희 스택에서는 메탈 9), 배선 그리드 셀마다 트랙이 하나입니다. 블록을 수평으로 가로지르는 톱 레벨 배선은 모두 그 한 트랙을 놓고 경쟁합니다.
- 키 매니저 로직(셀 51,757개)이 kmac과 Ibex 코어 사이의 400 µm 채널에 몰려 있었습니다. 42%가 그 한 채널에 있었습니다.
- otbn의 핀이 kmac 반대쪽을 향하고 있어서, kmac에서 otbn으로 가는 일부 넷은 9 mm가 넘었습니다.
2단계: EDA 실행 없이 모델로 후보 순위 매기기
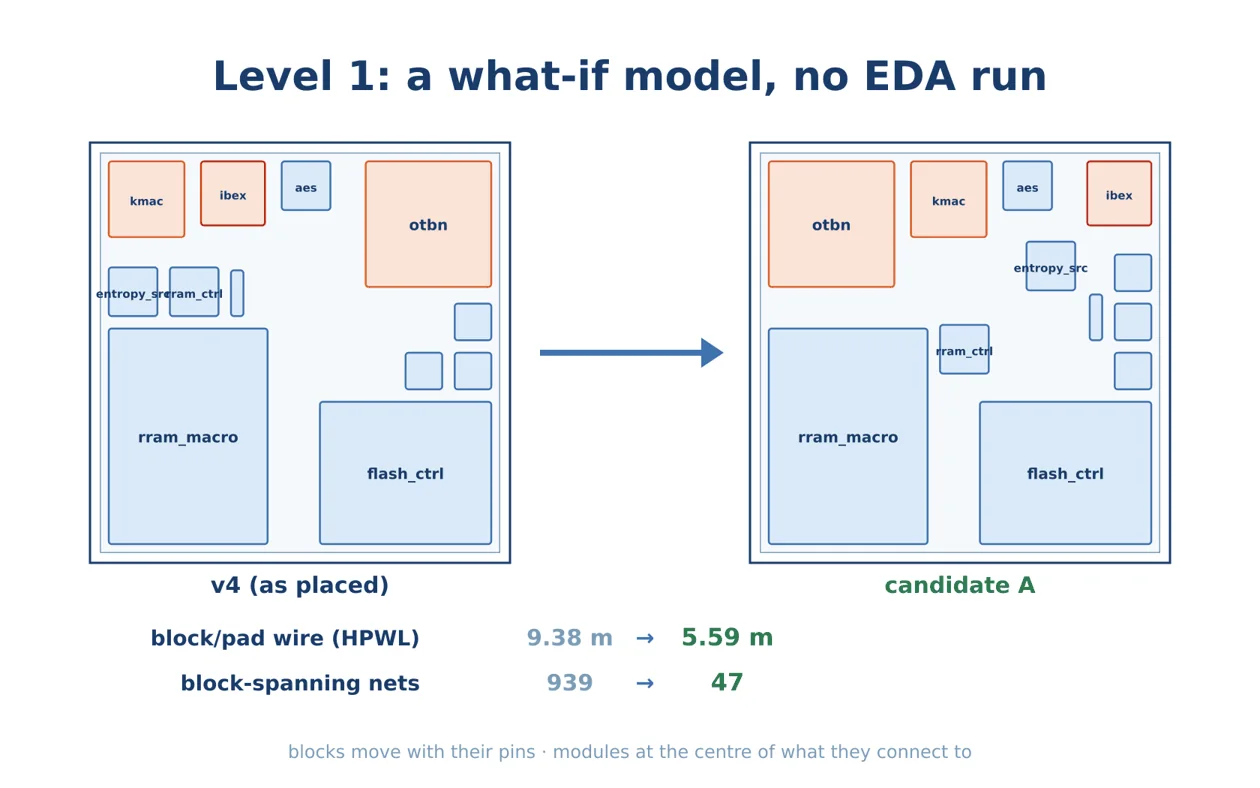
"레벨 1" 모델은 EDA 실행이 아니라 간단한 가정 분석 스크립트입니다. 블록을 핀과 함께 옮기고, 각 톱 레벨 모듈을 연결 대상의 중심에 두고, 배선량을 추정합니다. 후보 A는 otbn을 모서리에 두고 그 옆에 kmac을 놓았으며, 큰 매크로 두 개를 미러링하고 가운데를 비워 두었습니다. 추정 블록 간 배선은 9.38 m에서 5.59 m로 줄었고, 블록을 가로지르는 넷 수는 939개에서 47개로 줄었습니다.
3단계: 짧은 실제 실행으로 상위 후보 확인
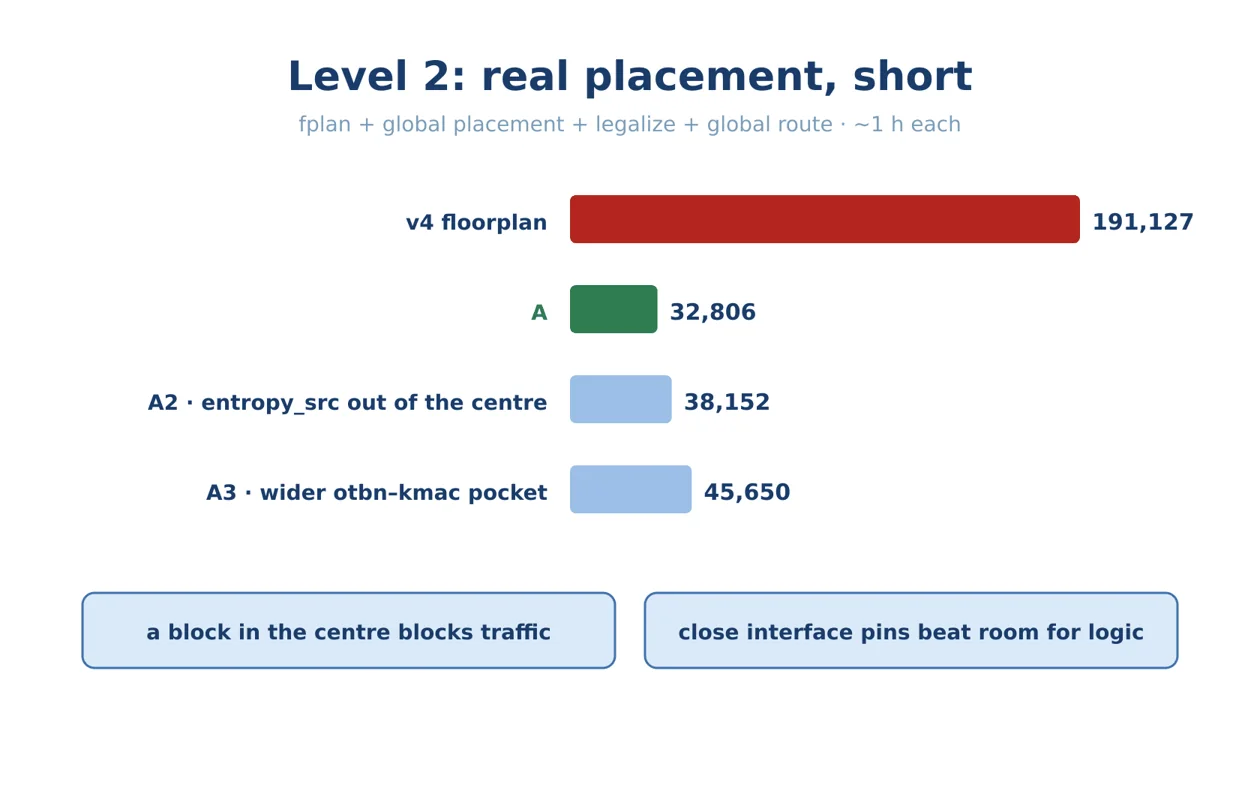
"레벨 2"는 실제이지만 짧습니다. 글로벌 배치, 합법화, 글로벌 라우팅 검사로 후보당 약 한 시간이 걸리며, 각각 자체 테스트 버전입니다.
| 후보 | 바뀐 점 | GRT 오버플로 |
|---|---|---|
| v4c | 기존 플로어플랜, 같은 짧은 흐름(기준) | 191,127 |
| A | otbn을 kmac 옆 모서리에, 가운데 비움 | 32,806 |
| A2 | A의 변형 | 38,152 |
| A3 | A의 변형 | 45,650 |
두 변형도 가르쳐 준 것이 있습니다. 가운데에 있는 블록은 통행을 막고, 인터페이스 핀을 가깝게 두는 것이 로직에 공간을 더 주는 것보다 낫습니다.
4단계: 전체 실행
그다음 후보 A를 칩 v5로 실제로 배치했습니다. 예측이 맞았습니다. 오버플로 트랙 34,639개(v4 대비 −80%), 평균 수요 17%, 배선 22% 감소(103.0 m → 80.1 m)였습니다.
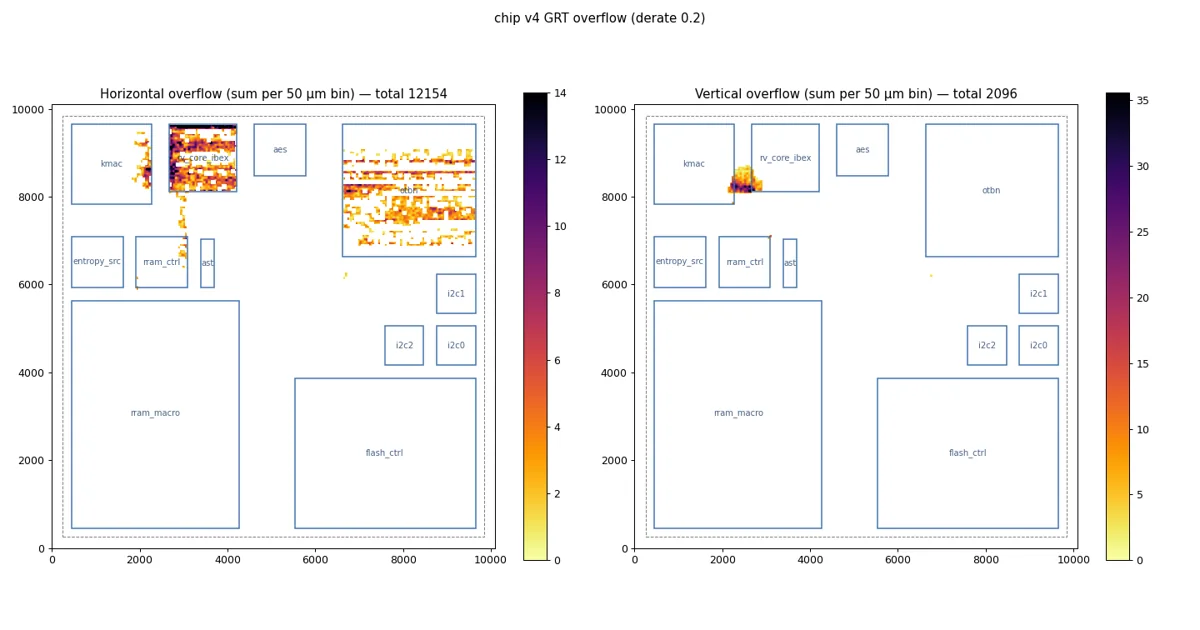
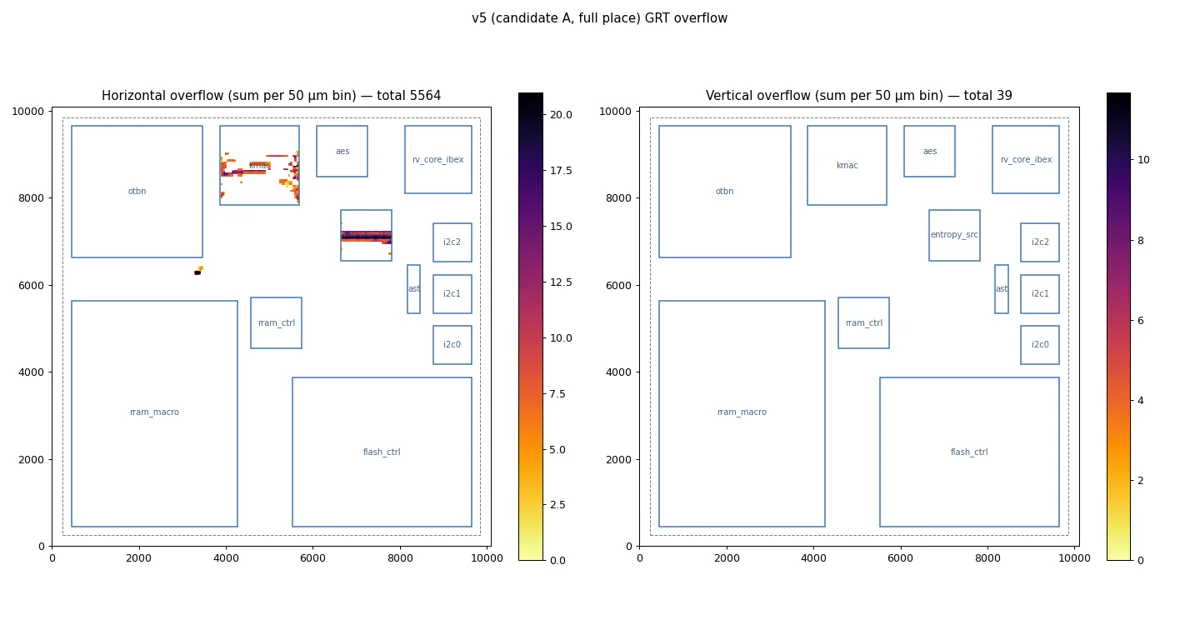
남은 것은 kmac(59%)과 entropy_src(35%) 위의 두 띠였고, 대부분 kmac으로 들어가는 키 매니저의 버스였습니다. 이는 가장 큰 블록이 배선되었던 수준 정도였기 때문에 배선하기로 했습니다. 모델에도 한계가 있습니다. 모듈을 약 1 mm 정도 어긋나게 배치하므로, 레벨 2 검사가 진짜 시험입니다.
전체 방법은 한 줄로 요약됩니다. 측정하고, 순위를 매기고, 확인한 다음, 실행합니다. 싼 단계부터.
칩 배선: 26시간, 그리고 예측이 놓친 것
배치 다음에는 클록 트리 합성, 그 수리, 배선, 포스트 라우트, 피니시가 이어졌습니다. 서류상으로는 여섯 단계입니다. 실제로는 스무 번의 시도가 필요했고, 대부분 메모리 때문이었습니다. (그 이야기는 6편에 있습니다.)
 2:09
YouTube에서 보기(영어) ↗Bilibili에서 보기(중국어) ↗
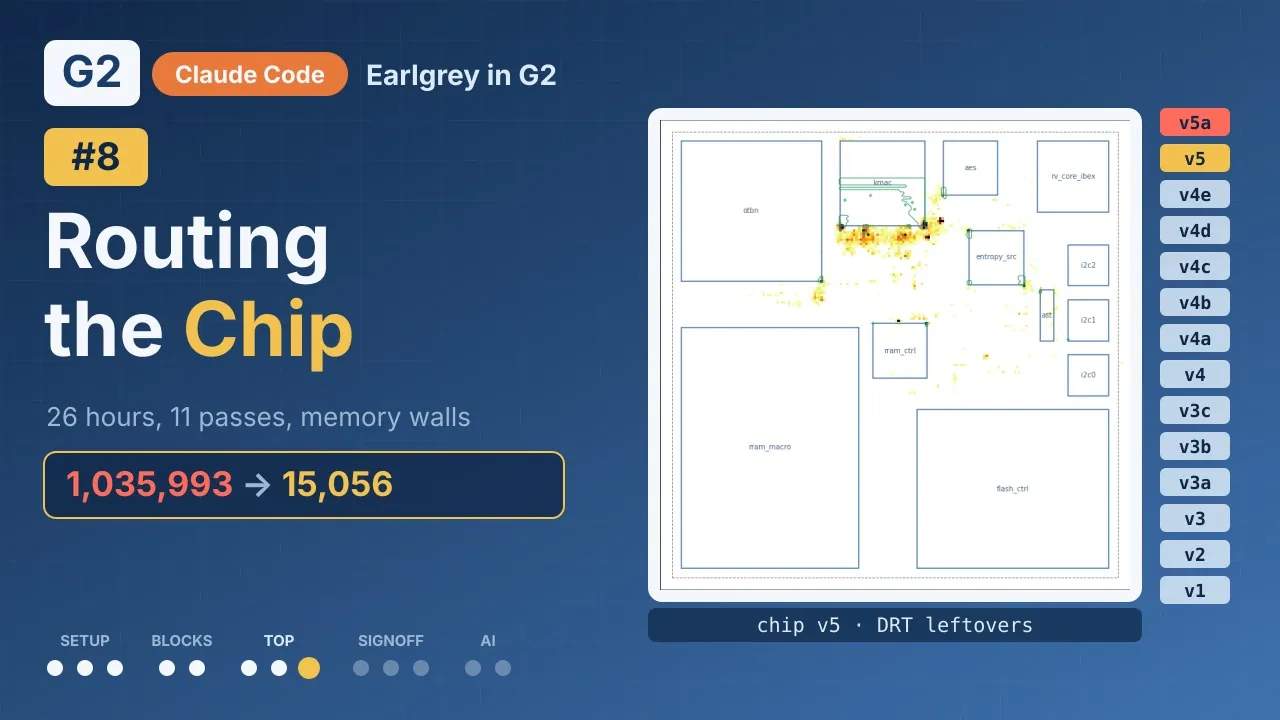
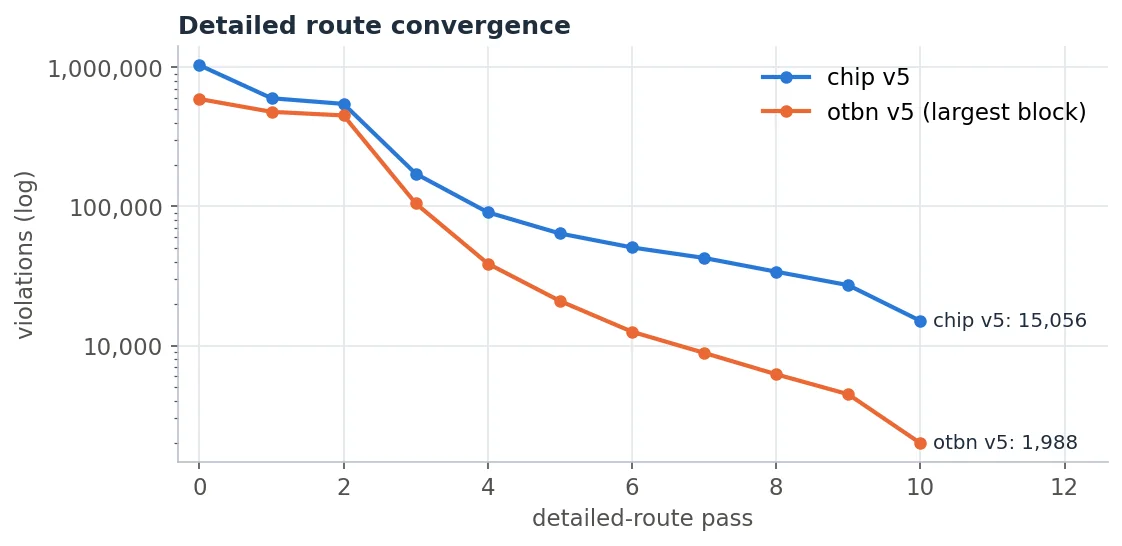
상세 배선은 11번의 패스로 26시간 동안 실행되었고, 첫 패스 후 위반 1,035,993개에서 마지막 패스 후 15,056개가 되었습니다. 처음 세 패스 동안 칩은 블록과 비슷하게 움직였습니다. 3번째 패스에서 블록의 위반은 4~20배 줄었지만 칩의 위반은 3.2배밖에 줄지 않았습니다. 그 뒤로는 패스마다 시간은 더 걸리고 줄어드는 양은 더 적었습니다.
남은 위반은 글로벌 라우터가 예고한 곳에 있습니다. 글로벌 라우터는 오버플로의 80%를 kmac 위에서 찾았습니다. 상세 라우터도 그 배선을 넣지 못하고 kmac 바로 남쪽 채널로 밀어냈습니다. 위반의 81%가 2.5 mm² 안에 있습니다.
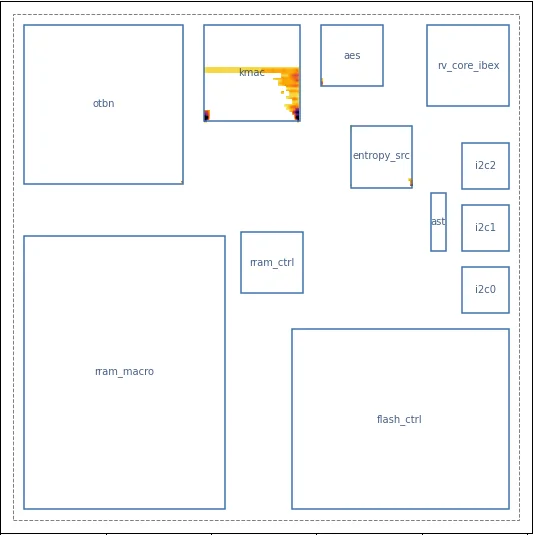
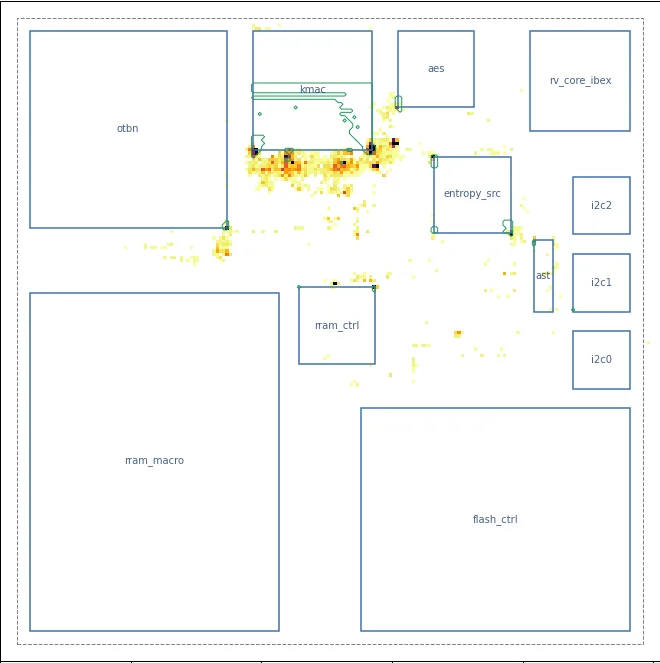
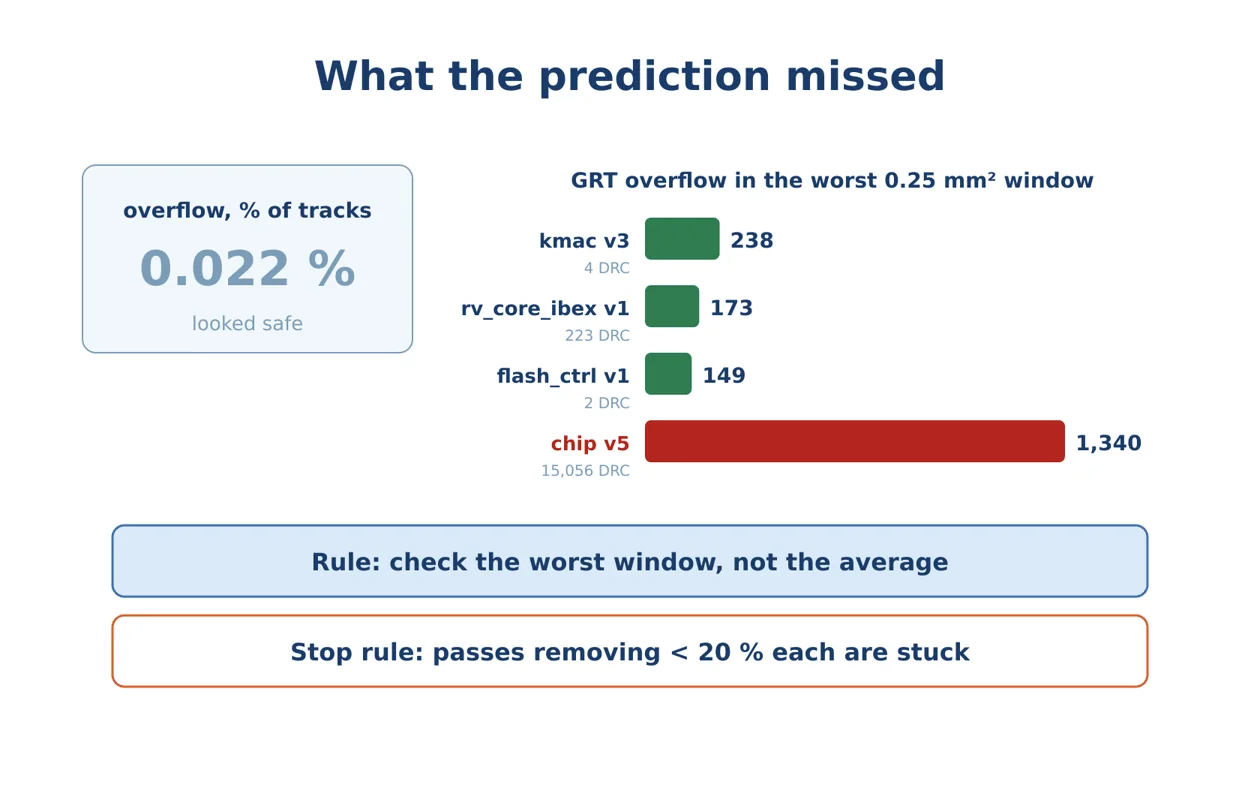
저희 예측은 오버플로가 전체 트랙의 0.022%에 불과하다는 이유로 칩이 배선 가능하다고 판단했습니다. 그것은 잘못된 척도였습니다. 여기서 규칙 두 개가 나왔습니다.
- 전체 합계가 아니라 최악의 작은 창을 보세요. 최악의 0.25 mm² 글로벌 라우팅 창에서 칩은 오버플로 트랙이 1,340개였습니다. 배선에 성공한 블록들은 149~238개였습니다.
- 패스가 정체되면 멈추세요. 상세 배선 패스가 남은 것의 5분의 1도 줄이지 못하면, 패스를 더 돌려도 끝나지 않습니다.
그다음 결정이 필요했습니다. 약 이틀을 더 들여 kmac 주변 플로어플랜을 고칠 것인가, 지금 마무리하고 남은 문제를 기록할 것인가. 이것은 테이프아웃이 아니라 흐름 시연이므로 마무리했습니다. 포스트 라우트와 피니시가 끝났고, 남은 문제는 모두 그 버전의 메모에 있습니다. 배선 전에 최악 창 규칙으로 확인하면서 kmac 채널을 고치는 것이 칩 v6의 첫 번째 항목입니다.
G2가 더한 것
이 모든 단계가 README가 있는 G2 버전이었습니다. 프로브, 네 번의 짧은 검사, 재배치를 피한 읽기 전용 테스트까지입니다. 그 덕분에 이 방법을 따르는 비용이 적었습니다. 데이터, 결정, 다음 단계가 그것을 만든 실행 옆에 남았고, 플로어플랜 선택은 기억이 아니라 숫자로 거슬러 추적할 수 있습니다.
다음: 완성된 칩이 별도 도구에서 사인오프를 거치고, 그것이 OpenROAD의 버그 두 개를 드러냈습니다.