
在第 2 篇的最后,芯片已经是层次化的:九个硬化模块、十一个实例,以及一个有 529,205 个实例的顶层,布局只要大约三小时,而不是二十五小时。这一篇讲下一个问题,也就是顶层的绕线,以及解决了大部分问题的方法。
第一次绕线检查还没开始就停了
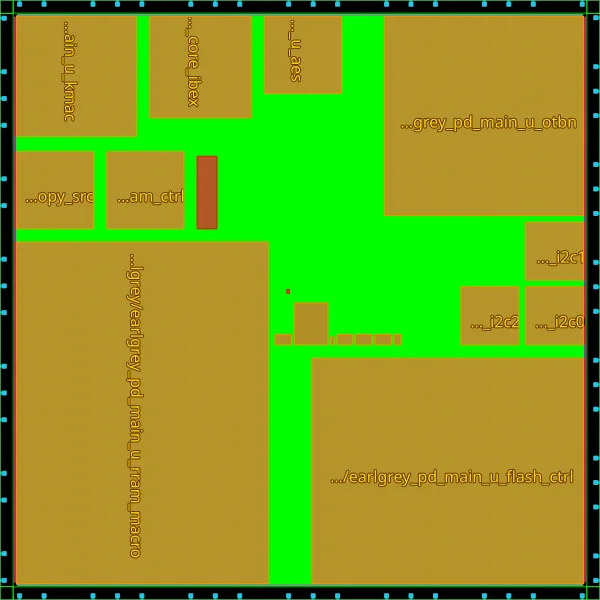
芯片 v2 用的是手动 floorplan:硬化模块沿着 8.6 mm core 的四边摆放,存储器在中间排成一排,模块之间留出通道给顶层的逻辑。层次化解决了运行时间:repair_design 只花了大约 2 小时,而不是 22.5 小时。但是顶层的单元现在挤在很窄的通道里,布局器估计的拥挤度反而比扁平芯片还差。
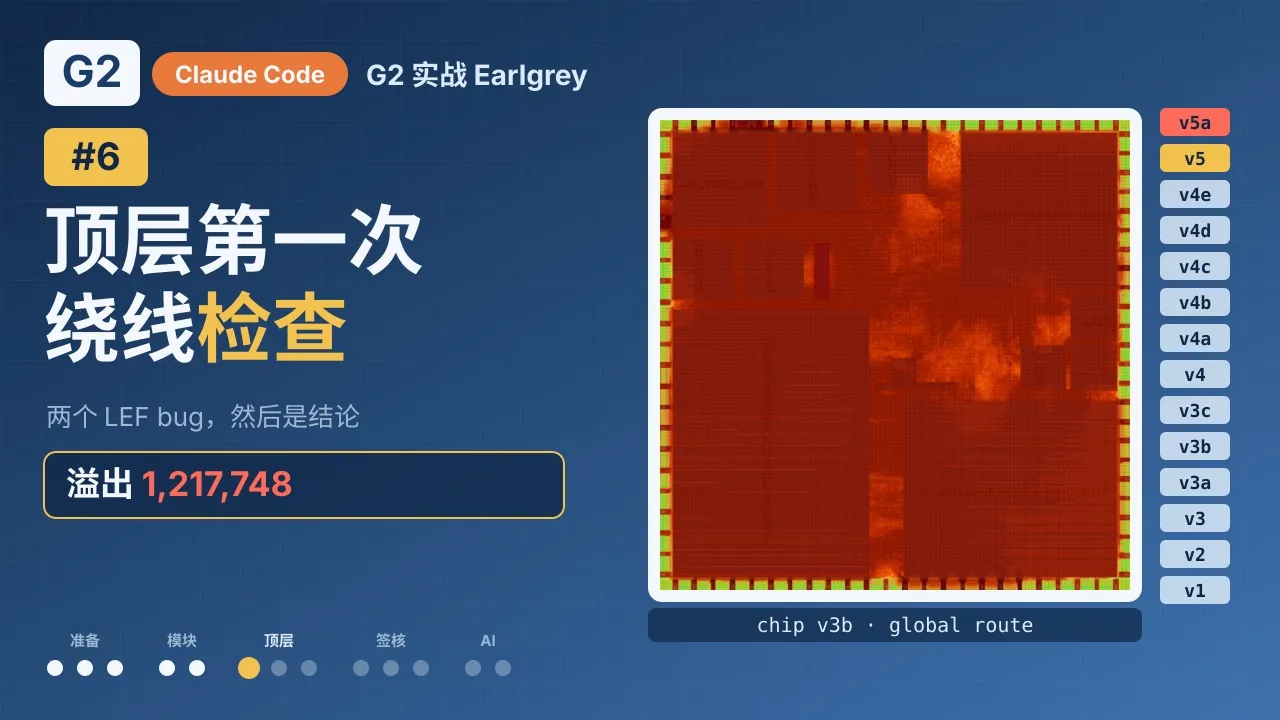
接着,全局绕线检查在 pin 接入这一步就停了:有一个存储器的 pin 没有合法的接入点。十八个存储器 LEF 里,有四个的 pin 跑到 macro 外面最多 59 µm。我们在 G2 里把它们修好,做成新的存储器库版本。同一个 pin 又失败了:它比一个绕线阻挡区高了 0.08 µm。于是又需要第二个库版本。扁平芯片从来没有走到这一步,所以这两个 bug 都没被发现。
 2:13
在 YouTube 观看(英文) ↗在 Bilibili 观看(中文) ↗
不从头来,测试一个修正
为了测试第二个修正,我们没有重新布局芯片。一个小的测试版本(v3b)以只读方式链接已经布好局的设计,在内存里修补那一块存储器,只跑全局绕线检查:28 分钟,而不是先花三小时布局。在 G2 里,这只是另一个版本,有自己的阶段目录和 README,所以这个捷径和其他运行一样都有记录。
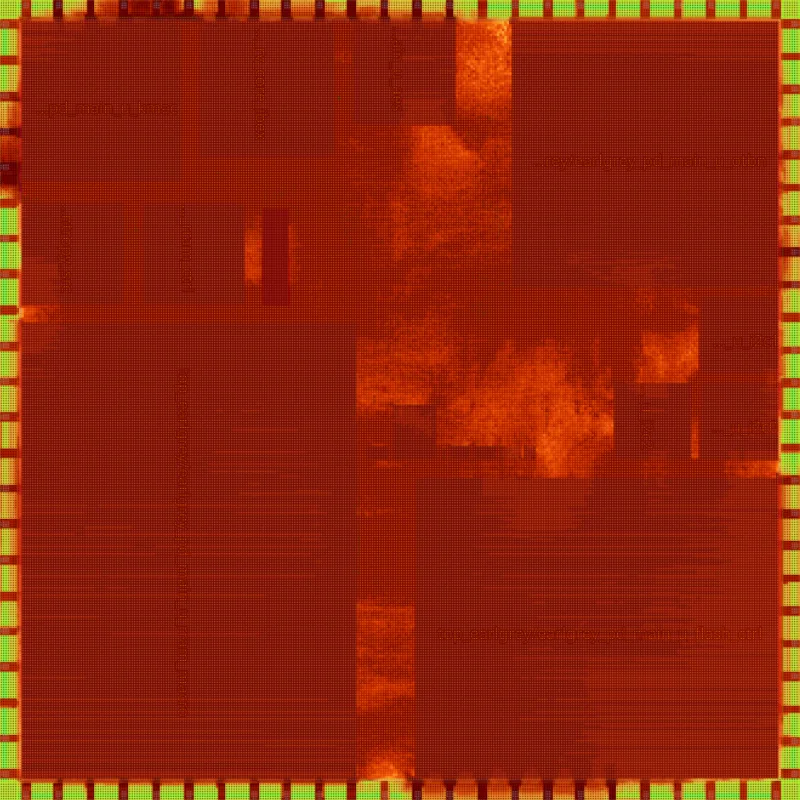
结果是:1,217,748 条溢出的走线,到处都是红的,大约是最大模块能绕通时溢出的 43 倍。
四条出路,最便宜的先试
我们写下了四个选项:
- A. 改一个全局绕线设定(修好 otbn 的那个层降额):30 分钟就能测试。
- B. 更大的 core、更宽的通道。
- C. 从顶层来决定模块 pin 的位置。
- D. 硬化更多模块。
我们先试最便宜的。A 让溢出少了三分之一,降到 749,885。B 用 9.6 mm 的 core,少了四分之三,降到 176,749。这仍然是 otbn 能绕通时的六倍。
不过这些数字透露了有用的信息。平均走线需求只有 22%,横向的金属层却在溢出。这种模式代表局部的热点,而不是芯片太小。下一个问题就是:热点在哪里。
第一步:测量
一个测试版本(v4a)链接 v4 已经布好局的设计,多跑一个阶段,也就是探测。它在 15 秒内、用 1.6 GB 内存,把每条拥挤 net 的端点、每个模块的 pin 和每个单元都导出来。它的 README 说明溢出从哪里来、是哪些 net 造成的,以及下一步可以试什么。
 2:25
在 YouTube 观看(英文) ↗在 Bilibili 观看(中文) ↗
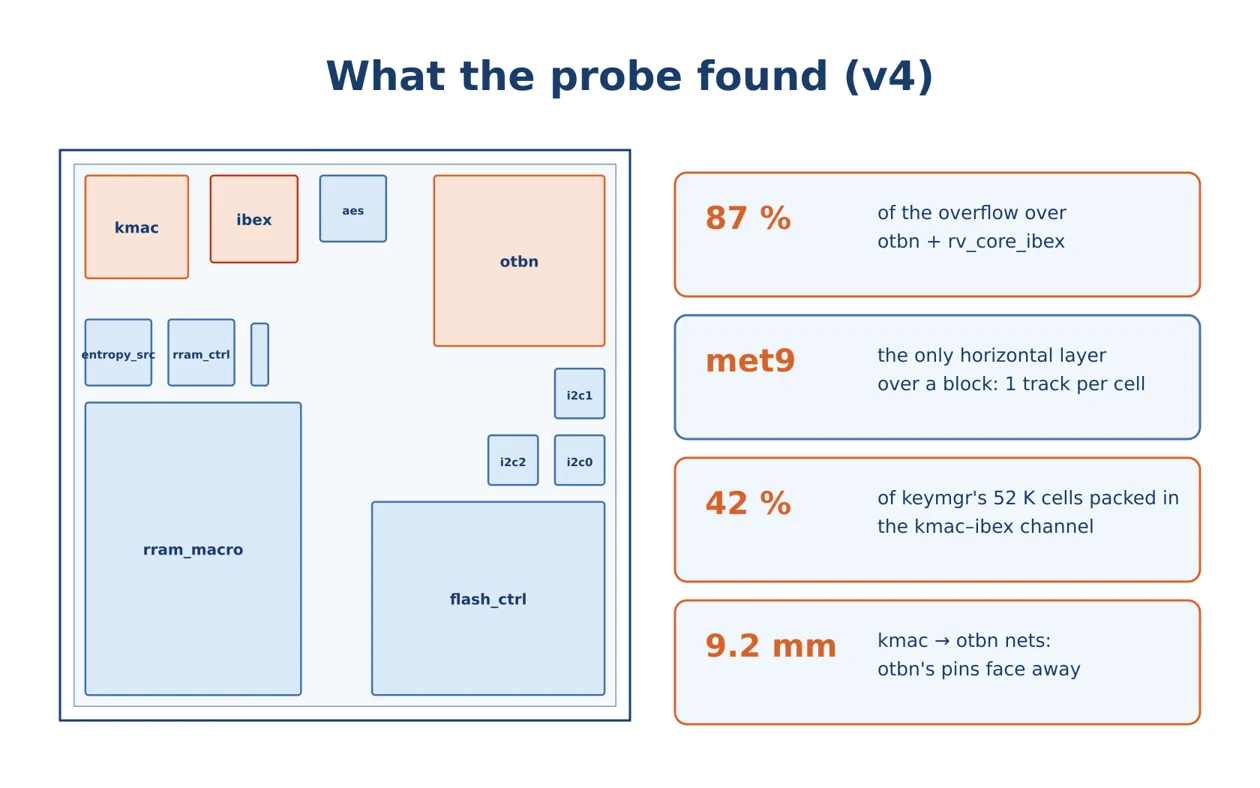
它找到的东西:
- 87% 的溢出在两个模块上方: otbn(40%)和 Ibex 核心(39%),其中 85% 是横向的。
- 在硬模块上方,只有一层金属是横向的(我们的堆叠里是 metal 9),而且绕线网格的每一格只有一条走线。任何横向跨过模块的顶层连线,都在抢这一条走线。
- 密钥管理器的逻辑(51,757 个单元)挤在 kmac 和 Ibex 核心之间 400 µm 宽的通道里:42% 都在这一条通道。
- otbn 的 pin 背对着 kmac,所以有些 kmac 到 otbn 的 net 长达 9 mm 以上。
第二步:不跑 EDA,用模型给候选方案排序
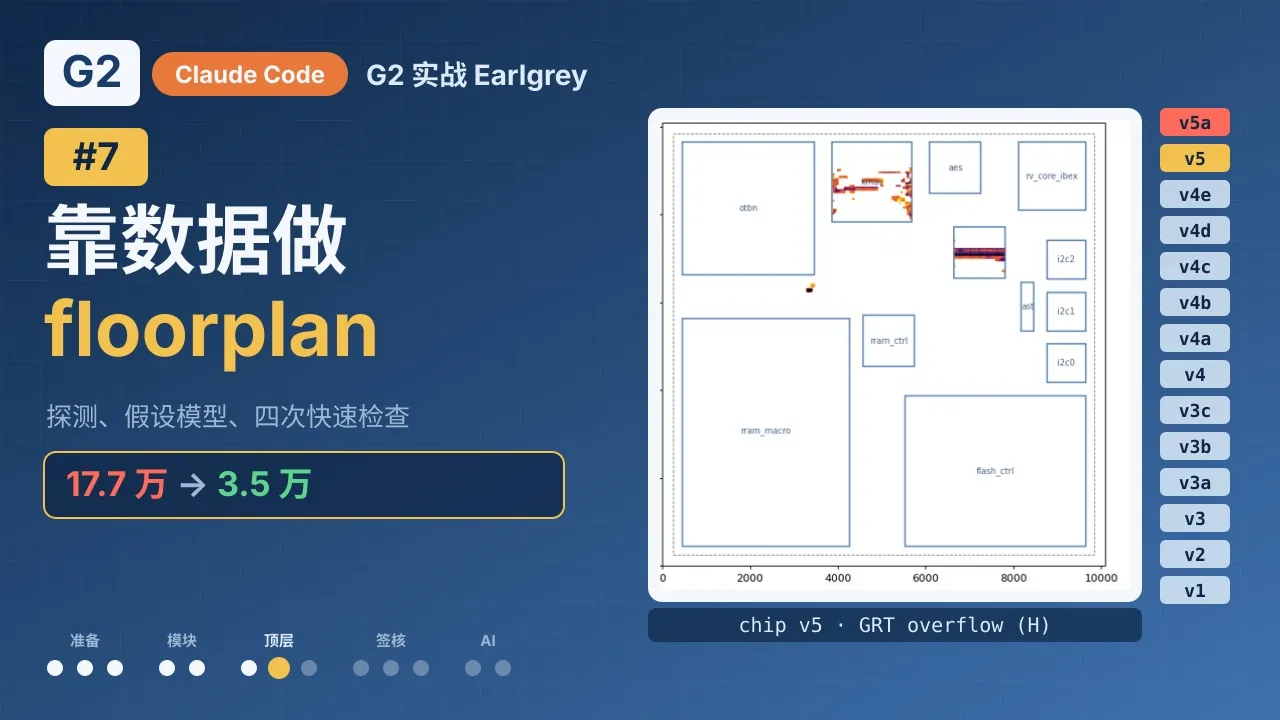
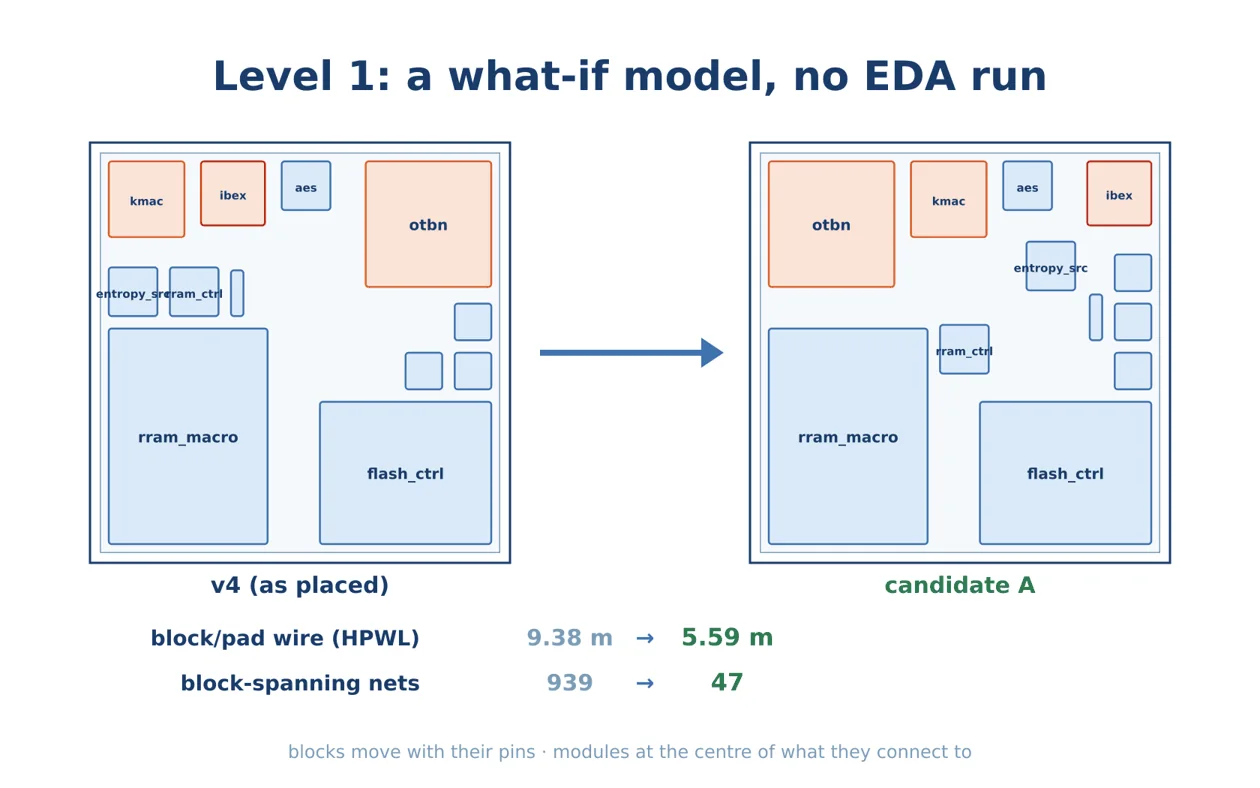
「第一级」模型是一个快速的假设分析脚本,不是 EDA 运行。它移动模块,pin 跟着一起移动,把每个顶层模块放在它所连接对象的中心,然后估算连线。候选方案 A 把 otbn 放在角落、kmac 放在旁边,镜像两个大 macro,并把中间空出来。估计的模块之间连线从 9.38 m 降到 5.59 m,跨过模块的 net 数量从 939 条降到 47 条。
第三步:用很短的真实运行检查最好的候选方案
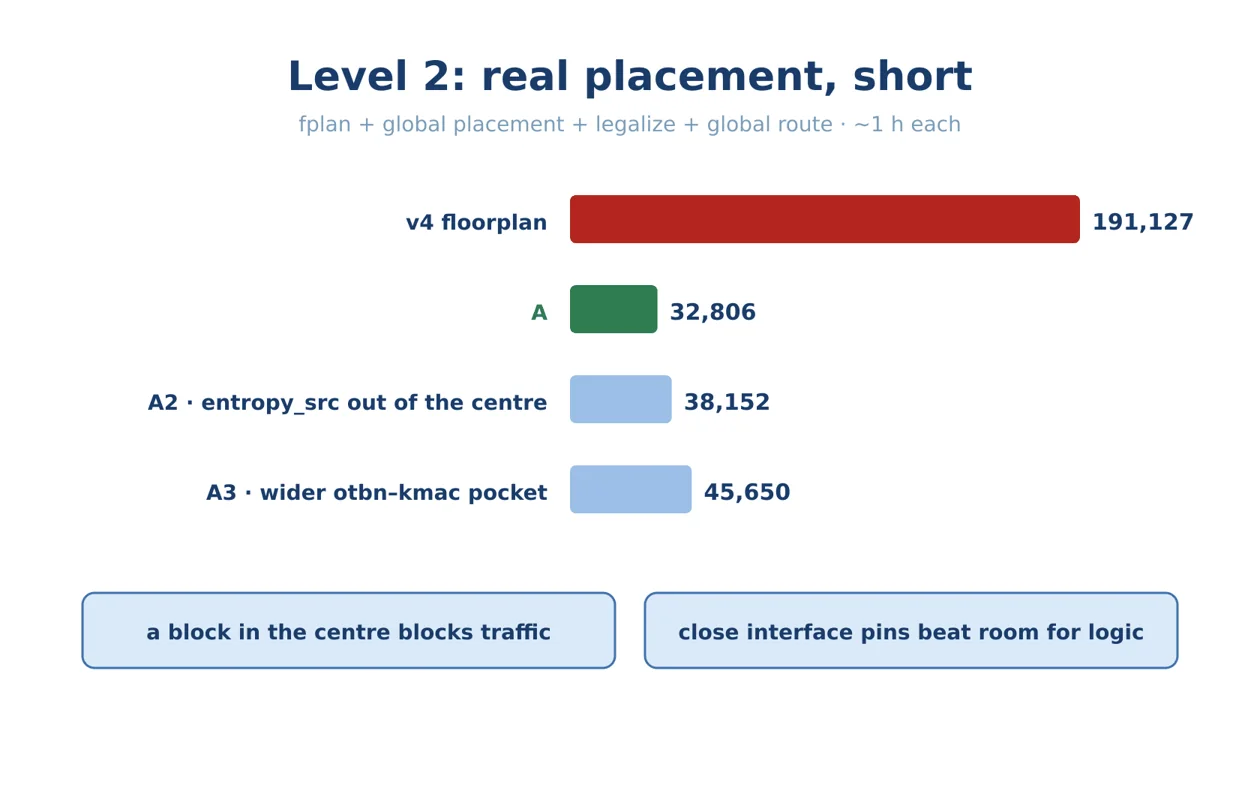
「第二级」是真实的,但很短:全局布局、合法化和一次全局绕线检查,每个候选方案大约一小时,各自是一个测试版本。
| 候选方案 | 改了什么 | GRT 溢出 |
|---|---|---|
| v4c | 原来的 floorplan,同样的短流程(基准) | 191,127 |
| A | otbn 放在角落、kmac 在旁边,中间空出来 | 32,806 |
| A2 | A 的一个变化版本 | 38,152 |
| A3 | A 的一个变化版本 | 45,650 |
两个变化版本也让我们学到东西:放在中间的模块会挡住走线,而让接口 pin 彼此靠近,比给逻辑更多空间更有效。
第四步:完整的运行
接着我们把候选方案 A 真正布局成芯片 v5。预测成立:34,639 条溢出的走线(比 v4 少 80%),平均需求 17%,连线少了 22%(103.0 m → 80.1 m)。
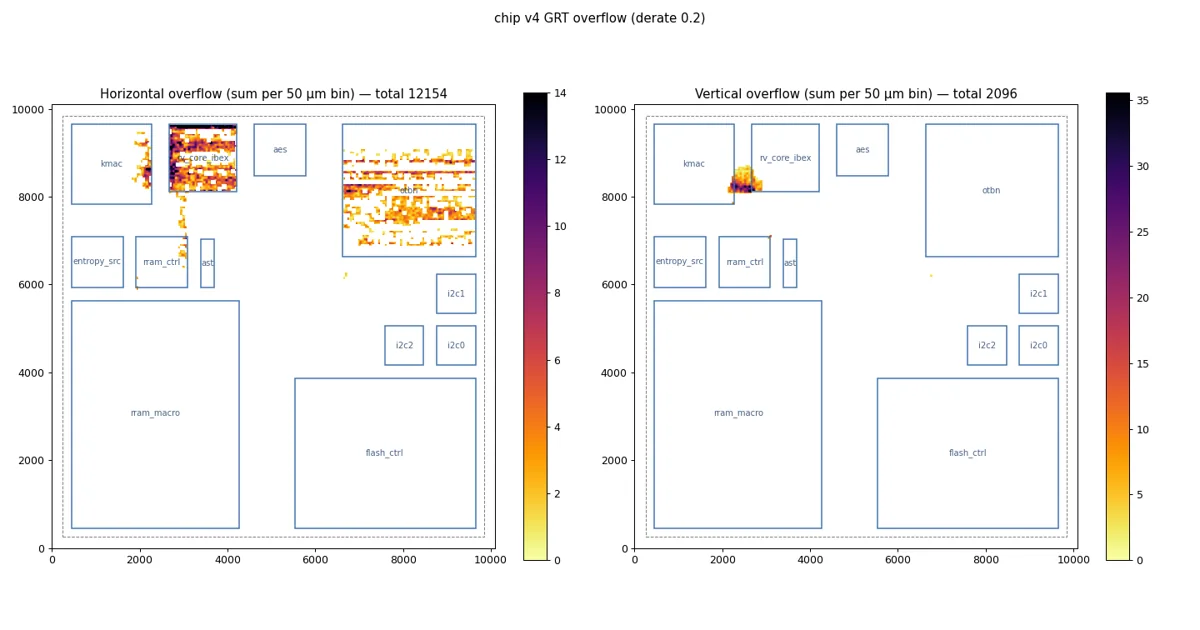
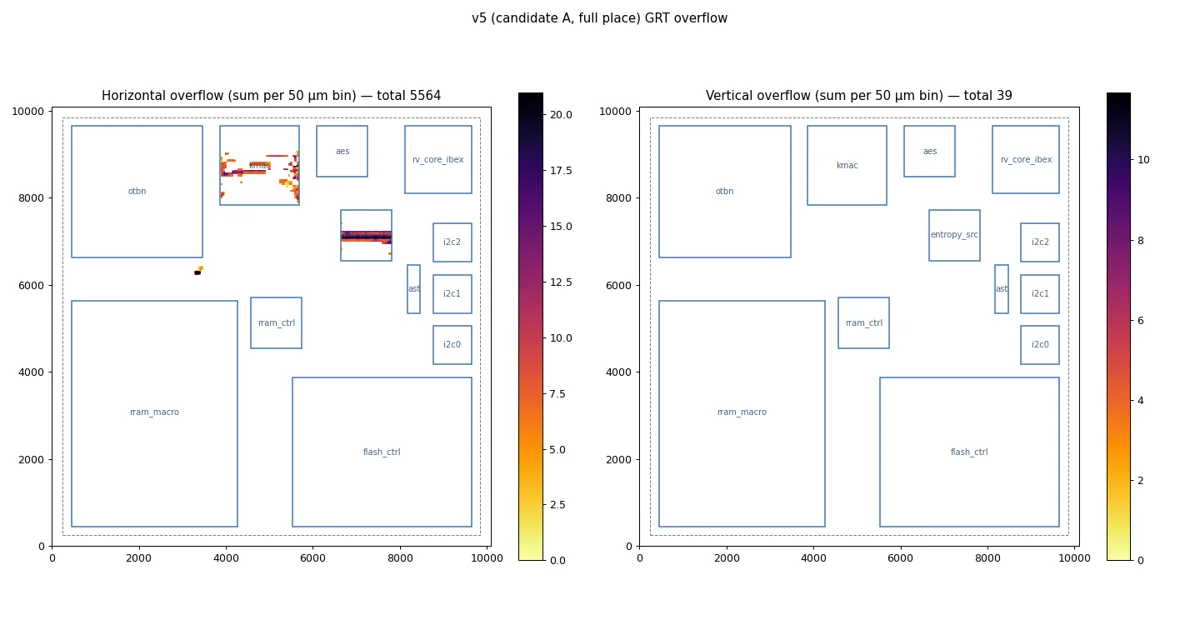
剩下的是两条带状区域,在 kmac(59%)和 entropy_src(35%)上方,主要是密钥管理器连到 kmac 的总线。这大约就是最大模块能绕通的程度,所以我们决定去绕线。模型也有局限:它放置模块的位置大约偏差一毫米,这就是为什么第二级的检查才是真正的测试。
整个方法可以用一句话概括:测量、排序、检查,然后才运行。 便宜的步骤先做。
芯片的绕线:26 小时,以及预测漏掉了什么
布局之后是时钟树综合、它的修复、绕线、绕线后处理和 finish。纸面上是六个阶段。实际上试了二十次,大部分是因为内存。(这个故事在第 6 篇。)
 2:08
在 YouTube 观看(英文) ↗在 Bilibili 观看(中文) ↗
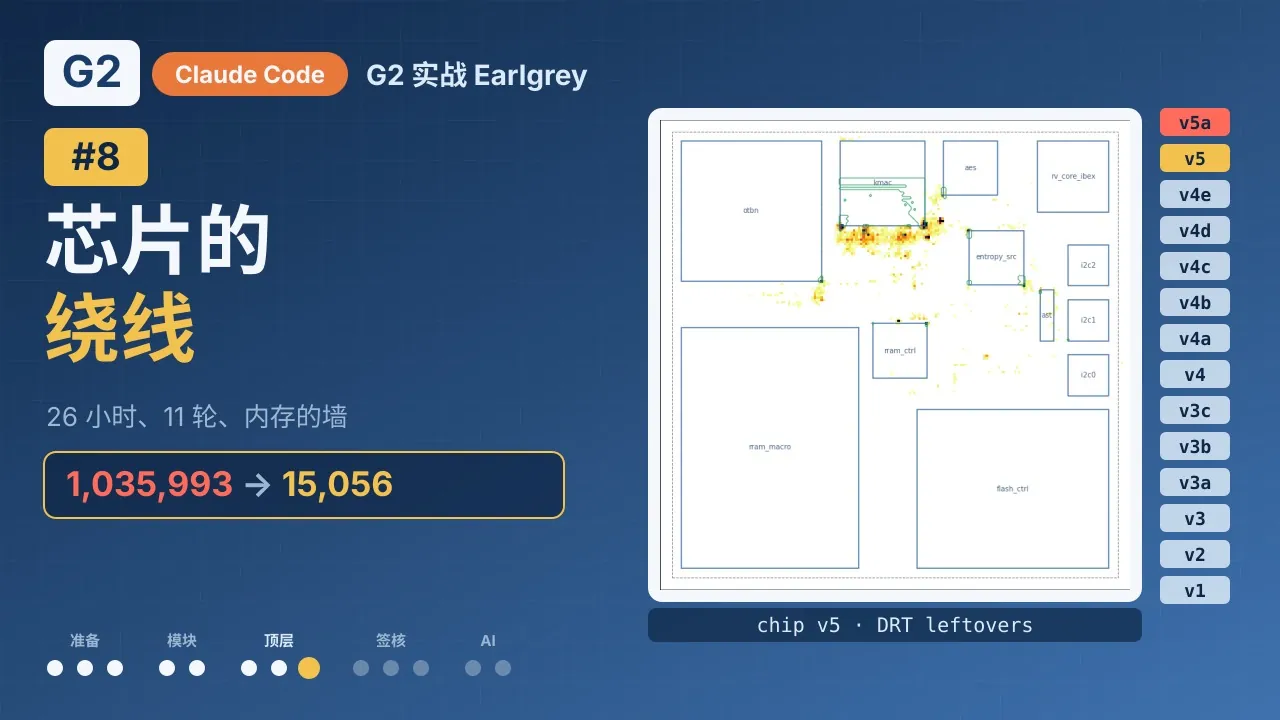
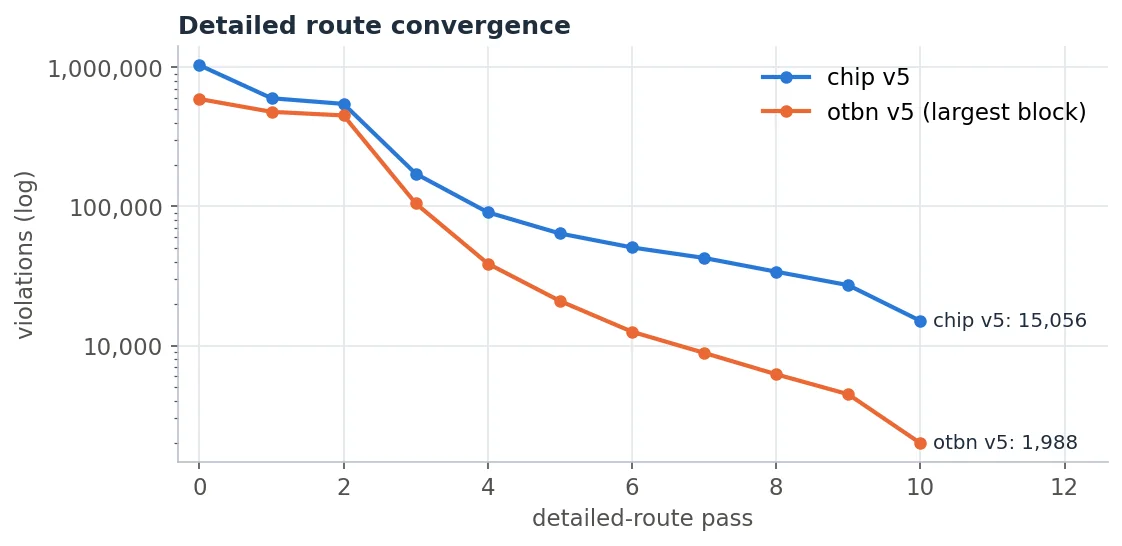
详细绕线跑了 26 小时、11 轮,从第一轮之后的 1,035,993 个违例,降到最后一轮之后的 15,056 个。前三轮,芯片的表现和模块一样。到了第 3 轮,模块的违例会降 4 到 20 倍;芯片只降了 3.2 倍。之后每一轮都更久,清掉的却更少。
剩下的违例,正好在全局绕线器说的地方。它发现 80% 的溢出在 kmac 上方。详细绕线器也塞不下这些线,就把它们推到 kmac 正南边的通道里:81% 的违例集中在 2.5 mm² 里。
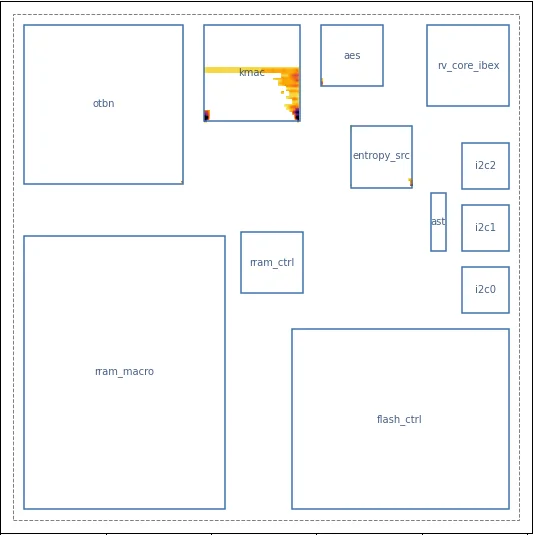
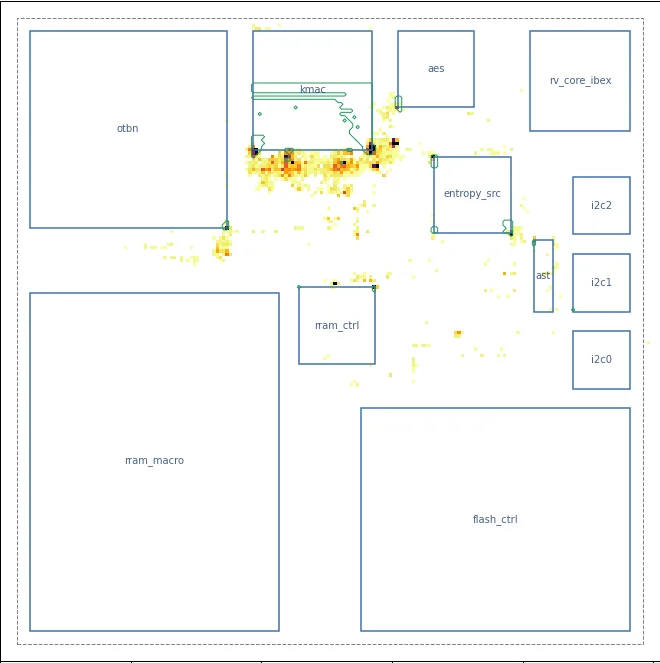
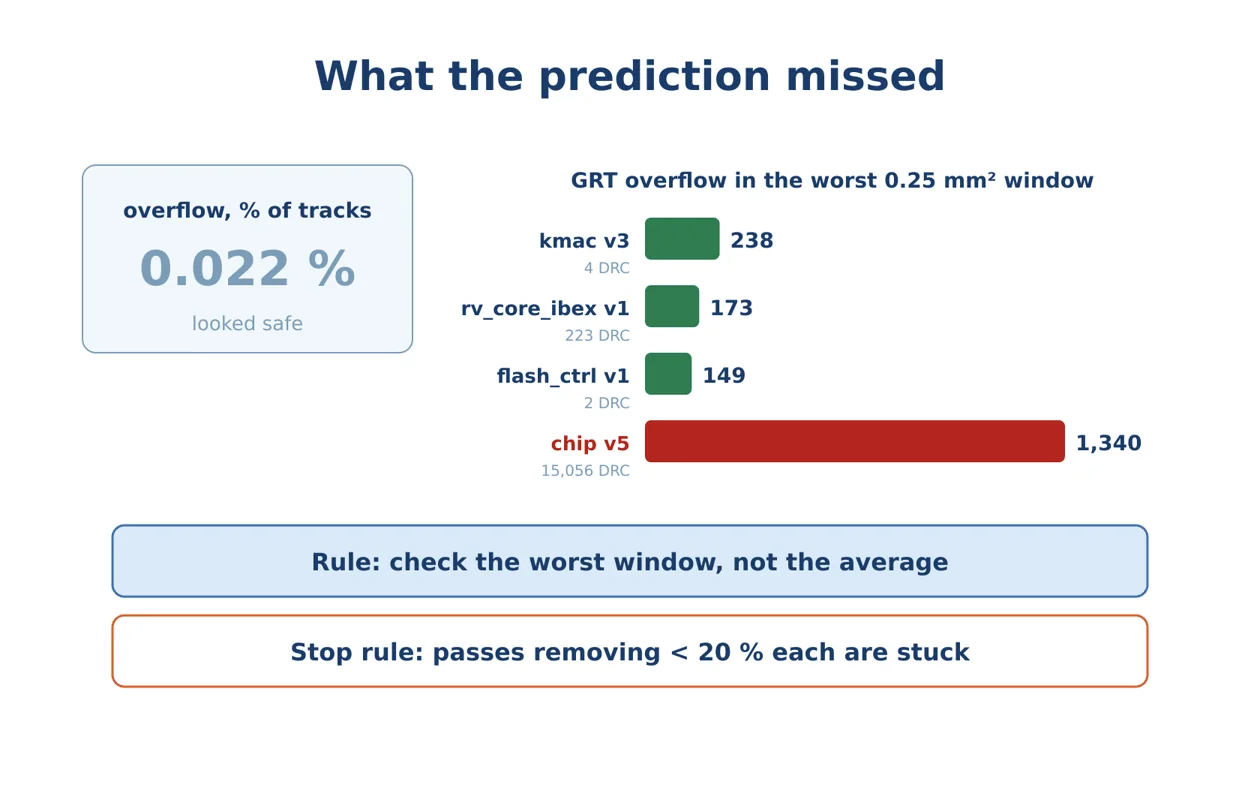
我们的预测原本认为芯片绕得通,因为溢出只占所有走线的 0.022%。结果这是错误的指标。由此得到两条规则:
- 看最差的小窗口,而不是总数。 在最差的 0.25 mm² 全局绕线窗口里,芯片有 1,340 条溢出的走线。能绕通的模块只有 149 到 238 条。
- 每一轮停滞时就停下来。 当每一轮详细绕线清掉的不到剩余的五分之一,再多跑几轮也完成不了。
接着要做一个决定:修 kmac 周围的 floorplan,大约还要两天;或者现在就完成,把剩下的问题写下来。这是流程演示,不是流片,所以我们完成它。绕线后处理和 finish 都完成了,每个剩下的问题都写在这个版本的笔记里。修好 kmac 通道,并在绕线前用最差窗口规则检查,是芯片 v6 的第一项工作。
G2 带来了什么
这里的每一步都是一个附带 README 的 G2 版本:探测、四次短检查,以及避免重新布局的那次只读测试。正因如此,这个方法才能便宜地照着做。数据、决定和下一步都留在产生它们的运行旁边,floorplan 的选择可以靠数字追溯,而不是靠记忆。
下一篇:完成的芯片要在独立的工具里做签核,而这揭露了 OpenROAD 的两个 bug。