
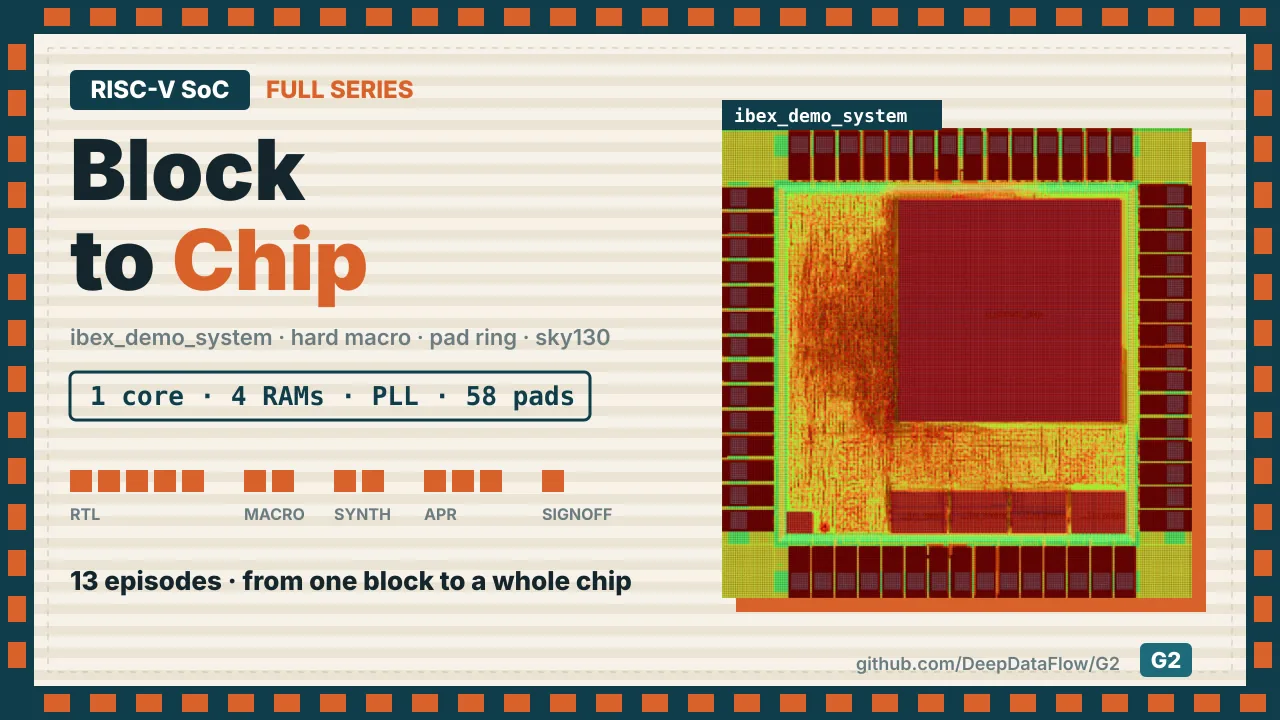
ブロックはチップではありません。前回のシリーズ RISC-V RTL-to-Signoff では、RISC-V コアの一つである lowRISC の Ibex を、単一ブロックとして RTL からサインオフまで進めました。このシリーズでは、そのコアを中心にチップを作ります。メモリとペリフェラル、PLL、実際の IO パッドを加え、コア自体はハードマクロとして組み込みます。そしてチップ全体の論理合成、配置配線、サインオフを G2 で行います。
この記事は 13 本の動画の記事版です。各セクションには、そのエピソードの動画、背景にある判断、得られた数値をまとめています。すべてのファイルは G2_demo_sky130 プロジェクトにあります。
| 設計 | lowRISC Ibex Demo System:バス、RAM、GPIO、UART、SPI、PWM、タイマー、JTAG デバッグ |
| プロセス | SkyWater 130 nm(sky130 HD スタンダードセル) |
| ツール | Yosys、OpenROAD、OpenRCX、OpenSTA。すべて G2 上で実行 |
| チップ | 1.8 × 1.8 mm のダイ、58 パッド、6 マクロ(コア、RAM 4 個、PLL)、フィラー挿入後 115,854 インスタンス |
| 結果 | ホールドは満足。セットアップは低速コーナーで −1.445 ns、目標 25 MHz に対して 24.1 MHz |
第 1 部:チップの部品
#1ブロックから SoC へ
 2:02
YouTube で見る(英語) ↗Bilibili で見る(中国語) ↗
この SoC は lowRISC の Ibex Demo System です。1 つの Ibex コアの周りに、バス、RAM、GPIO、UART、SPI、PWM、タイマー、JTAG デバッグモジュールがあります。もともとは FPGA 向けに書かれたものです。このうち 2 つを変更します。u_top がコアで、u_ram は 128 KiB のデュアルポートメモリです。
G2 では、SoC は新しいブロック ibex_demo_system になります。名前にアンダースコアを使うのは、G2 がブロック名を論理合成と配置配線のトップモジュール名として使い、Verilog の名前にはハイフンを使えないためです。1 クリックで spec ページと、実装・スクリプト・設計データマネージャー(DDM)のフォルダが作られます。階層では SoC がレベル 0、シリーズ 1 で作ったコアがその中のレベル 1 です。
最初の spec 項目は速度、25 MHz です。コアは低速コーナーで 25.56 MHz でサインオフしており、SoC がコアより速く動くことはできません。スタンダードセルの項目はブロックの stdcell.cfg を開き、フローが読むのはこのファイルです。これは論理合成でもう一度重要になります。
#2デュアルポート RAM マクロ
 2:25
YouTube で見る(英語) ↗Bilibili で見る(中国語) ↗
SoC の RAM は 128 KiB のデュアルポートで、データ用と命令フェッチ用のポートがあります。FPGA ではブロック RAM ですが、チップではメモリマクロであり、ライブラリにはコアの命令キャッシュ用のシングルポート RAM しかありません。
判断は 2 つです。1 つ目は、デモのソフトウェアには 16 KiB で十分で、128 KiB は sky130 では非常に大きくなること。2 つ目は、ジェネレーターのデュアルポート RAM にはバイト書き込みマスクがないため、32 ビットのメモリを 8 ビット幅のマクロ 4 個(バイトレーンごとに 1 個)で構成することです。
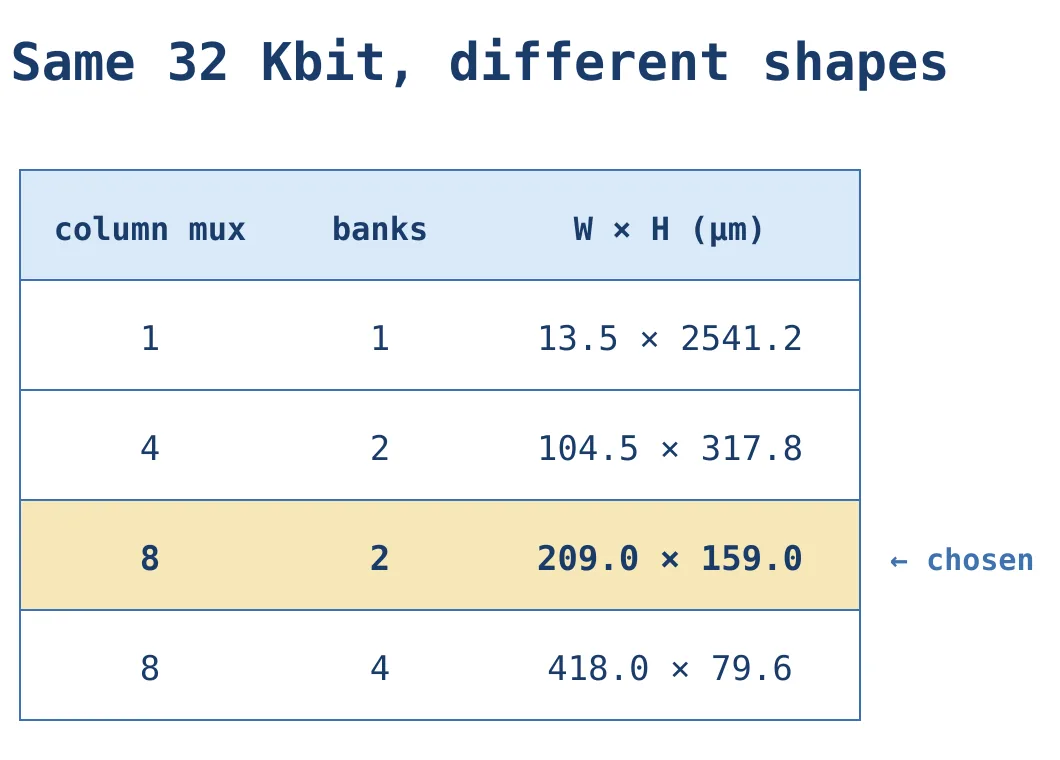
FakeRAM2.0 は実在しないメモリのタイミングビューとレイアウトビューを作るツールで、フロー開発に最適です。同じ 32 Kbit でも形はまったく変わります。
生成されたモデルは必ず読みましょう。このモデルはアドレスをレジスタに取り込んでからアレイを読むため、データが 2 サイクル遅れて出てきます。liberty と RAM ラッパーはどちらも 1 サイクルなので、1 サイクルのモデルに置き換えます。liberty は標準コーナー 1 つだけで出力されますが、プロジェクトには 4 つのコーナーがあるため、ヘッダーに正しい電圧と温度を入れた 4 つのコピーを作ります。タイミングはどれも同じで、シリーズ 1 の RAM と同じ方法です。
G2 のライブラリマネージャー(LIM)では操作の順番が重要です。Find、Build all、最後に Fill の順です。Fill は作成済みのページを使って各 liberty をコーナーに対応づけるので、先に実行すると何も一致しません。結果は 2 ポートで、それぞれアドレス 12 ビット、データ 8 ビット、クロックからデータまで 0.218 ns です。
#3ハードコアに SoC を合わせる
 2:07
YouTube で見る(英語) ↗Bilibili で見る(中国語) ↗
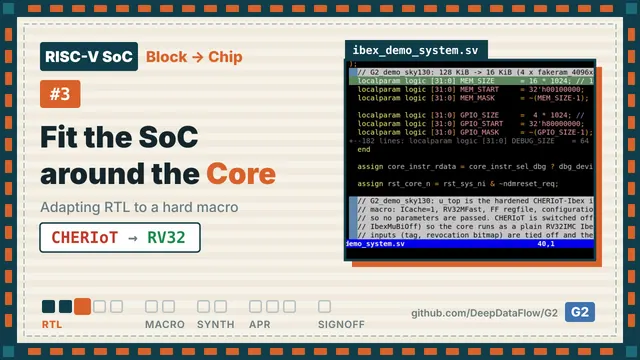
SoC の RTL は rtl v01 として DDM に入れます。デモのリポジトリからコピーし、元のリポジトリには手を加えません。ここで問題が出ます。シリーズ 1 でハード化したコアは CHERIoT 版の Ibex で、ポートがこの SoC と合いません。SoC が知らない CHERIoT とロックステップのポートがあり、SoC は完成したマクロでは受け取れないパラメーターを渡しています。
マクロはそのままにして、SoC を合わせます。
- CHERIoT をオフにし、コアを通常の 32 ビット RISC-V として動かす。
- 余分な入力は定数に固定し、余分な出力は開放のままにする。
- パラメーターを削除し、ハード化したときの構成をそのまま SoC に与える。
- RAM を 16 KiB に縮小する。すべての変更にタグを付け、後で探せるようにする。
RAM ラッパーは 32 ビットのメモリを 4 個のバイト幅マクロに割り当て、各バイトの書き込みイネーブルがそのマスクビットになります。論理合成の前に、コアと RAM をブラックボックスにして簡単なエラボレーションチェックを行います。オプションが 1 つ足りないと slang が止まります。デバッグモジュールが宣言前の信号を使っているためです。シミュレーターは見逃しますが、slang は見逃しません。オプションを加えるとリンクが通ります。コア 1 個と RAM 4 個で、ポート名とビット幅は実際のマクロと一致します。
#4実チップのクロック
 2:19
YouTube で見る(英語) ↗Bilibili で見る(中国語) ↗
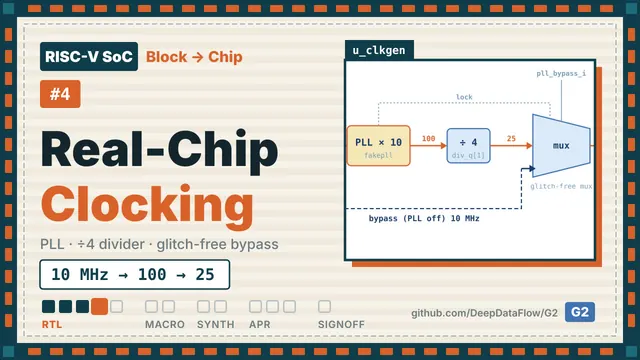
FPGA ボードではクロックはピンから入ってきました。実際のチップは自分でクロックを作ります。10 MHz のリファレンス、それを 10 倍にする PLL、コア用に 25 MHz まで下げる分周器、そして PLL が動かなくてもチップが動くためのバイパスです。
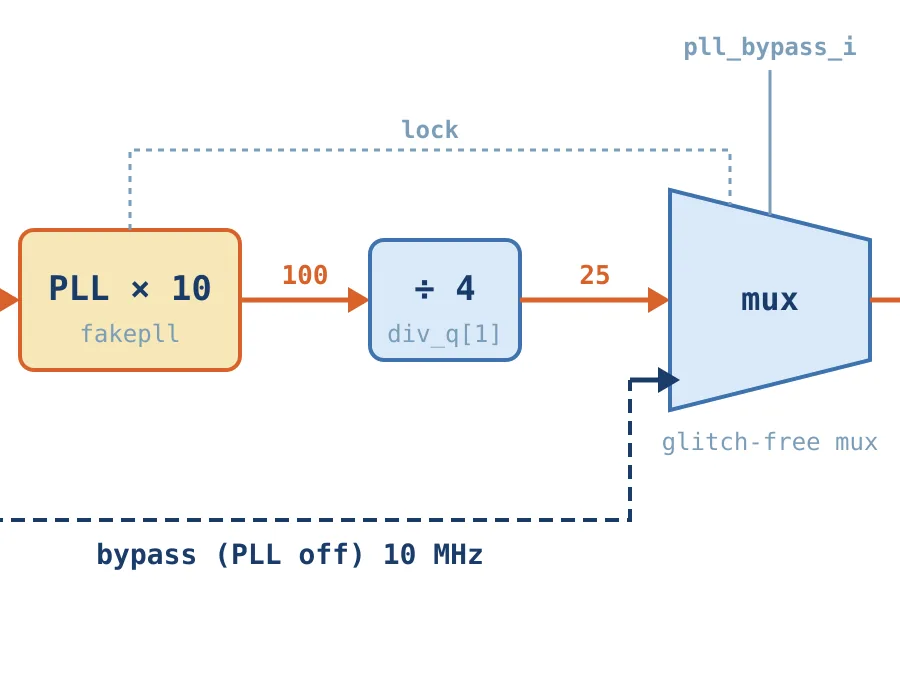
sky130 には使える PLL がないので、フェイク RAM と同じようにフェイク PLL を作ります。現実的なレイアウトビューとタイミングビューを持ち、中に回路はありません。1 つ意図的な選択があります。リファレンスから出力へのタイミングアークを作らないことです。PLL の出力は新しいクロックであり、制約でそう定義します。
クロックジェネレーター clkgen は rtl v02 で最も注意が必要な部分です。2 ビットのカウンターが PLL クロックを分周し、最上位ビットが 25 MHz のクロックになります。各クロックには専用のクロックゲートがあり、各ゲートのイネーブルはそれぞれのクロックドメインで同期され、もう一方がオフになってからオンになります。リセット解除直後は、PLL がロックするまでリファレンスで動きます。最後にリセット同期回路がリセットをきれいに解除します。
クロックが遅くなると SPI ホストが壊れます。25 MHz を 12.5 MHz の SPI クロックで割るとトグルカウントが 1 になり、カウンターが 0 ビットになります。元の比率、つまりシステムクロックの 4 分の 1 を維持します。注意点は 3 つです。バイパス時は UART のボーレートが正しくないこと、バイパスピンはリセット中にしか変更できないこと、そして PLL は代用品であることです。
#5実際のパッド
 2:40
YouTube で見る(英語) ↗Bilibili で見る(中国語) ↗
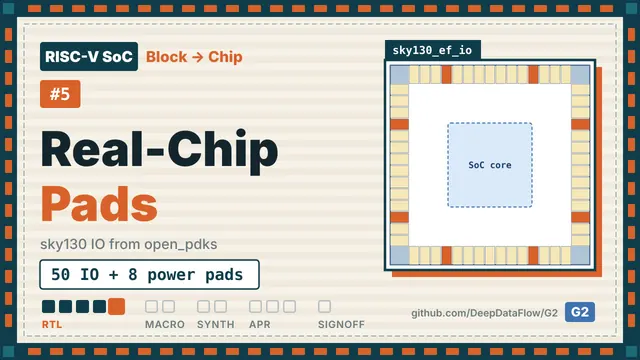
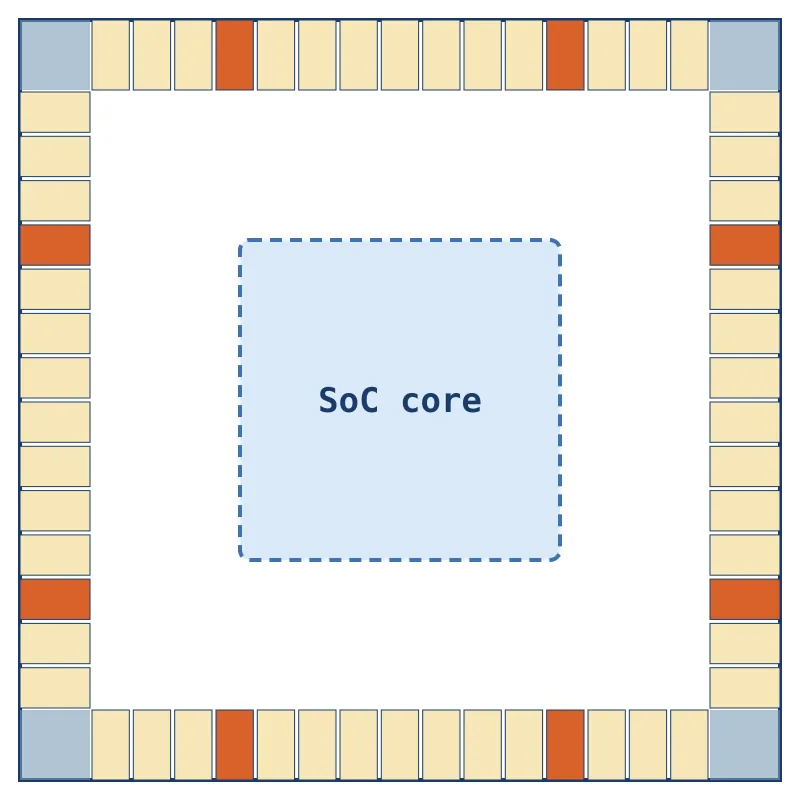
チップはパッドを通してボードとやり取りします。skywater-pdk の sky130 IO ライブラリにはレイアウトと Verilog はありますがタイミングがありません。タイミングがなければ論理合成もサインオフもできません。open_pdks は、すべての Caravel チップが使う Efabless のラップ済みパッドを含む完全なセットを、全コーナーのタイミング付きで生成します。LibreLane のパッド設定を見ると、実績のある sky130 パッドリングが使うセルがわかります。汎用 IO パッド、ESD クランプ付きのコア電源パッドと IO 電源パッド、コーナーセル、フィラースライスです。
小さなインストーラーで 5 つのセルを G2 の PDK にコピーします。各セルには 4 コーナー分の liberty があります。LIM では 1 つのエントリーがコーナーごとに 1 つの liberty しか持てないため、セルごとにエントリーを作ります。20 個の liberty ファイルがすべて一致しました(ここで LIM の小さなバグを 2 つ見つけました。Fill がシンボリックリンクを飛ばすことと、ページタイトルの誤りです)。
rtl v03 のチップトップは SoC のポート名をそのまま使い、それらはボンディングパッドになります。信号パッド 50 個と電源パッド 8 個です。パッドラッパーの高電圧イネーブルは、Caravel と同じくパッド自身の tie-high と tie-low の出力から取ります。ついでに、フリップフロップで作った 128 バイトの FIFO 3 つが、チップ全体のフリップフロップのほぼ 3 分の 2 を占めていたので、それぞれ 16 エントリーに縮小しました。
第 2 部:コアをハードマクロにする
#6ブロックをマクロ対応にする
 2:51
YouTube で見る(英語) ↗Bilibili で見る(中国語) ↗
ハードブロックにはルールがあります。最上位のメタルは親のものです。マクロの abstract ビューは、ブロックが使うすべてのメタル層をブロックします。シリーズ 1 のコアは電源グリッドと配線にメタル 5 を使っていたため、マクロ全体がメタル 5 で塞がれていました。チップのメタル 5 電源ストラップはその端で止まり、練習ではチップレベルの電源チェックがコアの電源ピンを未接続と報告しました。コアに電源が届かないということです。
解決策は慣例に従うことです。ブロックはメタル 4 までにとどめ、チップがメタル 5 からブロックのメタル 4 電源ピンへ直接ビアを落とします。シリーズ 1 のビルドはそのままにして、コアをビルド v03 として再実行しました。スクリプトの変更は 3 つです。
- 信号とクロックの配線をメタル 4 までに制限する。
- フロアプランだけでなく、すべてのステージがその設定を読む。
- 電源グリッドからメタル 5 のストラップを外す。フロアプランのスクリプトは、デザイン独自の電源スクリプトと、チップで使うパッドリングのスクリプトも探すようになった。
配線には 14 分かかり、違反は 120 個と以前より少し減りました。そして求めていた 1 行、メタル 5 の配線長は 0 µm です。ポストルートとフィニッシュの後は違反 130 個。1 層減らした代償であり、デモとしては問題ありません。
#7ブロックからハードマクロへ
 2:48
YouTube で見る(英語) ↗Bilibili で見る(中国語) ↗
親のデザインには、ハードブロックの 3 つのビューが必要です。寄生成分、コーナーごとのタイミングモデル、abstract レイアウトです。
- 寄生成分: OpenRCX が新しいレイアウトの 4 コーナーを 1 分以内に抽出します。
- タイミングモデル: OpenSTA の
write_timing_modelがコアを 1 つのセルとして書き出します。入力のセットアップ・ホールドチェック、自身のクロックツリーを含むクロックから出力までの遅延、そしてクロックツリーのレイテンシそのものです。元のスクリプトは全コーナーのモデルに同じ名前を付けていたためコーナー同士が衝突しました。コーナー名で命名するようにしています。なお、モデルの面積はセル面積で、マクロの占有面積ではありません。 - abstract LEF: ルーターが電源として扱ったタイネットを信号に戻します。そうしないと空の電源ピンとして現れます。abstract はブロックが使うすべての層をブロックし、電源ピンにはメタル 4 だけを残します。元の abstract には内部の電源図形が何千も並びますが、それらをつなぐビアがないため、親から見ると浮いているように見えるからです。
結果は 850 × 850 µm のマクロで、ピン数は 930、電源はメタル 4、メタル 5 には何もありません。ビューも一致しています。LEF、ネットリスト、タイミングモデルのいずれも信号は 928 ビットです。コアはハード IP として LIM に入ります。一致したコーナーは 2 つで、サインオフしたコーナーです。残りの 2 つにはタイミングモデルがなく、使いません。
第 3 部:制約と論理合成
#8実チップの制約
 2:14
YouTube で見る(英語) ↗Bilibili で見る(中国語) ↗
論理合成の制約 sdc_syn v01 は 1 つの数値で決まります。システムクロックの 40 ns です。クロックは 4 つあります。リファレンスはそのピンにあります。PLL の出力は PLL の出力ピンに定義した新しいクロックで、フェイク PLL にタイミングアークがないのはこのためです。システムクロックはそこから 4 分周で生成されます。
create_clock -name clk_ref -period $ref_period [get_ports clk_ref_i]
create_clock -name clk_pll -period $pll_period [get_pins u_core/u_clkgen/u_pll/clk_o]
create_generated_clock -name clk_sys -divide_by 4 \
  -source [get_pins u_core/u_clkgen/u_pll/clk_o] \
  [get_pins -of_objects [get_nets u_core/u_clkgen/clk_div4] -filter "direction == output"]
create_clock -name clk_tck -period $tck_period [get_ports tck_i]
論理合成はフリップフロップの名前を変えるので、RTL からコピーした名前はネットリストに存在しません。ネットは名前を保つので、分周クロックのネットを駆動するピンを指定します。JTAG は独立したクロックで、マックスの制御信号は同期回路を通るため、3 つのグループは互いに非同期です。
ファンクショナルモードでは PLL がオンです。そしてバイパスピンへのケース解析だけでは足りません。バイパス側クロックゲートのイネーブルは定数ではなくフリップフロップから来るため、リファレンスクロックがすべてのシステムフリップフロップに漏れます。2 つのクロックを持つピンが 4,599 本ありました。バイパスゲートのクロックアークを無効にすると、各フリップフロップのクロックは 1 つになります。
set_case_analysis 0 [get_ports pll_bypass_i]
set_disable_timing -from CLK -to GCLK [get_cells u_core/u_clkgen/u_icg_ref/icg]
すべてのポートはボンディングパッド、つまり inout になったので、タイミング解析は各パッドを入力と出力の両方として見ます。パッドが使わない方向には遅延 0 を与えて除外し、意図せず制約のない経路が残らないようにします。出力パッドは 5 pF のボード負荷を駆動します。
#9チップの論理合成
 2:18
YouTube で見る(英語) ↗Bilibili で見る(中国語) ↗
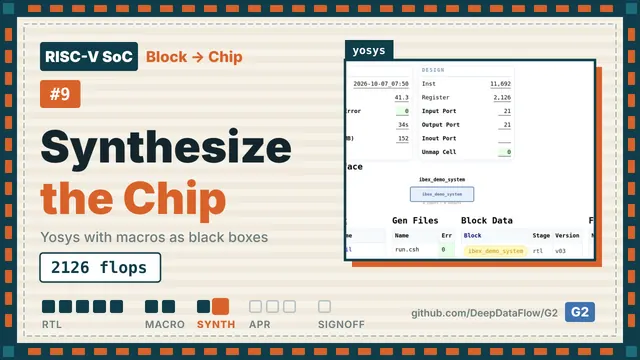
チップ用に新しい実装ビルドを作ります。rtl v03 と第 8 回の制約です。G2 は spec からライブラリを集めます。コーナーごとに 9 個で、スタンダードセル、RAM、コアのタイミングモデル、PLL、5 つのパッドセルです。これらは spec のライブラリファイル、つまりエディターが書き込むファイルから来ます。エディターを使ってきたのはこのためです。元の Yosys スクリプトは sky130 で誤った名前でフリップフロップを数えますが、シリーズ 1 で修正済みなので、タイミングドリブンのものを含めてそのスクリプトを再利用します。
実行は約 40 秒。エラーなし、未マッピングなし、インスタンス 11,692、フリップフロップ 2,126 で、すべてのマクロとパッドはブラックボックスとしてネットリストに入っています。次に制約とネットリストを突き合わせます。制約のないエンドポイントが 22 個ありますが、すべて想定どおりで、入力パッドの使わない側と電源パッドです。各クロックは届くべきフリップフロップに届いています。
配置前のタイミングは正直に読む必要があります。システムクロックのセットアップは −10.4 ns、リセットのリカバリーは −21.4 ns です。リセット同期回路がバッファなしで 1,316 個のフリップフロップを駆動しており、スルーが 40.9 ns あるためです。論理合成はこのネットにバッファを入れませんが、配置で入ります。この 1 本のネットを除けば、すべてのクロックがタイミングを満たします。
第 4 部:チップの配置配線
#10パッドリングとチップ電源
 2:35
YouTube で見る(英語) ↗Bilibili で見る(中国語) ↗
配置配線の制約は論理合成のものと同じで、変更は 1 か所だけです。ボードの信号は、スタンダードセルではなくトランジションで入力パッドを駆動します。パッドを駆動できるスタンダードセルはないからです。ダイは 1.8 mm 角、コアは 1.3 mm です。58 個のパッドには 1 辺 1.6 mm 以上が必要なので、サイズを決めるのはロジックではなくパッドです。
パッドリングのスクリプトは、ダイの周囲に IO サイトを置き、各辺のパッドを順番に等間隔で配置し、コーナー、フィラースライス、アバットメント、そして各ポートのボンディングパッド端子を作ります。重要な順序が 1 つあります。アバットメントの前にパッド電源の名前を付けることです。そうしないとアバットメントが独自のリングネットを作り、電源パッドがコア電源につながらず、後のどの工程でも直りません。
# まずパッド電源を接続(add_global_connection ...)、その後:
global_connect
connect_by_abutment
place_io_terminals {*/PAD */VCCD_PAD */VSSD_PAD */VDDIO_PAD */VSSIO_PAD}電源グリッドには、パッド電源、電源パッドにつながるコアリング、リングまで延びるストライプを加えます。-extend_to_core_ring がないとストライプはリングの手前で止まり、コアのグリッド全体が浮いてしまいます。どちらも練習中に痛い思いをして見つけた問題です。
add_pdn_stripe -grid {grid} -layer {met5} -width {1.600} -pitch {27.200} -offset {13.600} -extend_to_core_ring
add_pdn_ring -grid {grid} -layers {met4 met5} -widths {10.0 10.0} -spacings {2.0 2.0} \
  -core_offsets {10.0 10.0} -connect_to_pads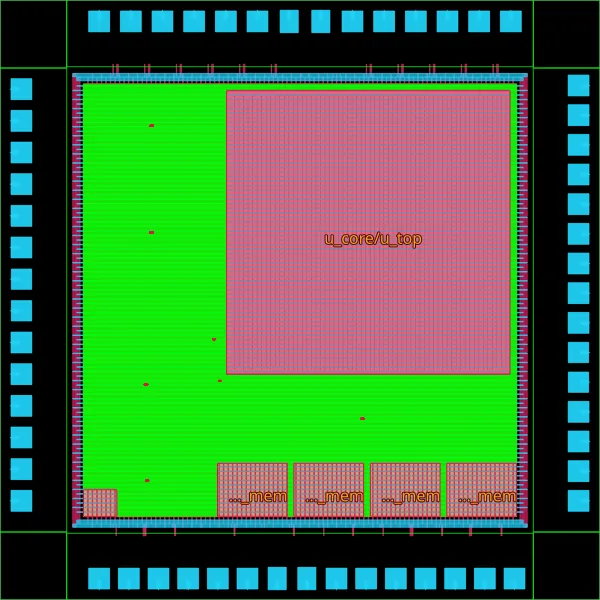
これが第 6 回の成果です。32 本のメタル 5 電源ストラップがコアの上を通り、900 個のビアがメタル 4 の電源ピンに落ちています。
#11配置、CTS、ポスト CTS
 2:05
YouTube で見る(英語) ↗Bilibili で見る(中国語) ↗
配置後、電源チェックが通ります。電源上のすべての図形がつながっています。練習では、グリッドがリングに届き、コアがメタル 5 を空けるまで、このチェックは失敗し続けました。それらの修正を先に行ったのはこのためです。
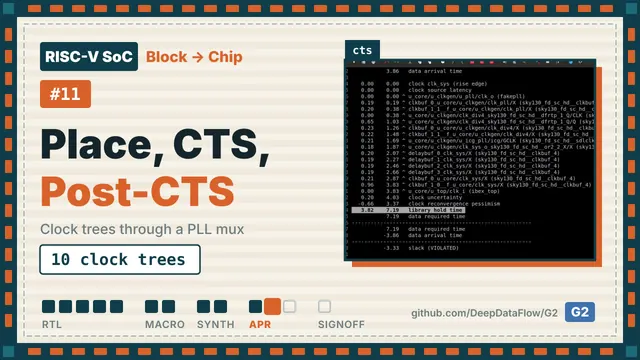
クロックツリー合成で 10 本のクロックツリーができます。システムクロックはグリッチフリーのマックスから出て、9 本のマクロクロックピンと 1,892 個のフリップフロップに届きます。JTAG には専用のツリーがあります。
ここからが階層設計の部分です。コアのタイミングモデルによると、コア自身のクロックツリーがマクロ内で 5 ns 以上を加えます。ピンまで 3.8 ns、内部でさらに 5.6 ns です。コアのフリップフロップは RAM よりかなり遅れてクロックを受け取り、それがコアの入力での −3.3 ns のホールド違反として現れます。ポスト CTS の修正で 317 個のホールドバッファが挿入され、コアを含むすべてのホールド違反が解消します。
セットアップ違反が 1 つ、クロック分周器に残ります。分周器自身の出力がクロックツリーのネットになり、そのツリーを通って 100 MHz でカウンターに帰還しているためです。実際の設計なら別のフリップフロップから帰還させます。記録して先に進みます。
#12配線と完成
 0:55
YouTube で見る(英語) ↗Bilibili で見る(中国語) ↗
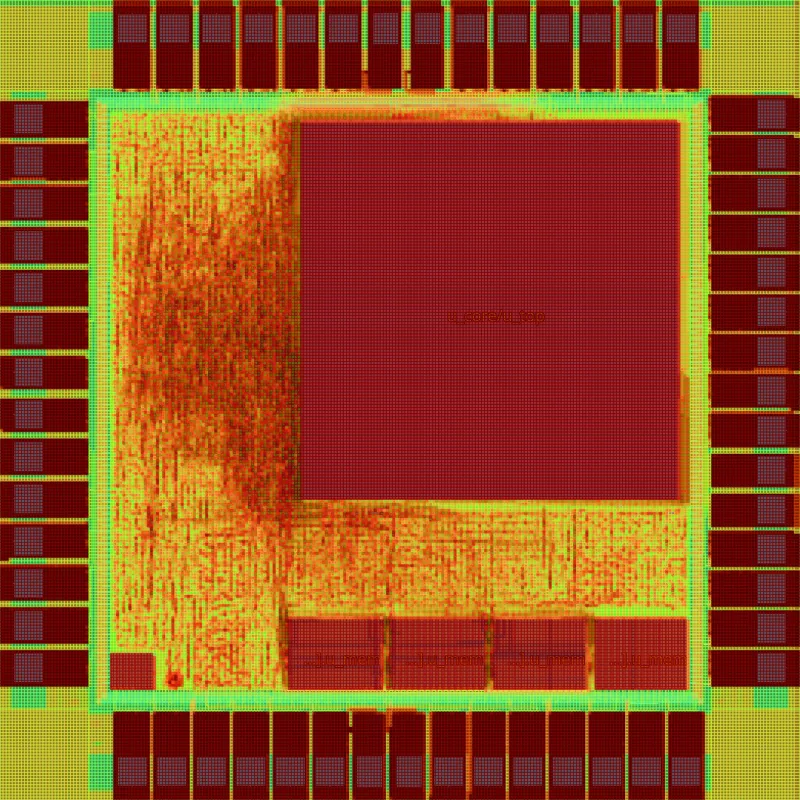
チップ全体の配線は約 10 分で、違反は 1 個、配線長 1.07 m、ビア 106,115 個です。コア単体では 120 個ありました。チップのコアには余裕があり、マクロ上のメタル 5 がチップに開放されているからです。ポストルートのクリーンアップとフィニッシュ(フィラーを入れ、最終ネットリストとレイアウトを出力)の後は、違反 2 個、ショートなしです。フィニッシュで表示されるタイミングはまだ理想クロックで、本当の数値はサインオフで出ます。
第 5 部:サインオフ
#13チップのサインオフ
 2:56
YouTube で見る(英語) ↗Bilibili で見る(中国語) ↗
サインオフは実際の配線から始まります。OpenRCX が 4 コーナーを 18 秒で抽出します。サインオフ制約では、実際のクロックツリーを反映するためプロパゲーテッドクロックを使い、スキューを推測する必要がなくなったので不確定性を小さくします。
実際のパッドを持つチップだけに必要なセクションが 1 つあります。パッドのタイミングは駆動モードで変わります。RTL ではそのピンを固定していますが、ドライバーのないネットを経由しているため、タイミング解析は値を見られず、最も遅いモードを仮定します。パッドモードがないと出力パッドは 120 ns かかり、チップは 102 ns 足りません。指定すると 6.9 ns で、12.2 ns の余裕があります。
続いて OpenSTA でチップ全体を解析します。コアはタイミングモデル、各パッド、RAM、PLL は LIM から読み込みます。マージした結果がこちらです。
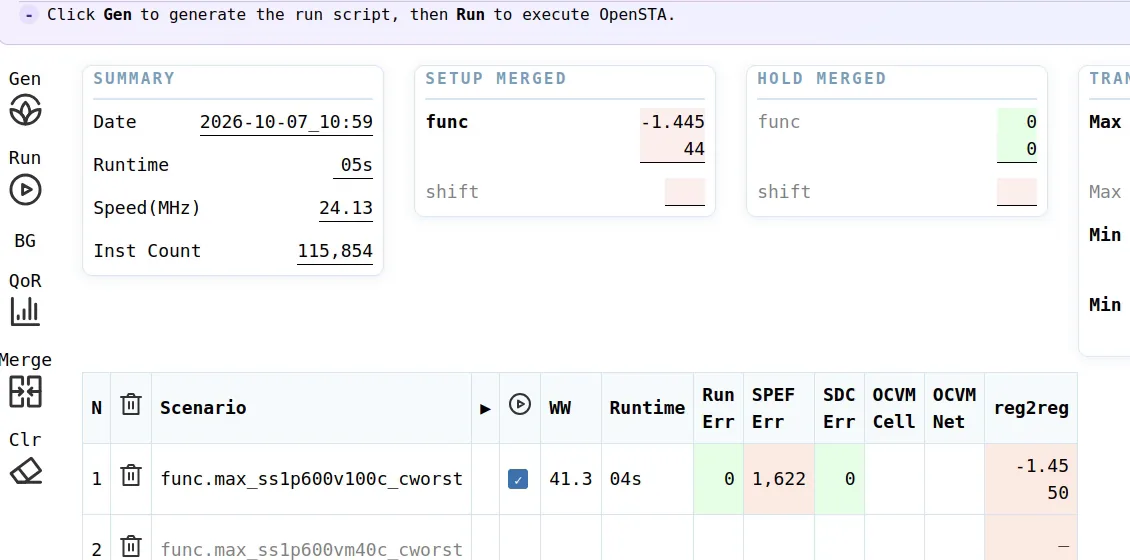
ワーストパスがこのシリーズの教訓です。クロックは 7.8 ns でコアに届きます。コアのタイミングモデルによると、データアドレスはその 27.9 ns 後に出てきます。コア自身のクロックツリーとロジックの分です。SoC に残るのはバスとデバッグメモリのための約 12 ns ですが、必要なのは 13.5 ns です。ブロックでチップを組むとき、各ブロックの出力タイミングはチップが受け入れるべき予算になります。 チップは 25 MHz ではなく約 24.1 MHz で動きます。
作ったもの、残っているもの
シリーズ 1 のコアからチップへ。デュアルポート RAM、安全なバイパス付きの PLL、58 個の実際のパッド、チップのための空間を残すハードマクロのコア、論理合成、配置配線、サインオフ。すべて G2 で実行し、受け渡しはすべて設計データマネージャーとライブラリマネージャーを通しました。
残った課題と、どこから手をつけるか:
- コア境界でセットアップ −1.45 ns。 コアのクロックから出力までの予算です。次の一手は、より速いコアか、バス境界へのレジスタ挿入です。
- 出力パッドのスルー。 パッドのトランジションテーブルがモード別になっておらず、ライブラリのモデリングの限界です。
- PLL 側の小さすぎるクロックゲート(最大容量)。
- 100 MHz ドメインでの分周器の帰還。
- DRC 違反 2 個。また、このシリーズでは DRC、LVS、GDS のサインオフは行っていません。
動画を見る、試してみる
- 動画: YouTube プレイリスト(英語)と Bilibili コレクション(中国語)。
- このシリーズの出発点となるコア: RISC-V RTL-to-Signoff。
- 次のシリーズ: RISC-V Flip-Chip: Pads to Bumps では、パッドリングを外し、このワイヤーボンディングのチップとフリップチップ版を比較します。
- プロジェクト: G2_demo_sky130。G2 は無料の Community Edition で使えます。
- G2 や独自フローの実行に関するご質問: support@deepdataflow.com。ライセンスや協業について:sales@deepdataflow.com。