
同じ RTL、同じ制約、2 つの論理合成スクリプト。一方はタイミングを 16 ns 外し、もう一方は満たします。このシリーズはここから始まります。本物の RISC-V コア、命令キャッシュを有効にした lowRISC の Ibex を、SkyWater 130 nm で RTL からサインオフまで進めます。使うのは G2 上のオープンソースツールだけです。論理合成は Yosys、配置配線は OpenROAD、抽出は OpenRCX、サインオフは OpenSTA です。
この記事は 12 本の動画の記事版です。各セクションには、そのエピソードの動画、背景にある判断、得られた数値をまとめています。すべては GitHub の G2_demo_sky130 プロジェクトにあります。ワークスペースにクローンして make setup を実行すれば、プロジェクトが現れます。
| 設計 | ibex_top:命令キャッシュを有効にした lowRISC Ibex。SRAM マクロは 4 個 |
| プロセス | SkyWater 130 nm(sky130 HD スタンダードセル) |
| ツール | Yosys、OpenROAD、OpenRCX、OpenSTA。すべて G2 上で実行 |
| ブロック | 850 × 850 µm、フリップフロップ約 2,400 個、フィラー挿入後 98,222 インスタンス(うちフィラー 70,818) |
| 結果 | ホールドは満足(+0.17 ns)。セットアップはレジスタから出力のみ未達で、アドレス 8 ビットが −1.74 ns。DRC 107 個 |
第 1 部:論理合成
#1Yosys 論理合成:RTL から最初のネットリストへ
 4:01
YouTube で見る(英語) ↗Bilibili で見る(中国語) ↗
ブロックは ibex_top、lowRISC の Ibex RISC-V コアです。その spec は sky130 のスタンダードセルと 2 種類のメモリマクロを結びつけています。命令キャッシュを有効にすると、Ibex には 2 つのウェイがあり、それぞれにタグ RAM とデータ RAM があります。合わせて SRAM マクロ 4 個で、スタンダードセルだけの設計よりずっと実際のチップに近くなります。メモリは他のライブラリと同じく G2 のライブラリマネージャー(LIM)にあり、それぞれ LEF と 4 つのタイミングコーナーを持ちます。プロジェクトに同梱されているので、標準の G2 パッケージで動きます。
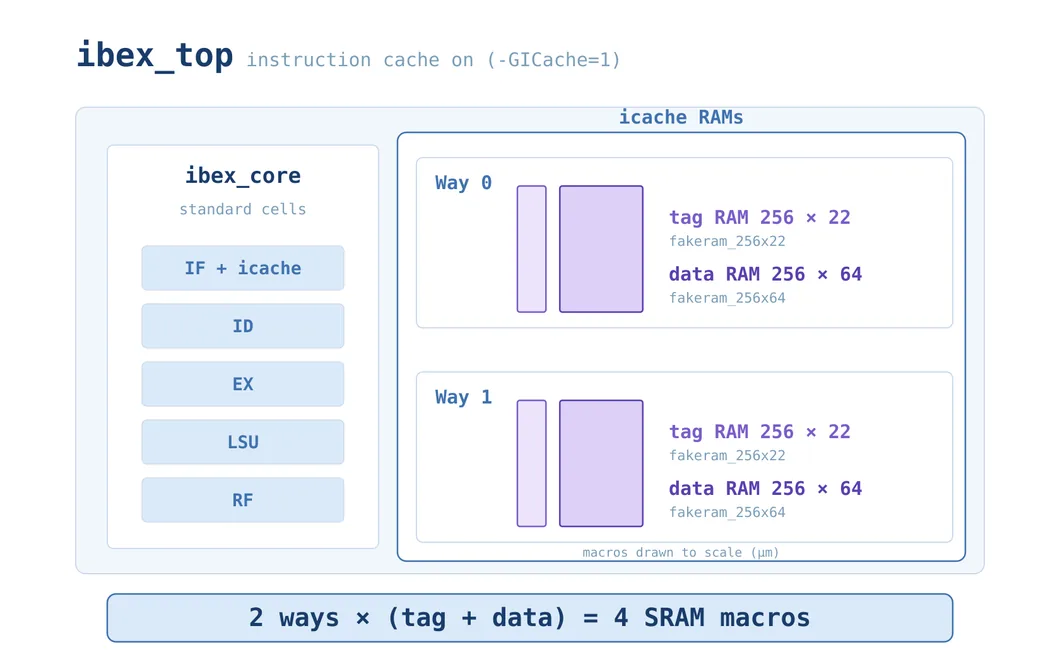
ibex_top:2 ウェイ ×(タグ + データ)= SRAM マクロ 4 個。RTL は DDM の rtl v01 です。ファイルリストの 1 行目 -GICache=1 が構成を決め、ベンダーの RTL 自体には手を加えていません。残りは小さな sky130 テクノロジーレイヤーが担います。Ibex は汎用のシングルポート RAM を要求し、sky130 版がそれぞれの RAM 形状を実際のマクロに割り当てます。クロックゲーティングには、論理合成でマッピングできないラッチではなく、ライブラリの本物の統合クロックゲーティングセルを使います。sky130 固有のファイルはすべて 1 つのフォルダーにあり、それ以外はアップストリームとバイト単位で同一です。
v01 は基本スクリプトを使います。汎用合成のあと面積優先でライブラリにマッピングするだけで、タイミング情報はまったくありません。実行は約 20 秒。未マッピングのセルはなく、レジスタ約 2,400 個、マクロ 4 個です。ネットリストは syn v01 として DDM にチェックインされ、後のどのステップからもバージョン指定で取り出せます。
タイミングを見る前に、G2 の netins ツールでネットリストの中身を確認すると、マクロが 1,800 個と報告されます。分類器が sky130 のセル名を認識できず、フリップフロップ、いくつかの 4 入力ゲート、メモリ、クロックゲートがすべて「マクロ」になっていました。G2 の新リリースを待つ必要はありません。ルールはプレーンテキストの mapping.cfg にあり、パターン、コロン、カテゴリーの形式で、最初に一致したものが使われます。
__a4 : Compound
__o4 : Compound
__df : Seq-FF
__sdlclkp : ICG
^fakeram : Memory
再実行すると、期待どおりのネットリストになります。フリップフロップ 2,395 個、メモリ 4 個、クロックゲート 1 個です。netins は見つけたポートから初期の SDC も書き出します。クロック 1 つと、各ポートのデフォルト遅延です。これは骨組みであり、本当の制約ではありません。
#2タイミングドリブンな論理合成と、データによる選択
 3:57
YouTube で見る(英語) ↗Bilibili で見る(中国語) ↗
骨組みを本当の制約にします。クロックは低速コーナーで 40 ns。入力と出力には周期の 4 分の 1 を外部バジェットとして与え、ドライビングセルと負荷で境界を現実的にし、テストモードはオフ、静的な設定ピンとリセットはタイミング解析の対象外にします。制約は sdc_syn v01 として DDM に入れます。sdc_signoff_func v01 も当面は同じ制約で、レイアウト後にバージョン 2 になります。
ここに落とし穴があります。Yosys は SDC に向けて最適化できません。 新しいバージョンは SDC を解析できますが、参照されたオブジェクトを残すためだけです。Yosys にあるのは ABC の遅延目標 -D と、ドライビングセルと負荷だけの制約ファイルです。そして罠はここです。-D だけを試したところ、ネットリストはバイト単位で同一でした。ABC がバッファを入れたりゲートサイズを変えたりするのは、-constr も与えたときだけです。
そこで上級スクリプトは数値を SDC から直接読みます。周期から IO バジェットと不確定性を引いた 29 ns が ABC の目標です。ドライバーと負荷も同じファイルから取るので、情報源は 1 つです。Booth 乗算器も有効にします。ログで、ABC が 29,000 ps と buf_2 ドライバーを受け取ったことを確認できます。
次に OpenSTA で 2 つのネットリストを評価します。シナリオも SDC も同じで、違うのはネットリストだけです。
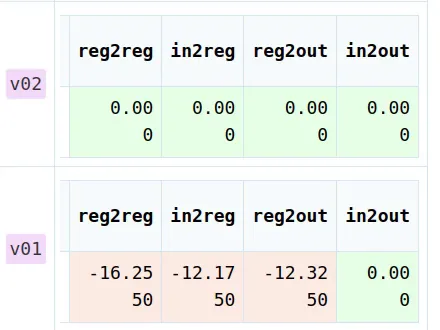
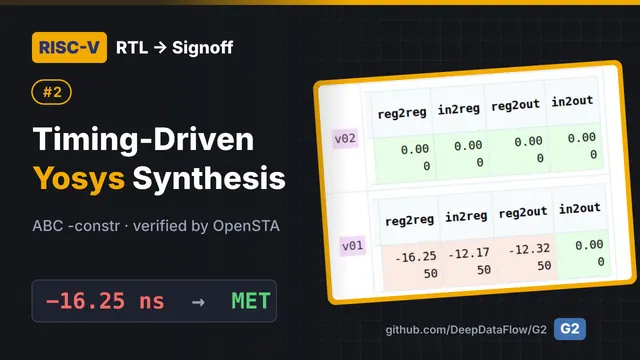
v01 は入力から出力以外すべて未達、タイミングドリブンの v02 はすべて満足。| v01 基本 | v02 タイミングドリブン | |
|---|---|---|
| reg2reg | −16.25 ns | 満足(+6.65) |
| in2reg | −12.17 ns | 満足(+13.13) |
| reg2out | −12.32 ns | 満足(+6.67) |
| バッファ | 0 | 1,494 |
| スタンダードセル | 16,634 | 17,432(+4.8%) |
基本版はなぜ失敗するのか。ワーストパスでは、1 つのフリップフロップが最小サイズの出力で 259 本のピンを駆動しており、1 段だけで約 12 ns かかっています。これこそバッファリングで直すものです。セルを 5% 増やして 23 ns のスラックを得る。v02 を OpenROAD に渡します。これらは配置前の数値で、理想クロック、配線なしです。v02 にはまだスルー違反がありますが、配置配線で修正されます。
第 2 部:OpenROAD、1 エピソード 1 ステージ
#3ネットリストを OpenROAD へ
 3:55
YouTube で見る(英語) ↗Bilibili で見る(中国語) ↗
配置配線には専用の制約が必要です。最初のパスでは sdc_apr_func v01 は論理合成と同じ制約で、40 ns、不確定性付きの理想クロックです。後のステージで実際のクロックツリーに切り替えます。G2 で OpenROAD をチェックアウトすると、init から finish まで 8 つのステージがあり、各ステージの DDM ビューに入力が表示されます。
init スクリプトは、2 つの SRAM を含むテクノロジーとセルの LEF を読み、MMMC ファイルからコーナーごとのタイミングライブラリを読み込み、ネットリストを読んでリンクし、SDC を読みます。変更は 1 か所です。ネットリストは階層構造ですが、OpenROAD の階層リンクモードはまだ開発中と表示されるので、フラットにリンクします。
link_design $blkname ;# 変更前:link_design -hier $blkname実行は 20 秒でエラーはありませんが、警告を読みましょう。ORD-2011:2 つの SRAM に LEF はあっても liberty がありません。OpenROAD は配置はできてもタイミング解析ができません。このリリースのジェネレーターはスタンダードセルのライブラリしか列挙しないため(次のバージョンで修正済み)、メモリのライブラリを低速・高速コーナー分、手で追加します。ファイルが上書きされるので、Gen は二度と押さないでください。以降のすべてのステージがこのファイルを読むので、1 回の修正でフロー全体に効きます。
修正後、低速コーナーのパスグループごとのワーストスラックは、第 2 回の OpenSTA と完全に一致します。reg2reg は +6.652 ns。ネットリストも SDC もライブラリも同じだからです。マクロ 4 個、17,400 インスタンス、論理合成が加えたバッファとインバーター 1,800 個。トランジションと容量にはまだ違反がありますが、配置で修正されます。
#4フロアプラン:ダイ、SRAM マクロ、電源グリッド
 2:23
YouTube で見る(英語) ↗Bilibili で見る(中国語) ↗
フロアプランのスクリプトは、ダイとコアを作り、配線トラックを敷き、論理合成が加えたバッファを取り除き(OpenROAD が実際の配置に基づいて入れ直します)、4 つの SRAM を 20 µm のハローで配置し、タップセルを挿入し、電源グリッドを作ります。
ダイとコアは同じ 850 µm で、マージンがありませんでした。これでは SRAM がダイの端、IO ピンが置かれる場所にぴったり接してしまいます。マクロの上にピンがあると配線でショートし、電源リングもダイからはみ出します。そこで 10 µm 空けて、コアを 830 µm にしました。
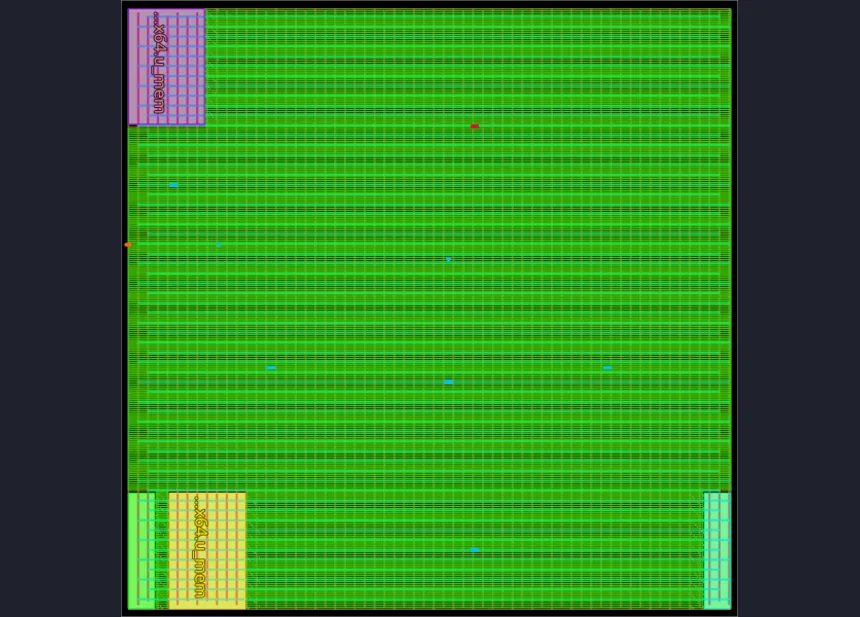
タイミングは意図的に赤くなります。論理合成のバッファ 1,494 個を取り除いたので reg2reg は −14.7 ns。長い配線が大きな負荷を小さなセルで駆動しています。このステージでタップセルが 8,568 個加わり、バッファとインバーターは 1,800 個から 334 個に減り、使用率は 850 µm ダイの 31% です。
#5配置とデザイン修正
 2:33
YouTube で見る(英語) ↗Bilibili で見る(中国語) ↗
配置では、まずピンを無視した粗いグローバル配置を行い、ピンを接続先のロジックの近くに置き、配線混雑を考慮してもう一度配置します。次に配線を見積もって repair_design を実行し、バッファ挿入とサイズ変更ですべてのスルー、容量、ファンアウト違反を直し、最後にすべてのセルを行に合法化します。約 1 分です。
repair_design はスルー違反 710 個と容量違反 235 個を見つけ、バッファ 1,258 個を挿入し、673 個のセルのサイズを変えました。実際の配置の配線でタイミングが戻ります。reg2reg は +1.820 ns、reg2out は 0.63 ns 足りませんが、ポスト CTS で修正されます。トランジションと容量の違反はなくなり、使用率は 34% です。
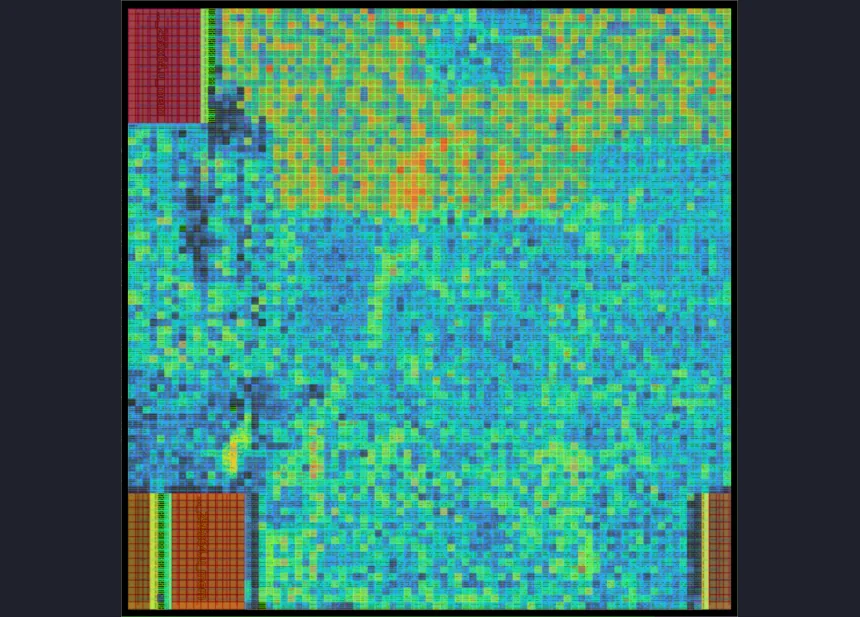
混雑の見積もりは、レジスタファイルの上と、左側の SRAM の横の狭いチャネルで最も高くなります。このチャネルは配線で再び問題になります。
#6クロックツリー合成:エラー 0、ツリーなし
 2:34
YouTube で見る(英語) ↗Bilibili で見る(中国語) ↗
CTS はクロックインバーターを負荷の近くに複製し、1 種類のバッファ clkbuf_4 でツリーを作り、クロックピンからルートまでの長い配線を直し、新しいバッファを合法化します。最初の実行はエラーなしと報告します。しかしログには、クロック配線の抵抗と容量がゼロだという警告があります。その後 CTS はクロックに 3,350 個のマクロシンクがあると判断し、複製されたネットを数百本スキップします。クロックゲートの後ろにはツリーが作られません。
配置でワイヤ RC は設定しましたが、その設定はデータベースに保存されず、CTS スクリプトは設定し直しません。配置と同じ 3 行で直ります。
source $fvar(layer_rc)
set_wire_rc -signal -layer $wire_rc_layer
set_wire_rc -clock -layer $wire_rc_layer_clk
これで CTS は 3 本のクロックネットを見つけます。4 つの SRAM とクロックゲートを駆動するクロックピン、ゲートされていないフリップフロップ 1 個、そしてほぼすべてのレジスタを駆動するコアクロックゲートの後ろのゲーテッドクロックで、そこにバッファ 660 個が入ります。修正前、このドメインにはツリーがまったくなく、2,400 個のフリップフロップがバッファなしの 1 本のネットにつながっていました。それでもステージはエラー 0 と報告していたのです。エラー数ではなくログを読みましょう。
#7ポスト CTS のタイミング修正
 2:18
YouTube で見る(英語) ↗Bilibili で見る(中国語) ↗
CTS の後、タイミングは本物になります。クロックを理想からプロパゲーテッドに切り替え、各フリップフロップはツリーを通った実際の到着時刻を見るようになります。次に repair_timing がサイズ変更とバッファ挿入でセットアップとホールドを直し、電源グリッドの静的 IR ドロップをチェックします。
実際のクロックでは 17 個のエンドポイントがセットアップを満たしません。クロックツリーが約 4 ns の遅延を加え、出力バジェットを食うためです。repair_timing はバッファ 8 個ですべて修正し、−5.2 ns から +0.109 ns になり、ホールドも満たします。1 本のネットがスルー制限を 160 ps 超えています。実際のテープアウトなら CTS 後にもう一度 repair_design を実行します。静的 IR ドロップは最大 147 µV、1.6 V の約 0.01% で、このデザインには十分強い電源グリッドです。
#8グローバル配線と詳細配線
 2:01
YouTube で見る(英語) ↗Bilibili で見る(中国語) ↗
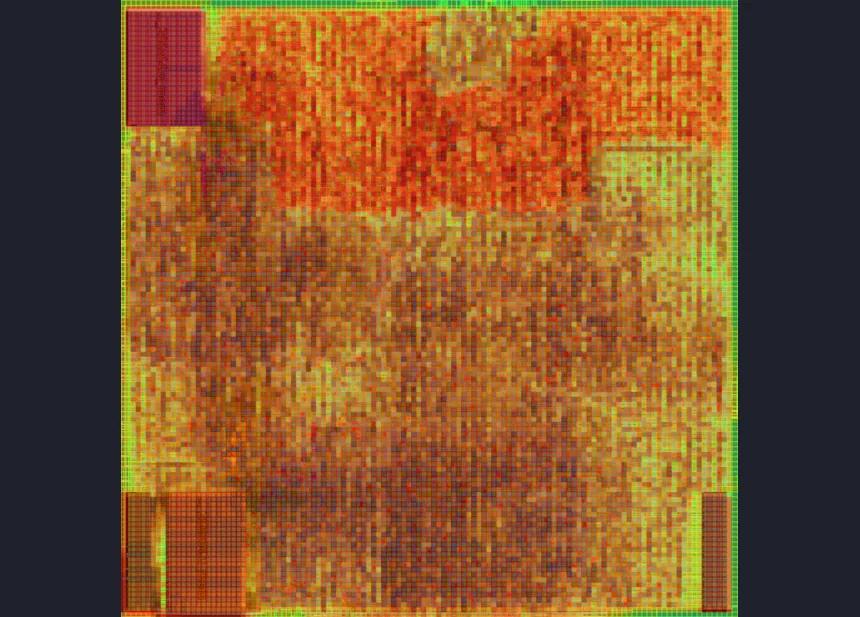
配線では、定数のタイネットを特別扱いにしてルーターがスキップするようにし、すべてのセルピンへの正しいアクセス方法を見つけ、粗いグリッド上で各ネットの経路を計画して混雑解消のために最大 100 回の追加パスを実行し、アンテナを修正し、10 パスの詳細配線で実際のメタルを描きます。バックグラウンドで約 16 分です(実行時間カードは 1 時間半と表示しますが、これは 8 スレッドの合計です)。
グローバル配線はオーバーフロー 0 で終わり、アンテナ修正で違反 291 個が 0 になり、詳細配線で違反は 8,985 個から 127 個に減ります。
このステージのタイミング表は飛ばしてください。route のレポートは理想クロックに戻っており、本当の数値ではありません。本当の数値はサインオフで出ます。
#9ポストルートのクリーンアップと DRC
 1:51
YouTube で見る(英語) ↗Bilibili で見る(中国語) ↗
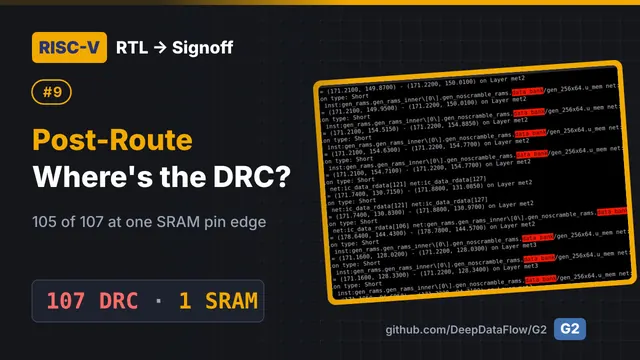
ポストルートはアンテナを修正し、ピンアクセスを計算し直し、詳細配線をさらに 5 パスとアンテナ修正ループを実行し、最後に独立した DRC チェックを行います。約 6 分で、違反 107 個、うちショート 62 個が残ります。ルーター自身の数は上下し、重複も含みます。DRC カードの数値は最後の独立チェックによるものです。
ほぼすべて、107 個中 105 個が、命令キャッシュのデータバンクである 1 つの SRAM と、そのすぐ隣のメタル 2 と 3 のネットにあります。この SRAM は 140 本の信号ピンすべてがメタル 3 の 1 辺に並び、スタンダードセルがその辺にぴったり詰め込まれているため、ルーターにはピンに入る余地がありません。パスを増やしても直りません。直すのはフロアプランです。
#10フィニッシュ:チップ全体と残りの課題
 2:48
YouTube で見る(英語) ↗Bilibili で見る(中国語) ↗
フィニッシュは行の空きをフィラーセルで埋め、配置と DRC をもう一度確認し、IR 解析を行い、DEF、ネットリスト、データベースを書き出します。抽出の行はコメントアウトされているので、ここでは SPEF を作りません。OpenRCX で作ります。結果は 98,222 インスタンス(うちフィラー 70,818)、DRC はポストルートと同じ 107 個(フィニッシュは再配線しません)、IR ドロップは最大約 0.11 mV です。
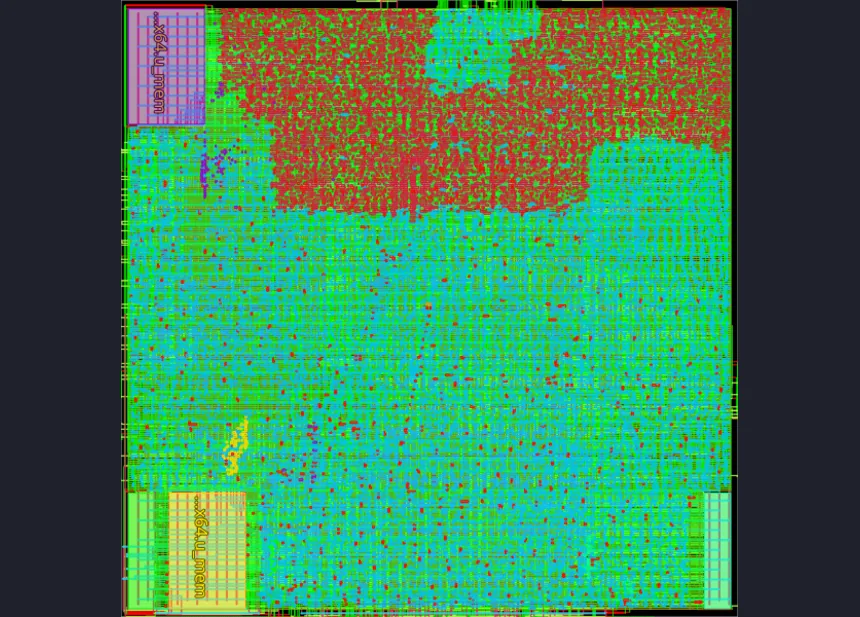
init から finish まですべてのステージが G2 の 1 ページにまとまり、それぞれにログ、レポート、カード、画像があり、すべて DDM にチェックインされています。スクリプトを 1 つ変えたら、そのステージから再実行して今回の結果と比較できます。
第 3 部:サインオフ
#11OpenRCX による寄生成分抽出
 2:16
YouTube で見る(英語) ↗Bilibili で見る(中国語) ↗
サインオフのタイミングには実際の配線、つまり配線済みのすべてのネットの抵抗と容量が必要です。G2 のフローページでは、OpenRCX は OpenROAD の隣にあります。そのスクリプトは完成したデータベース(apr_finish v02)を読み、プロジェクトが要求する各コーナー(低温から高温まで 4 つ)について、PDK spec にあるそのコーナーのルールファイルで抽出し、SPEF を 1 つずつ書き出します。
実行は 14 秒でエラーなし。ネット 18,670 本、抵抗 111,215 個、結合容量 206,593 個です。4 つの SPEF ファイルは同じサイズですが、これは正直な結果です。sky130 のオープンなルールファイルには RC モデルが 1 つしかなく、どのコーナーも同じ数値になります。量産用の PDK にはコーナーごとのルールファイルがあり、フローはすでにコーナーごとに SPEF を作るので、変えるのはそれだけです。SPEF はレイアウトと同じ DDM バージョンにチェックインされ、apr_finish v02 はネットリスト、DEF、寄生成分を持つようになります。
#12OpenSTA によるポストルートサインオフ
 5:14
YouTube で見る(英語) ↗Bilibili で見る(中国語) ↗
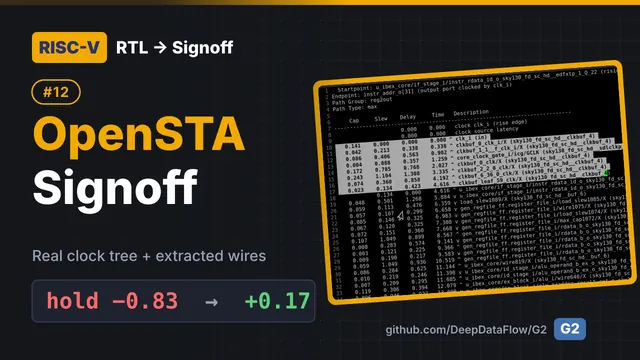
第 2 回では、理想クロック、配線なしの OpenSTA でネットリストを評価しました。今度は同じ OpenSTA が実際のレイアウトを受け取ります。サインオフ SDC はバージョン 2 になり、変更は 3 つです。OpenSTA が実際のクロックツリーをたどるようにプロパゲーテッドクロックを使うこと。スキューが測定済みになったので不確定性を小さくすること(セットアップは 1 ns から 0.5、ホールドは 0.2 から 0.1)。実際のスルーはツリーから来るのでクロックトランジションを外すことです。
OpenSTA を apr_finish v02 とその SPEF に向けます。実行前にもう 1 つ修正があります。元のスクリプトはセットアップしかチェックしないため、ホールドのカードは合否にかかわらず常に 0 と表示されます。シナリオに従うようにし、max コーナーでセットアップ、min コーナーでホールドをチェックします。そして Merge で両コーナーをまとめます。
セットアップ: reg2reg、in2reg、in2out はすべて通ります。reg2out はアドレス 8 ビットで 1.74 ns 足りません。 クロックをたどると、ポートから入り、バッファ 2 段、クロックゲート、さらに 4 段のツリーを通り、低速コーナーでフリップフロップに 4.6 ns 遅れて届きます。しかし出力バジェットは、ポートでの理想クロックから測った 10 ns のままなので、その 4.6 ns がそのままバジェットから差し引かれます。これは SoC の担当者と話し合う問題です。クロックレイテンシを考慮した出力遅延にするか、アドレスパスを速くするかです。(915 個の「SPEF エラー」は負荷のないネットで、不足している 5 つのライブラリセルはタイミングを持たないフィラーとタップセルです。)
ホールドは高速コーナーですべて通り、最も厳しいペアにも 0.17 ns の余裕があります。第 10 回では配線後のホールドが 0.83 ns 足りませんでしたが、それは見積もった配線による数値でした。抽出した配線ではホールドは通ります。だからこそ、見積もりではなく抽出でサインオフするのです。 スルー違反が 1 つ残っています。制限 1.5 ns に対して 2.2 ns です。
作ったもの、残っているもの
オープンソースツールだけで、RTL からサインオフまで、すべて G2 で行いました。DDM にはチップ全体があります。RTL、制約、2 つの論理合成バージョン、配置配線の全ステージ、寄生成分、2 つのサインオフ SDC。各ステップはそこから入力を取り出しました。
残った課題と、どこから手をつけるか。どれもスクリプトか SDC を 1 つ変えて、そのステップから再実行するだけです。
- 出力バジェット −1.74 ns。 SoC と合意すべき制約です。クロックレイテンシを考慮した出力遅延か、より速いアドレスパス。
- スルー違反 1 つ。 CTS 後にもう一度
repair_designを実行。 - 1 つの SRAM のピン辺に DRC 107 個。 フロアプランでマクロのハローを広げるか、手で配置。
- route ステージのタイミング表が理想クロック。 SDC を読んだ後にプロパゲーテッドクロックを設定。
- 全コーナーで RC モデルが 1 つ。 量産用 PDK で解決します。
動画を見る、次へ進む
- 動画: YouTube プレイリスト(英語)と Bilibili コレクション(中国語)。
- G2 が初めての方は G2 入門 から。
- 次のシリーズ: このコアは RISC-V SoC: ブロックからチップへ で、実際のチップの中のハードマクロになります。
- プロジェクト: G2_demo_sky130。G2 は無料の Community Edition で使えます。
- G2 や独自フローの実行に関するご質問: support@deepdataflow.com。ライセンスや協業について:sales@deepdataflow.com。