
模組不是晶片。在上一個系列 RISC-V 實戰:從 RTL 到簽核 裡,我們把一個 RISC-V 核心——lowRISC 的 Ibex——當作單一模組,從 RTL 做到簽核。這個系列,我們圍繞這個核心做出一顆晶片:加上記憶體和周邊、一個 PLL、真正的 IO pad,核心本身則作為硬核 macro 放進去。然後在 G2 裡完成整顆晶片的合成、佈局繞線與簽核。
這篇文章是 13 集影片的文字版。每一節包含該集影片、背後的決定,以及跑出來的數據。所有檔案都在 G2_demo_sky130 專案裡。
| 設計 | lowRISC Ibex Demo System:匯流排、RAM、GPIO、UART、SPI、PWM、計時器、JTAG 除錯 |
| 製程 | SkyWater 130 nm(sky130 HD 標準單元) |
| 工具 | Yosys、OpenROAD、OpenRCX、OpenSTA,全部在 G2 裡執行 |
| 晶片 | 1.8 × 1.8 mm die、58 個 pad、6 個 macro(核心、4 個 RAM、PLL),加入 filler 後共 115,854 個實例 |
| 結果 | hold 滿足;慢速 corner 的 setup 差 1.445 ns,即 24.1 MHz,目標是 25 MHz |
第一部分:晶片的組成
#1從模組到 SoC
 2:07
在 YouTube 觀看(英文) ↗在 Bilibili 觀看(中文) ↗
這顆 SoC 是 lowRISC 的 Ibex Demo System:匯流排、RAM、GPIO、UART、SPI、PWM、計時器和 JTAG 除錯模組,圍繞一個 Ibex 核心。它原本是為 FPGA 寫的。其中有兩樣會改:u_top 是核心,u_ram 是 128 KiB 的雙埠記憶體。
在 G2 裡,SoC 是一個新模組 ibex_demo_system。名字用底線,因為 G2 把模組名當作合成和佈局繞線的頂層模組名,而 Verilog 的名字不能有減號。一次點選就建好 spec 頁面,以及這個模組在實作、腳本和設計資料管理器(DDM)裡的目錄。層級上,SoC 是第 0 層,系列一做好的核心是它裡面的第 1 層。
第一個 spec 欄位是速度:25 MHz。核心在慢速 corner 簽核到 25.56 MHz,SoC 不可能比它的核心更快。標準單元欄位會開啟模組的 stdcell.cfg,流程讀的就是這個檔案,合成時會再用到這一點。
#2雙埠 RAM macro
 2:23
在 YouTube 觀看(英文) ↗在 Bilibili 觀看(中文) ↗
SoC 的 RAM 是 128 KiB、雙埠:一個埠給資料,一個給取指令。在 FPGA 上那是 block RAM;在晶片上它是一個記憶體 macro,而我們的元件庫裡只有核心指令快取用的單埠 RAM。
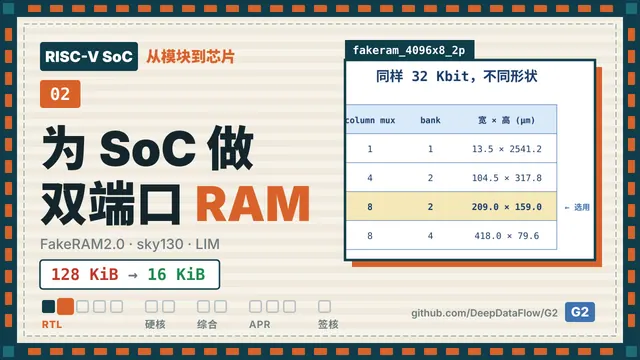
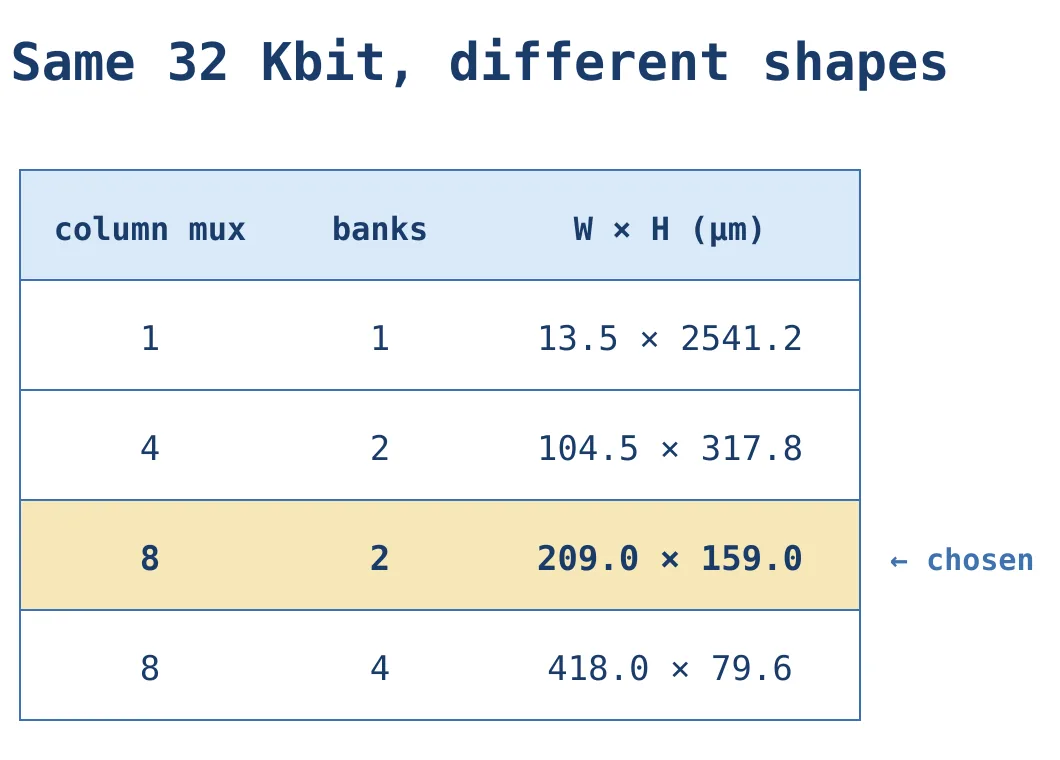
我們做了兩個決定。第一,16 KiB 對這個 demo 的軟體已經足夠,128 KiB 在 sky130 上會非常大。第二,生成器的雙埠 RAM 沒有位元組寫入遮罩,所以 32 位元記憶體由四個 8 位元寬的 macro 組成,一個位元組通道一個。
FakeRAM2.0 為一個並不存在的記憶體生成時序和版圖視圖,非常適合做流程。同樣的 32 Kbit 可以有完全不同的形狀:
一定要看生成的模型。這個模型先暫存位址再讀陣列,資料晚兩個週期才出來。liberty 和我們的 RAM wrapper 都說是一個週期,所以換成一個週期的模型。liberty 只有一個典型 corner,專案有四個 corner,所以我們寫四份,表頭放對應的電壓和溫度;每份的時序都一樣,和系列一的 RAM 做法相同。
在 G2 的元件庫管理器(LIM)裡,操作順序很重要:先 Find、再 Build all、最後 Fill。Fill 靠建好的頁面把每個 liberty 對應到 corner,先跑 Fill 就什麼都對不上。結果是兩個埠,各有 12 位元位址、8 位元資料,時脈到資料 0.218 ns。
#3讓 SoC 配合硬核
 2:04
在 YouTube 觀看(英文) ↗在 Bilibili 觀看(中文) ↗
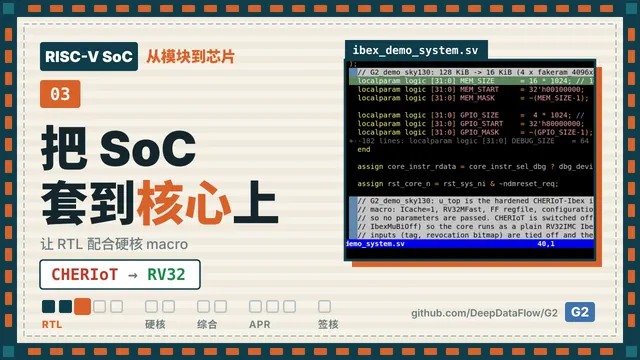
SoC 的 RTL 以 rtl v01 放進 DDM,從 demo 儲存庫複製,原儲存庫保持不動。問題來了:我們在系列一硬化的核心是 CHERIoT 版本的 Ibex,埠和這顆 SoC 對不上。它多了 SoC 完全不認識的 CHERIoT 和 lockstep 埠,而 SoC 還傳了做好的 macro 無法接受的參數。
我們保留 macro,改 SoC:
- 關掉 CHERIoT,讓核心跑成普通的 32 位元 RISC-V。
- 多出來的輸入接常數,多出來的輸出懸空。
- 拿掉參數,SoC 得到的就是我們硬化時的配置。
- RAM 縮小到 16 KiB,每一處修改都加了標記,方便以後找。
RAM wrapper 把 32 位元記憶體對應到四個位元組寬的 macro,每個位元組的寫使能就是它的遮罩位元。合成之前,先做一次快速的 elaboration 檢查,核心和 RAM 都當黑盒。少了一個選項,slang 就會停下來:除錯模組在宣告之前就用了一個訊號。模擬器放過它,slang 不放。加上選項後連結成功:一個核心、四個 RAM,埠名稱和寬度都和真正的 macro 吻合。
#4真實晶片的時脈
 2:19
在 YouTube 觀看(英文) ↗在 Bilibili 觀看(中文) ↗
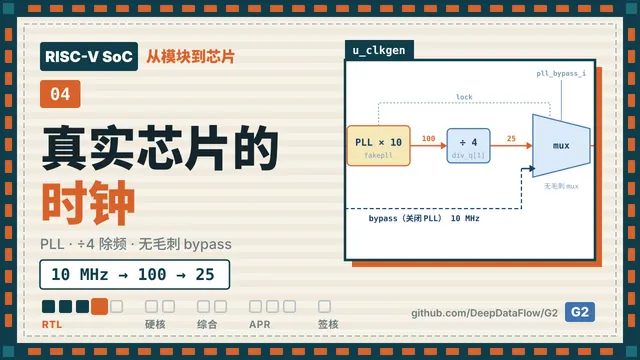
在 FPGA 板上,時脈從一個引腳進來。真正的晶片自己產生時脈:一個 10 MHz 的參考時脈、一個把它乘十的 PLL、一個降到 25 MHz 給核心用的除頻器,還有一個 bypass,PLL 不工作時晶片照樣能跑。
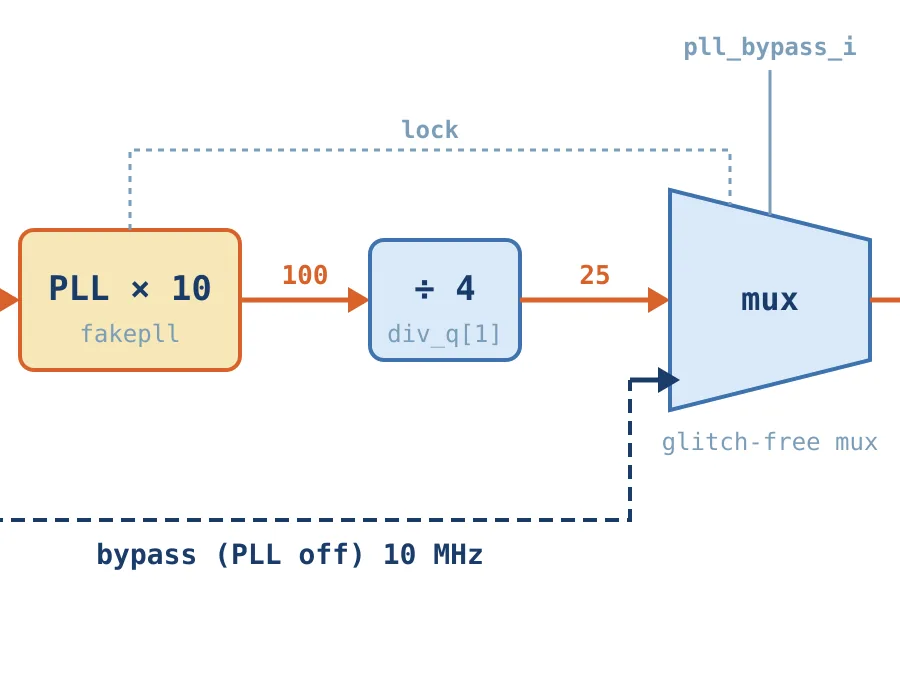
sky130 沒有我們能用的 PLL,所以像假 RAM 一樣做一個假 PLL:有看起來真實的版圖和時序視圖,裡面沒有電路。其中一個選擇是刻意的:參考時脈到輸出沒有時序弧。PLL 的輸出是一個新的時脈,約束會說明這一點。
時脈產生器 clkgen 是 rtl v02 裡需要小心的部分。一個兩位元計數器對 PLL 時脈除頻,最高位元就是 25 MHz 時脈。每個時脈有自己的時脈閘控,每個閘控的使能在自己的時脈域裡同步,而且要等另一個關掉才會開啟。重置之後先跑參考時脈,讓 PLL 鎖定。最後由重置同步器讓重置乾淨地釋放。
時脈變慢,SPI host 就出問題:25 MHz 除以 12.5 MHz 的 SPI 時脈,toggle 計數只剩一,計數器變成零位元。我們保持原來的比例,系統時脈的四分之一。還有三個要說清楚的地方:bypass 時 UART 的波特率不對;bypass 引腳只能在重置時改變;這個 PLL 只是替身。
#5真實的 pad
 2:41
在 YouTube 觀看(英文) ↗在 Bilibili 觀看(中文) ↗
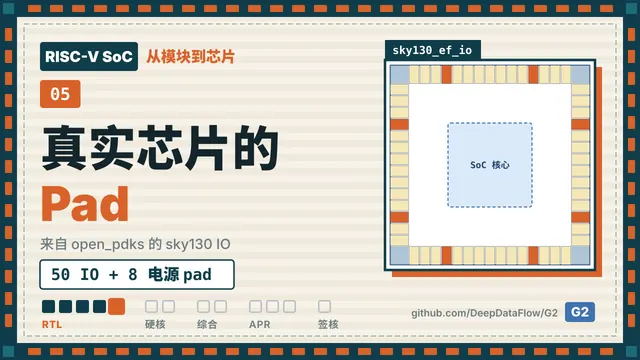
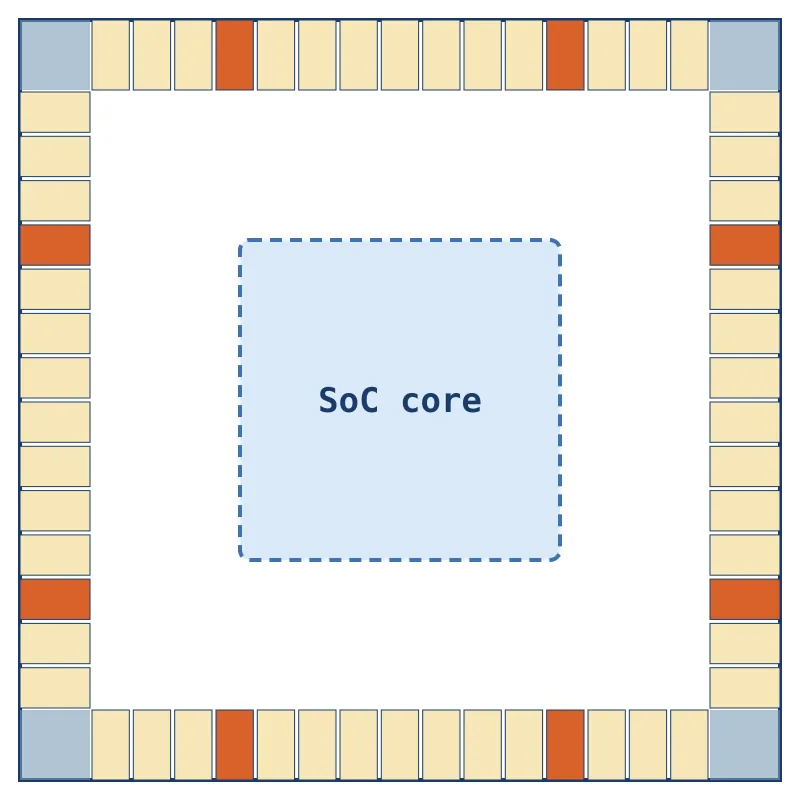
晶片透過 pad 和電路板溝通。skywater-pdk 裡 sky130 的 IO 元件庫有版圖和 Verilog,卻沒有時序,沒有時序就不能合成,也不能簽核。open_pdks 會建出完整的一套,包括每一顆 Caravel 晶片都在用的 Efabless 包裝 pad,每個 corner 都有時序。LibreLane 的 pad 設定告訴我們,一個驗證過的 sky130 pad ring 用哪些單元:通用 IO pad、帶 ESD clamp 的核心電源與 IO 電源 pad、一個 corner 單元,以及填充 slice。
一個小安裝腳本把五個單元複製到 G2 的 PDK,每個單元都有我們四個 corner 的 liberty。在 LIM 裡每個單元一個條目,因為一個條目每個 corner 只能放一個 liberty。二十個 liberty 檔案全部對上。(這裡發現 LIM 的兩個小 bug:Fill 會跳過符號連結,以及頁面標題錯誤。)
rtl v03 的晶片頂層保留 SoC 的埠名稱,現在都是 bond pad:50 個訊號 pad、8 個電源 pad。pad wrapper 的高壓使能來自 pad 自己的 tie-high 和 tie-low 輸出,和 Caravel 的做法一樣。順便處理一件事:三個 128 位元組、用 flip-flop 做的 FIFO 幾乎佔了整顆晶片三分之二的 flip-flop,每個都縮成 16 個 entry。
第二部分:把核心變成硬核 macro
#6讓模組成為合格的 macro
 2:50
在 YouTube 觀看(英文) ↗在 Bilibili 觀看(中文) ↗
硬核模組有一條規則:頂層金屬歸上一層。 macro 的 abstract 視圖會擋住模組用到的每一層金屬。系列一的核心把 metal 5 用在電源網格和繞線上,所以整個 macro 在 metal 5 上都被封住了。晶片在 metal 5 上的電源 strap 到它邊緣就停了,我們練習時,晶片層級的電源檢查就報告核心的電源引腳沒有連接。核心會一直沒有電。
解決辦法是一個慣例:模組只用到 metal 4,晶片直接從 metal 5 在模組的 metal 4 電源引腳上打 via。我們把核心重跑成 build v03,系列一的 build 保持不動,腳本有三處修改:
- 訊號和時脈的繞線都只到 metal 4。
- 每個 stage 都讀這些設定,不只是 floorplan。
- 電源網格去掉 metal 5 的 strap。floorplan 腳本現在也會找設計自己的電源腳本,以及晶片會用到的 pad ring 腳本。
繞線花了十四分鐘,結果是 120 個違規,比之前少一點,還有我們要的那一行:metal 5 上的線長是 0 µm。post-route 和 finish 之後是 130 個違規,這是少一層金屬的代價,對 demo 來說沒問題。
#7從模組到硬核 macro
 2:49
在 YouTube 觀看(英文) ↗在 Bilibili 觀看(中文) ↗
上一層設計需要硬核模組的三種視圖:寄生參數、每個 corner 的時序模型,以及 abstract 版圖。
- 寄生參數:OpenRCX 在一分鐘內完成新版圖四個 corner 的提取。
- 時序模型:OpenSTA 的
write_timing_model把整個核心寫成一個單元:輸入上的 setup 和 hold 檢查、包含它自己時脈樹的時脈到輸出延遲,還有時脈樹延遲本身。原本的腳本讓每個 corner 的模型同名,corner 之間會衝突,所以我們用 corner 來命名。要注意:模型裡的面積是單元面積,不是 macro 的佔地面積。 - abstract LEF:繞線器當作電源的 tie net 要改回訊號,不然會變成空的電源引腳。abstract 擋住模組用到的每一層,電源引腳只保留 metal 4。原始的 abstract 列出幾千個內部電源形狀,卻沒有把它們連起來的 via,到了上一層看起來就是浮空的。
結果是一個 850 × 850 µm 的 macro,930 個引腳,電源在 metal 4,metal 5 上什麼都沒有。各視圖也一致:LEF、網表和時序模型都是 928 個訊號位元。核心以硬核 IP 放進 LIM。兩個 corner 對上了,就是我們簽核過的那兩個;另外兩個沒有時序模型,不會用到。
第三部分:約束與合成
#8為真實晶片寫約束
 2:14
在 YouTube 觀看(英文) ↗在 Bilibili 觀看(中文) ↗
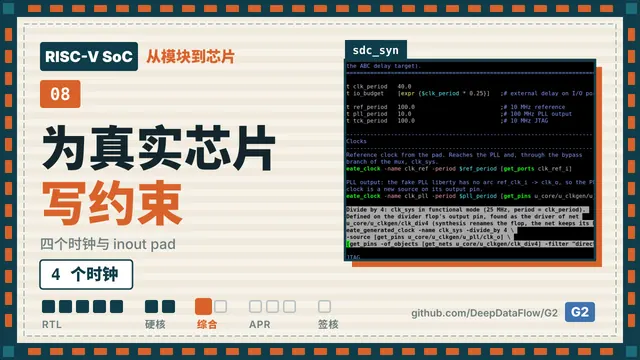
合成約束 sdc_syn v01 由一個數字驅動:系統時脈 40 ns。總共有四個時脈。參考時脈在它的引腳上。PLL 輸出是定義在 PLL 輸出引腳上的新時脈,這就是假 PLL 沒有時序弧的原因。系統時脈從它生成,除以四:
create_clock -name clk_ref -period $ref_period [get_ports clk_ref_i]
create_clock -name clk_pll -period $pll_period [get_pins u_core/u_clkgen/u_pll/clk_o]
create_generated_clock -name clk_sys -divide_by 4 \
  -source [get_pins u_core/u_clkgen/u_pll/clk_o] \
  [get_pins -of_objects [get_nets u_core/u_clkgen/clk_div4] -filter "direction == output"]
create_clock -name clk_tck -period $tck_period [get_ports tck_i]
合成會改 flop 的名字,從 RTL 複製來的 flop 名稱在網表裡不會存在。net 會保留名字,所以我們找驅動除頻時脈 net 的那個引腳。JTAG 是自己的時脈;三組時脈彼此非同步,因為 mux 的控制訊號經過同步器。
功能模式下 PLL 是開的,而只對 bypass 引腳做 case analysis 是不夠的。bypass 時脈閘控的使能來自一個 flop,不是常數,所以參考時脈還是會漏到每個系統 flop 上:4,599 個引腳有兩個時脈。關掉 bypass 閘控的時脈弧之後,每個 flop 就只有一個時脈:
set_case_analysis 0 [get_ports pll_bypass_i]
set_disable_timing -from CLK -to GCLK [get_cells u_core/u_clkgen/u_icg_ref/icg]
現在每個埠都是 bond pad,是 inout,所以時序分析把每個 pad 同時看成輸入和輸出。pad 不用的方向給零延遲並排除,就不會意外留下沒有約束的路徑。輸出 pad 驅動 5 pF 的板級負載。
#9合成整顆晶片
 2:19
在 YouTube 觀看(英文) ↗在 Bilibili 觀看(中文) ↗
晶片有一個新的實作 build:rtl v03 加上第 8 集的約束。G2 從 spec 收集元件庫,每個 corner 9 個:標準單元、RAM、核心的時序模型、PLL 和五個 pad 單元。它們來自 spec 的元件庫檔案,也就是編輯器寫的那些,所以前面要用編輯器。原本的 Yosys 腳本在 sky130 上用錯誤的名字統計 flop;系列一已經修好了,我們沿用它的腳本,包括時序驅動的那個。
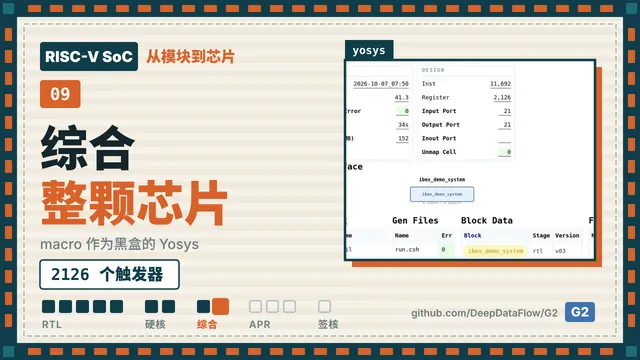
執行約 40 秒:沒有錯誤、沒有未映射的單元,11,692 個實例、2,126 個正反器,每個 macro 和 pad 都以黑盒出現在網表裡。接著讓約束對上網表。有 22 個沒有約束的端點,每一個都在預期之中:輸入 pad 不用的那一側,以及電源 pad。每個時脈都到達它該到的 flop。
佈局前的時序要如實解讀。系統時脈的 setup 是 −10.4 ns、重置 recovery 是 −21.4 ns,因為重置同步器完全沒有 buffer 就驅動了 1,316 個 flop,slew 是 40.9 ns。合成不會幫這條 net 加 buffer,placement 會。把這一條 net 排除,所有時脈都滿足時序。
第四部分:晶片的佈局繞線
#10pad ring 與晶片電源
 2:35
在 YouTube 觀看(英文) ↗在 Bilibili 觀看(中文) ↗
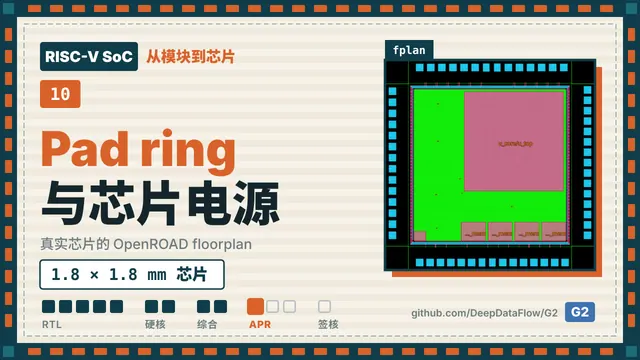
佈局繞線的約束和合成的一樣,只改一處:板級訊號用 transition 驅動輸入 pad,不用標準單元,因為沒有標準單元能驅動 pad。die 是 1.8 mm 見方,core 是 1.3 mm。58 個 pad 每邊至少需要 1.6 mm,所以決定尺寸的是 pad,不是邏輯。
pad ring 腳本在 die 四周放 IO site,然後依序、等距放每一邊的 pad,再加上 corner、填充 slice、abutment,以及每個埠的 bond pad 端子。有一個順序很關鍵:先命名 pad 電源,再做 abutment。否則 abutment 會自己產生 ring net,電源 pad 永遠接不到核心電源,之後也沒有任何步驟能修正。
# 先連接 pad 電源(add_global_connection ...),然後:
global_connect
connect_by_abutment
place_io_terminals {*/PAD */VCCD_PAD */VSSD_PAD */VDDIO_PAD */VSSIO_PAD}
電源網格加上 pad 電源、接到電源 pad 的 core ring,以及延伸到 ring 的 stripe。少了 -extend_to_core_ring,stripe 會停在 ring 之前,整個核心網格都是浮空的。這兩個問題都是我們練習時吃過虧才發現的。
add_pdn_stripe -grid {grid} -layer {met5} -width {1.600} -pitch {27.200} -offset {13.600} -extend_to_core_ring
add_pdn_ring -grid {grid} -layers {met4 met5} -widths {10.0 10.0} -spacings {2.0 2.0} \
  -core_offsets {10.0 10.0} -connect_to_pads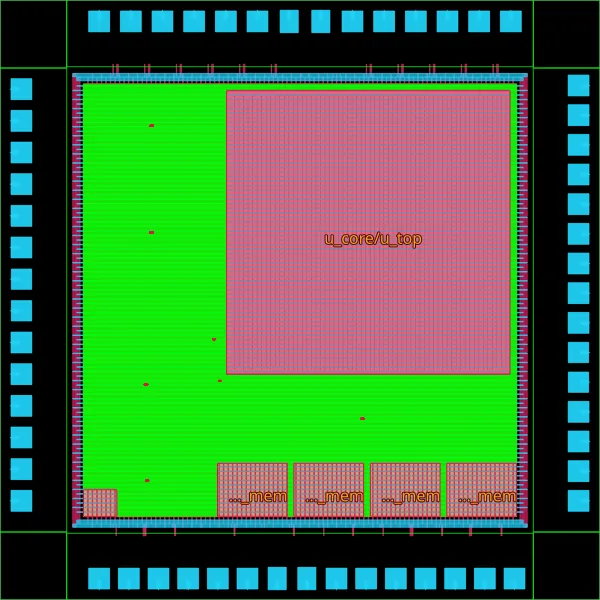
這就是第 6 集的回報:32 條 metal 5 電源 strap 跨過核心,900 個 via 打到它的 metal 4 電源引腳上。
#11Placement、CTS 與 post-CTS
 2:05
在 YouTube 觀看(英文) ↗在 Bilibili 觀看(中文) ↗
placement 之後電源檢查通過:電源上的每個形狀都連上了。練習時,直到網格接到 ring、核心空出 metal 5 之前,這個檢查一直失敗,所以前面要先做那些修正。
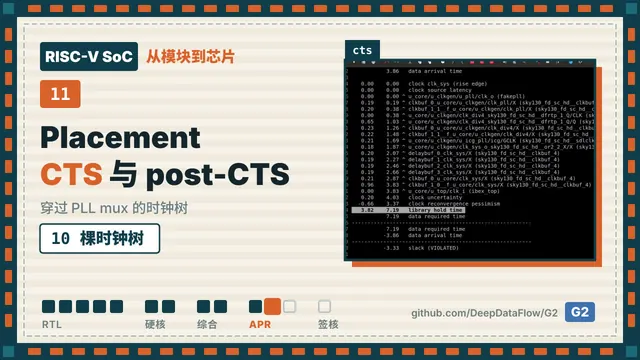
CTS 建了十棵時脈樹。系統時脈從無毛刺 mux 出來,到達九個 macro 時脈引腳和 1,892 個 flop;JTAG 有自己的時脈樹。
接著是層級設計的部分。核心的時序模型說,它自己的時脈樹在 macro 裡面又加了五奈秒以上:到引腳 3.8 ns,裡面再加 5.6 ns。核心裡的 flop 比 RAM 晚很多才看到時脈,結果在核心的輸入端出現 −3.3 ns 的 hold 違規。post-CTS 修復插入 317 個 hold buffer,修好所有 hold 違規,包括核心的。
剩下一個 setup 違規,在除頻器。除頻器自己的輸出現在是一條時脈樹 net,它經過這棵樹以 100 MHz 回授回自己的計數器。真正的設計會從另一個 flop 回授;我們記下來,繼續往前。
#12繞線與完成
 0:54
在 YouTube 觀看(英文) ↗在 Bilibili 觀看(中文) ↗
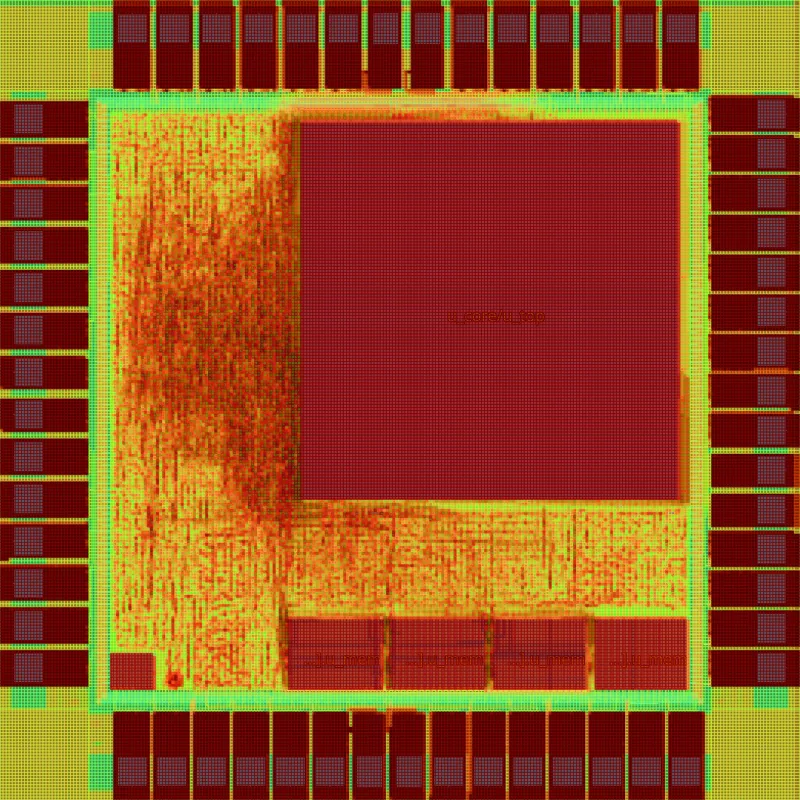
整顆晶片繞線大約十分鐘,結果只有一個違規,線長 1.07 m、106,115 個 via。單獨的核心有 120 個:晶片的 core 有空間,而且 macro 上方的 metal 5 對晶片是開放的。post-route 清理和 finish(加入 filler,寫出最終網表和版圖)之後剩 2 個違規,沒有短路。finish 列印的時序還是理想時脈,真正的數字要到簽核才有。
第五部分:簽核
#13晶片簽核
 2:56
在 YouTube 觀看(英文) ↗在 Bilibili 觀看(中文) ↗
簽核從真實連線開始:OpenRCX 用 18 秒提取四個 corner。簽核約束使用傳播時脈,讓真實的時脈樹算進去,uncertainty 也更小,因為 skew 已經不用猜了。
有一節只有帶真實 pad 的晶片才需要。pad 的時序取決於它的驅動模式。我們的 RTL 把那些引腳接成常數,但經過的是沒有驅動的 net,時序分析看不到它們的值,就假設最慢的模式。沒有 pad 模式時,輸出 pad 要 120 ns,晶片差了 102 ns;加上之後只要 6.9 ns,還有 12.2 ns 的餘量。
接著用 OpenSTA 分析整顆晶片:核心是它的時序模型,每個 pad、RAM 和 PLL 都來自 LIM。合併後的結果:
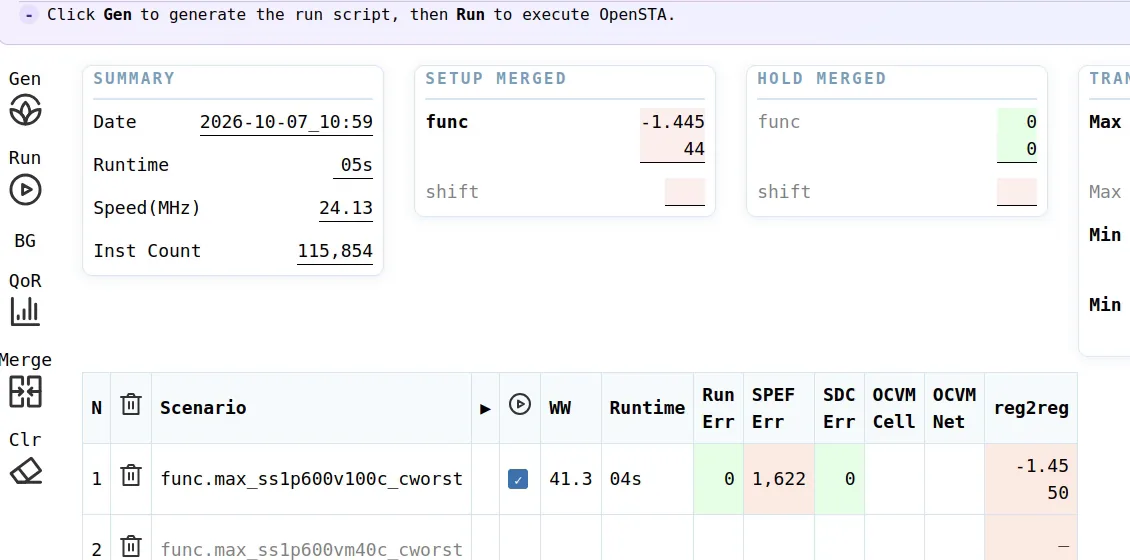
最差路徑正是這個系列的一課。時脈在 7.8 ns 到達核心。核心的時序模型說,它的資料位址在 27.9 ns 之後才出來:它自己的時脈樹加上它的邏輯。這樣 SoC 只剩大約 12 ns 給匯流排和除錯記憶體,而它需要 13.5 ns。用模組搭晶片時,每個模組的輸出時序都是晶片必須接受的預算。晶片跑在約 24.1 MHz,而不是 25 MHz。
我們做了什麼,還剩下什麼
從系列一的一個核心,到一顆晶片:雙埠 RAM、帶安全 bypass 的 PLL、58 個真實 pad、為晶片留出空間的硬核 macro、合成、佈局繞線與簽核。全部在 G2 裡完成,每一次交接都經過設計資料管理器和元件庫管理器。
遺留問題,以及從哪裡著手:
- 核心邊界 setup −1.45 ns。這是核心 clock-to-output 的預算;下一步是更快的核心,或在匯流排邊界加暫存器。
- 輸出 pad 的 slew。pad 的 transition 表不區分模式,這是元件庫建模的限制。
- PLL 支路上偏小的時脈閘控(max capacitance)。
- 100 MHz 時脈域裡除頻器的回授。
- 兩個 DRC 違規,而且這個系列不做 DRC、LVS 或 GDS 簽核。
觀看與動手
- 影片:Bilibili 合集(中文)與 YouTube 播放清單(英文)。
- 本系列使用的核心:RISC-V 實戰:從 RTL 到簽核。
- 下一個系列:RISC-V 覆晶實戰:從焊墊到凸塊,拿掉 pad ring,把這顆 wirebond 晶片和覆晶版本做比較。
- 專案:G2_demo_sky130。G2 本身有免費的社群版。
- 關於 G2 或自己跑流程的問題:support@deepdataflow.com。授權與合作:sales@deepdataflow.com。