
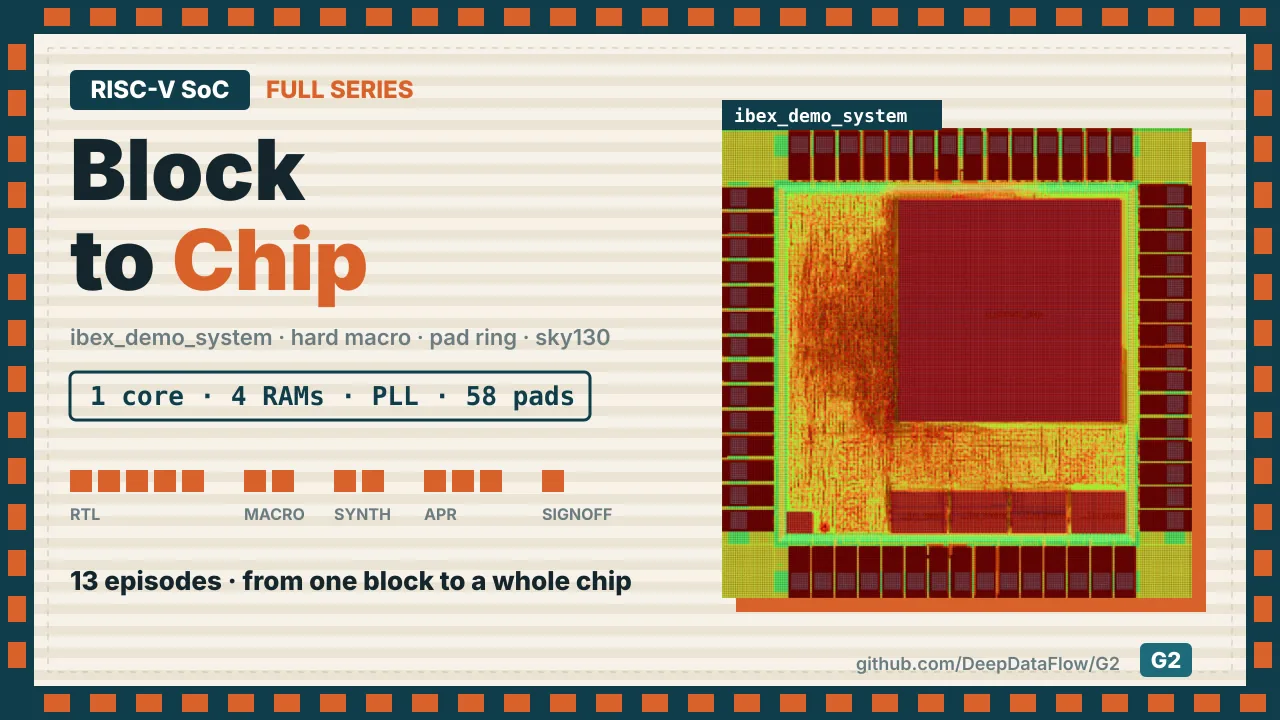
블록은 칩이 아닙니다. 이전 시리즈 RISC-V RTL-to-Signoff에서는 RISC-V 코어인 lowRISC의 Ibex를 하나의 블록으로 RTL부터 사인오프까지 진행했습니다. 이번 시리즈에서는 그 코어를 중심으로 칩을 만듭니다. 메모리와 주변장치, PLL, 실제 IO 패드를 더하고, 코어 자체는 하드 매크로로 넣습니다. 그리고 칩 전체의 합성, 배치 배선, 사인오프를 G2에서 진행합니다.
이 글은 동영상 13편의 글 버전입니다. 각 섹션에는 해당 에피소드 동영상, 그 뒤에 있는 결정, 그리고 실제로 나온 수치를 담았습니다. 모든 파일은 G2_demo_sky130 프로젝트에 있습니다.
| 설계 | lowRISC Ibex Demo System: 버스, RAM, GPIO, UART, SPI, PWM, 타이머, JTAG 디버그 |
| 공정 | SkyWater 130 nm (sky130 HD 표준 셀) |
| 도구 | Yosys, OpenROAD, OpenRCX, OpenSTA. 모두 G2에서 실행 |
| 칩 | 1.8 × 1.8 mm 다이, 패드 58개, 매크로 6개(코어, RAM 4개, PLL), 필러 삽입 후 인스턴스 115,854개 |
| 결과 | 홀드 충족. 셋업은 저속 코너에서 −1.445 ns로, 목표 25 MHz 대신 24.1 MHz |
1부: 칩의 구성 요소
#1블록에서 SoC로
 2:02
YouTube에서 보기(영어) ↗Bilibili에서 보기(중국어) ↗
이 SoC는 lowRISC의 Ibex Demo System입니다. Ibex 코어 하나를 중심으로 버스, RAM, GPIO, UART, SPI, PWM, 타이머, JTAG 디버그 모듈이 있습니다. 원래 FPGA용으로 작성된 설계입니다. 이 중 두 가지를 바꿉니다. u_top이 코어이고, u_ram은 128 KiB 듀얼 포트 메모리입니다.
G2에서 SoC는 새 블록 ibex_demo_system이 됩니다. 이름에 언더스코어를 쓰는 이유는 G2가 블록 이름을 합성과 배치 배선의 톱 모듈 이름으로 쓰는데, Verilog 이름에는 하이픈을 쓸 수 없기 때문입니다. 클릭 한 번으로 spec 페이지와 함께 구현, 스크립트, 설계 데이터 관리자(DDM)의 폴더가 만들어집니다. 계층에서는 SoC가 레벨 0, 시리즈 1에서 만든 코어가 그 안의 레벨 1입니다.
첫 번째 spec 항목은 속도, 25 MHz입니다. 코어는 저속 코너에서 25.56 MHz로 사인오프되었고, SoC는 코어보다 빠를 수 없습니다. 표준 셀 항목은 블록의 stdcell.cfg를 열며, 흐름이 읽는 것이 바로 이 파일입니다. 합성에서 이 점이 다시 중요해집니다.
#2듀얼 포트 RAM 매크로
 2:25
YouTube에서 보기(영어) ↗Bilibili에서 보기(중국어) ↗
SoC의 RAM은 128 KiB 듀얼 포트로, 하나는 데이터용, 하나는 명령어 페치용입니다. FPGA에서는 블록 RAM이지만 칩에서는 메모리 매크로이고, 라이브러리에는 코어의 명령어 캐시용 싱글 포트 RAM밖에 없습니다.
두 가지를 결정했습니다. 첫째, 데모 소프트웨어에는 16 KiB면 충분하고 128 KiB는 sky130에서 너무 큽니다. 둘째, 생성기의 듀얼 포트 RAM에는 바이트 쓰기 마스크가 없어서, 32비트 메모리를 바이트 레인마다 하나씩 8비트 폭 매크로 4개로 구성합니다.
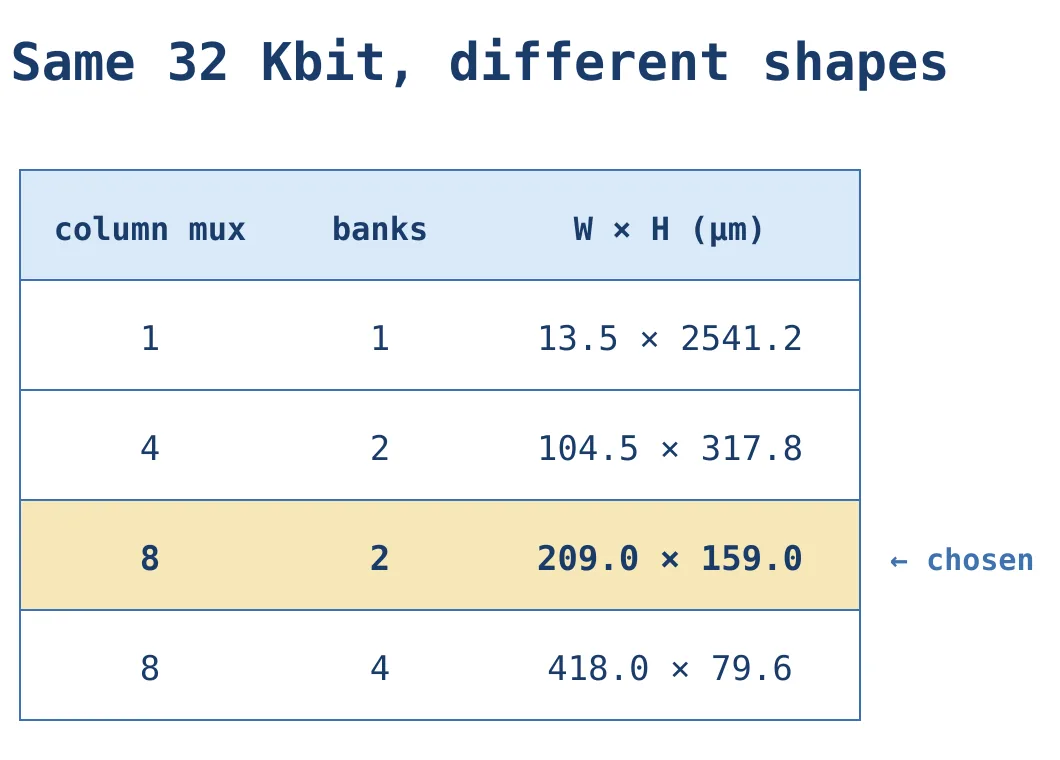
FakeRAM2.0은 실제로 존재하지 않는 메모리의 타이밍 뷰와 레이아웃 뷰를 만들어 주므로, 흐름 작업에 딱 맞습니다. 같은 32 Kbit라도 모양은 크게 달라집니다.
생성된 모델은 반드시 읽어 보세요. 이 모델은 주소를 레지스터에 저장한 뒤 어레이를 읽기 때문에 데이터가 2사이클 늦게 나옵니다. liberty와 RAM 래퍼는 모두 1사이클이므로 1사이클 모델로 교체합니다. liberty는 일반 코너 하나로만 나오는데 프로젝트에는 코너가 네 개 있으므로, 헤더에 맞는 전압과 온도를 넣은 사본 네 개를 만듭니다. 타이밍은 모두 같으며, 시리즈 1의 RAM과 같은 방식입니다.
G2의 라이브러리 관리자(LIM)에서는 작업 순서가 중요합니다. Find, Build all, 마지막으로 Fill 순서입니다. Fill은 만들어 둔 페이지를 이용해 각 liberty를 코너에 대응시키므로, 먼저 실행하면 아무것도 맞지 않습니다. 결과는 포트 2개로, 각각 주소 12비트, 데이터 8비트이고 클록에서 데이터까지 0.218 ns입니다.
#3하드 코어에 SoC 맞추기
 2:07
YouTube에서 보기(영어) ↗Bilibili에서 보기(중국어) ↗
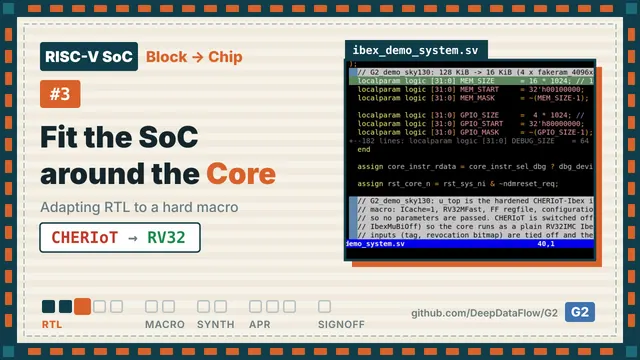
SoC의 RTL은 rtl v01로 DDM에 넣습니다. 데모 저장소에서 복사하며, 원래 저장소는 건드리지 않습니다. 여기서 문제가 생깁니다. 시리즈 1에서 하드닝한 코어는 CHERIoT 버전의 Ibex라서 포트가 이 SoC와 맞지 않습니다. SoC가 모르는 CHERIoT와 락스텝 포트가 있고, SoC는 완성된 매크로가 받을 수 없는 파라미터를 넘깁니다.
매크로는 그대로 두고 SoC를 수정합니다.
- CHERIoT를 끄고 코어를 일반 32비트 RISC-V로 동작시킵니다.
- 남는 입력은 상수로 묶고, 남는 출력은 열어 둡니다.
- 파라미터를 제거해, 하드닝할 때의 구성을 그대로 SoC에 줍니다.
- RAM을 16 KiB로 줄입니다. 모든 수정에 태그를 달아 나중에 찾을 수 있게 합니다.
RAM 래퍼는 32비트 메모리를 바이트 폭 매크로 4개에 매핑하고, 각 바이트의 쓰기 인에이블이 그 마스크 비트가 됩니다. 합성 전에 코어와 RAM을 블랙박스로 두고 간단한 엘라보레이션 검사를 합니다. 옵션 하나가 빠지면 slang이 멈춥니다. 디버그 모듈이 선언 전에 신호를 쓰기 때문입니다. 시뮬레이터는 넘어가지만 slang은 넘어가지 않습니다. 옵션을 넣으면 링크가 통과합니다. 코어 1개와 RAM 4개이며, 포트 이름과 폭이 실제 매크로와 일치합니다.
#4실제 칩의 클록
 2:19
YouTube에서 보기(영어) ↗Bilibili에서 보기(중국어) ↗
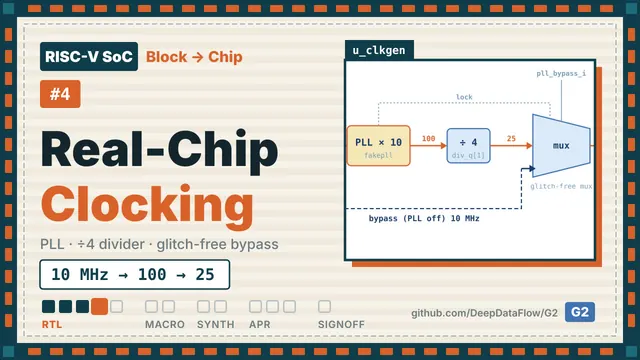
FPGA 보드에서는 클록이 핀으로 들어왔습니다. 실제 칩은 스스로 클록을 만듭니다. 10 MHz 레퍼런스, 이를 10배로 올리는 PLL, 코어용으로 25 MHz까지 낮추는 분주기, 그리고 PLL이 동작하지 않아도 칩이 돌아가도록 하는 바이패스입니다.
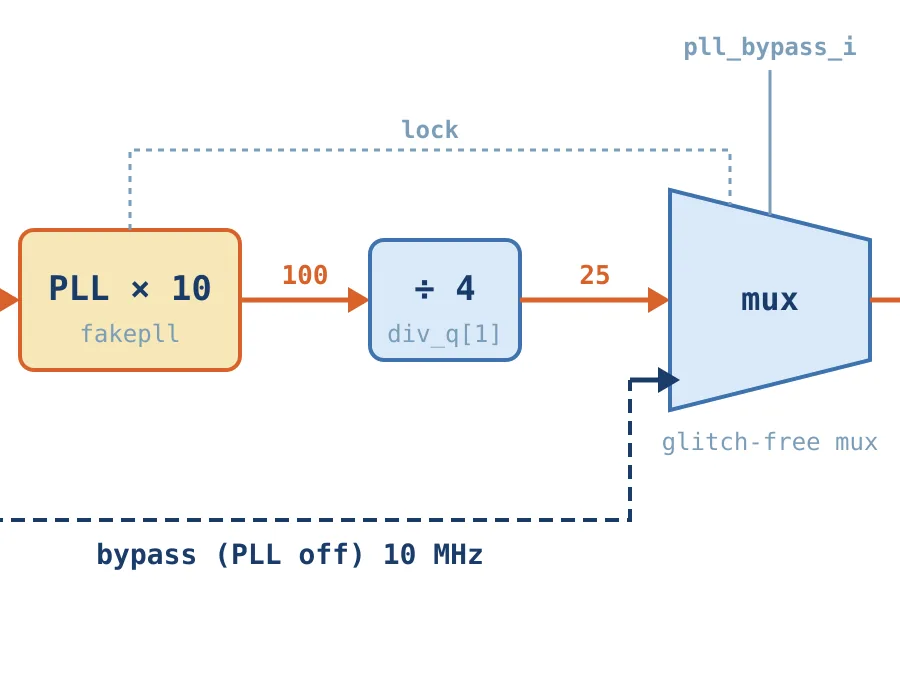
sky130에는 쓸 수 있는 PLL이 없어서, 가짜 RAM처럼 가짜 PLL을 만듭니다. 현실적인 레이아웃 뷰와 타이밍 뷰가 있고 안에 회로는 없습니다. 한 가지는 의도적인 선택입니다. 레퍼런스에서 출력으로 가는 타이밍 아크가 없습니다. PLL의 출력은 새로운 클록이고, 제약 조건에서 그렇게 정의합니다.
클록 생성기 clkgen은 rtl v02에서 가장 주의가 필요한 부분입니다. 2비트 카운터가 PLL 클록을 분주하고, 최상위 비트가 25 MHz 클록이 됩니다. 각 클록에는 전용 클록 게이트가 있고, 각 게이트의 인에이블은 자기 클록 도메인에서 동기화되며, 다른 쪽이 꺼진 뒤에야 켜집니다. 리셋 직후에는 PLL이 락될 때까지 레퍼런스로 동작합니다. 마지막으로 리셋 동기화기가 리셋을 깔끔하게 해제합니다.
클록이 느려지자 SPI 호스트가 깨집니다. 25 MHz를 12.5 MHz SPI 클록으로 나누면 토글 카운트가 1이 되고 카운터가 0비트가 됩니다. 원래 비율인 시스템 클록의 4분의 1을 유지합니다. 주의할 점이 세 가지 있습니다. 바이패스에서는 UART 보레이트가 맞지 않고, 바이패스 핀은 리셋 중에만 바꿀 수 있으며, PLL은 대체품입니다.
#5실제 패드
 2:40
YouTube에서 보기(영어) ↗Bilibili에서 보기(중국어) ↗
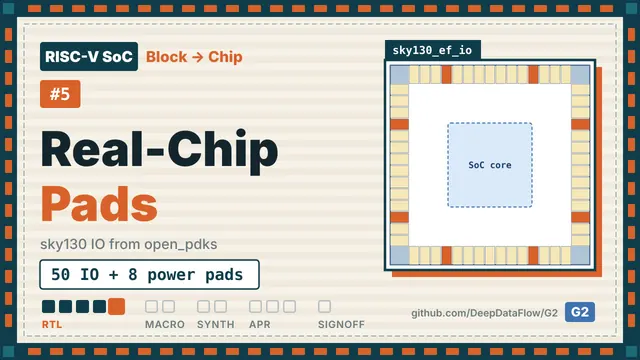
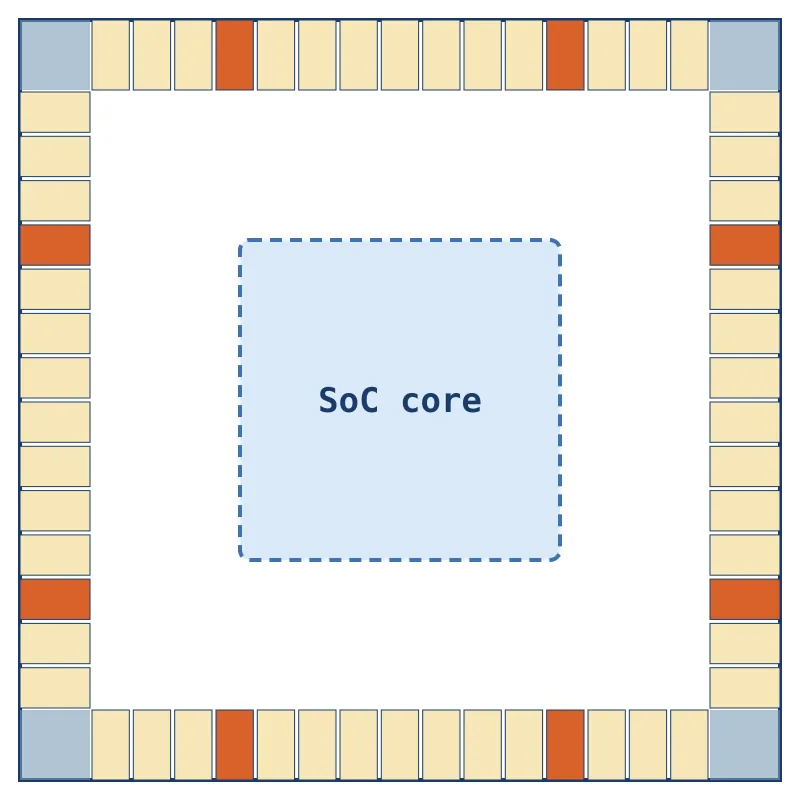
칩은 패드를 통해 보드와 통신합니다. skywater-pdk의 sky130 IO 라이브러리에는 레이아웃과 Verilog는 있지만 타이밍이 없습니다. 타이밍 없이는 합성도 사인오프도 할 수 없습니다. open_pdks는 모든 Caravel 칩이 쓰는 Efabless의 래핑된 패드를 포함한 전체 세트를, 모든 코너의 타이밍과 함께 만들어 줍니다. LibreLane의 패드 설정을 보면 검증된 sky130 패드 링이 어떤 셀을 쓰는지 알 수 있습니다. 범용 IO 패드, ESD 클램프가 있는 코어 전원 패드와 IO 전원 패드, 코너 셀, 필러 슬라이스입니다.
작은 설치 스크립트가 셀 5개를 G2의 PDK에 복사합니다. 각 셀에는 4개 코너의 liberty가 있습니다. LIM에서는 하나의 항목이 코너마다 liberty를 하나만 가질 수 있어서 셀마다 항목을 만듭니다. liberty 파일 20개가 모두 맞았습니다. (여기서 LIM의 작은 버그 두 개를 찾았습니다. Fill이 심볼릭 링크를 건너뛰는 것과 페이지 제목 오류입니다.)
rtl v03의 칩 톱은 SoC의 포트 이름을 그대로 쓰며, 이제 모두 본딩 패드입니다. 신호 패드 50개와 전원 패드 8개입니다. 패드 래퍼의 고전압 인에이블은 Caravel과 마찬가지로 패드 자체의 tie-high와 tie-low 출력에서 가져옵니다. 그리고 플립플롭으로 만든 128바이트 FIFO 세 개가 칩 전체 플립플롭의 거의 3분의 2를 차지하고 있어서, 각각 16엔트리로 줄였습니다.
2부: 코어를 하드 매크로로
#6블록을 매크로로 쓸 수 있게
 2:51
YouTube에서 보기(영어) ↗Bilibili에서 보기(중국어) ↗
하드 블록에는 규칙이 있습니다. 최상위 메탈은 부모의 몫입니다. 매크로의 abstract 뷰는 블록이 쓰는 모든 메탈 층을 막습니다. 시리즈 1의 코어는 전원 그리드와 배선에 메탈 5를 썼기 때문에 매크로 전체가 메탈 5에서 막혀 있었습니다. 칩의 메탈 5 전원 스트랩은 그 가장자리에서 멈췄고, 연습 때 칩 레벨 전원 검사는 코어의 전원 핀이 연결되지 않았다고 보고했습니다. 코어에 전원이 들어가지 않는 것입니다.
해결책은 관례를 따르는 것입니다. 블록은 메탈 4까지만 쓰고, 칩이 메탈 5에서 블록의 메탈 4 전원 핀으로 비아를 바로 내립니다. 시리즈 1의 빌드는 그대로 두고 코어를 빌드 v03으로 다시 돌렸습니다. 스크립트 변경은 세 가지입니다.
- 신호와 클록의 배선을 메탈 4까지로 제한합니다.
- 플로어플랜뿐 아니라 모든 단계가 그 설정을 읽습니다.
- 전원 그리드에서 메탈 5 스트랩을 뺍니다. 플로어플랜 스크립트는 이제 설계 자체의 전원 스크립트와, 칩이 쓸 패드 링 스크립트도 찾습니다.
배선에 14분이 걸렸고, 위반은 120개로 이전보다 조금 줄었습니다. 그리고 원하던 한 줄, 메탈 5의 배선 길이는 0 µm입니다. 포스트 라우트와 피니시 후에는 위반 130개입니다. 층 하나를 덜 쓴 대가이며 데모로는 괜찮습니다.
#7블록에서 하드 매크로로
 2:48
YouTube에서 보기(영어) ↗Bilibili에서 보기(중국어) ↗
부모 설계에는 하드 블록의 세 가지 뷰가 필요합니다. 기생 성분, 코너별 타이밍 모델, abstract 레이아웃입니다.
- 기생 성분: OpenRCX가 새 레이아웃의 4개 코너를 1분 안에 추출합니다.
- 타이밍 모델: OpenSTA의
write_timing_model이 코어를 하나의 셀로 씁니다. 입력의 셋업·홀드 검사, 자체 클록 트리를 포함한 클록-출력 지연, 그리고 클록 트리 레이턴시 자체입니다. 원래 스크립트는 모든 코너의 모델에 같은 이름을 붙여서 코너끼리 충돌했습니다. 코너 이름으로 명명하도록 바꿨습니다. 모델의 면적은 셀 면적이지 매크로가 차지하는 면적이 아니라는 점에 주의하세요. - abstract LEF: 라우터가 전원으로 취급한 타이 넷을 신호로 되돌립니다. 그러지 않으면 빈 전원 핀으로 나타납니다. abstract는 블록이 쓰는 모든 층을 막고, 전원 핀에는 메탈 4만 남깁니다. 원래 abstract에는 내부 전원 도형이 수천 개 나열되지만 이를 잇는 비아가 없어서, 한 단계 위에서 보면 떠 있는 것처럼 보이기 때문입니다.
결과는 850 × 850 µm 매크로로, 핀 930개, 전원은 메탈 4, 메탈 5에는 아무것도 없습니다. 뷰도 일치합니다. LEF, 넷리스트, 타이밍 모델 모두 신호 928비트입니다. 코어는 하드 IP로 LIM에 들어갑니다. 맞은 코너는 사인오프한 두 개이고, 나머지 두 개는 타이밍 모델이 없어 쓰지 않습니다.
3부: 제약 조건과 합성
#8실제 칩의 제약 조건
 2:14
YouTube에서 보기(영어) ↗Bilibili에서 보기(중국어) ↗
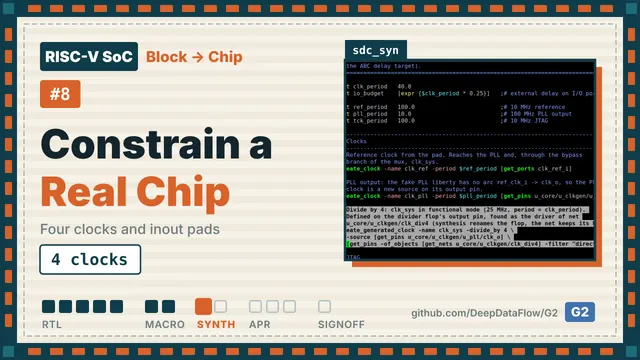
합성 제약 조건 sdc_syn v01은 숫자 하나로 정해집니다. 시스템 클록 40 ns입니다. 클록은 네 개입니다. 레퍼런스는 자기 핀에 있습니다. PLL 출력은 PLL 출력 핀에 정의한 새 클록이며, 가짜 PLL에 타이밍 아크가 없는 이유가 이것입니다. 시스템 클록은 여기서 4분주로 생성됩니다.
create_clock -name clk_ref -period $ref_period [get_ports clk_ref_i]
create_clock -name clk_pll -period $pll_period [get_pins u_core/u_clkgen/u_pll/clk_o]
create_generated_clock -name clk_sys -divide_by 4 \
  -source [get_pins u_core/u_clkgen/u_pll/clk_o] \
  [get_pins -of_objects [get_nets u_core/u_clkgen/clk_div4] -filter "direction == output"]
create_clock -name clk_tck -period $tck_period [get_ports tck_i]
합성은 플립플롭 이름을 바꾸므로 RTL에서 복사한 이름은 넷리스트에 없습니다. 넷은 이름을 유지하므로, 분주 클록 넷을 구동하는 핀을 찾습니다. JTAG은 별도의 클록이고, 먹스 제어 신호가 동기화기를 거치기 때문에 세 그룹은 서로 비동기입니다.
기능 모드에서는 PLL이 켜져 있고, 바이패스 핀에 대한 케이스 분석만으로는 부족합니다. 바이패스 쪽 클록 게이트의 인에이블이 상수가 아니라 플립플롭에서 오기 때문에, 레퍼런스 클록이 모든 시스템 플립플롭으로 새어 들어갑니다. 클록이 두 개인 핀이 4,599개였습니다. 바이패스 게이트의 클록 아크를 끄면 각 플립플롭의 클록은 하나가 됩니다.
set_case_analysis 0 [get_ports pll_bypass_i]
set_disable_timing -from CLK -to GCLK [get_cells u_core/u_clkgen/u_icg_ref/icg]
이제 모든 포트가 본딩 패드, 즉 inout이므로 타이밍 분석은 각 패드를 입력이자 출력으로 봅니다. 패드가 쓰지 않는 방향에는 지연 0을 주고 제외해서, 의도치 않게 제약 없는 경로가 남지 않게 합니다. 출력 패드는 5 pF의 보드 부하를 구동합니다.
#9칩 합성
 2:18
YouTube에서 보기(영어) ↗Bilibili에서 보기(중국어) ↗
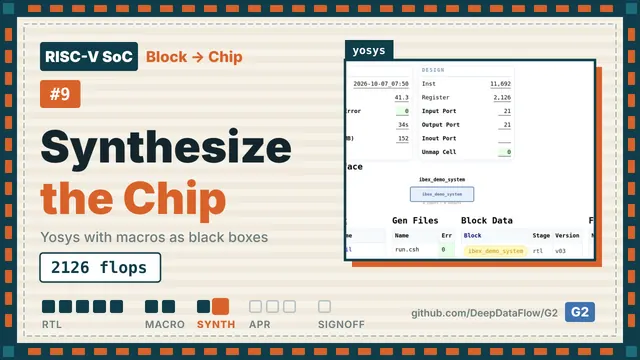
칩을 위한 새 구현 빌드를 만듭니다. rtl v03과 8편의 제약 조건입니다. G2는 spec에서 라이브러리를 모읍니다. 코너마다 9개로, 표준 셀, RAM, 코어의 타이밍 모델, PLL, 패드 셀 5개입니다. 이들은 spec의 라이브러리 파일, 즉 편집기가 쓰는 파일에서 옵니다. 지금까지 편집기를 쓴 이유가 이것입니다. 기본 Yosys 스크립트는 sky130에서 잘못된 이름으로 플립플롭을 세는데, 시리즈 1에서 이미 고쳤으므로 타이밍 드리븐 스크립트를 포함해 그 스크립트를 다시 씁니다.
실행은 약 40초입니다. 오류 없음, 매핑되지 않은 셀 없음, 인스턴스 11,692개, 플립플롭 2,126개이며, 모든 매크로와 패드가 블랙박스로 넷리스트에 들어 있습니다. 다음으로 제약 조건과 넷리스트를 맞춰 봅니다. 제약 없는 엔드포인트가 22개 있지만 모두 예상한 것으로, 입력 패드의 쓰지 않는 쪽과 전원 패드입니다. 각 클록은 도달해야 할 플립플롭에 도달합니다.
배치 전 타이밍은 정직하게 읽어야 합니다. 시스템 클록의 셋업은 −10.4 ns, 리셋 리커버리는 −21.4 ns입니다. 리셋 동기화기가 버퍼 없이 플립플롭 1,316개를 구동해서 슬루가 40.9 ns이기 때문입니다. 합성은 이 넷에 버퍼를 넣지 않지만 배치에서는 넣습니다. 이 넷 하나를 빼면 모든 클록이 타이밍을 만족합니다.
4부: 칩 배치 배선
#10패드 링과 칩 전원
 2:35
YouTube에서 보기(영어) ↗Bilibili에서 보기(중국어) ↗
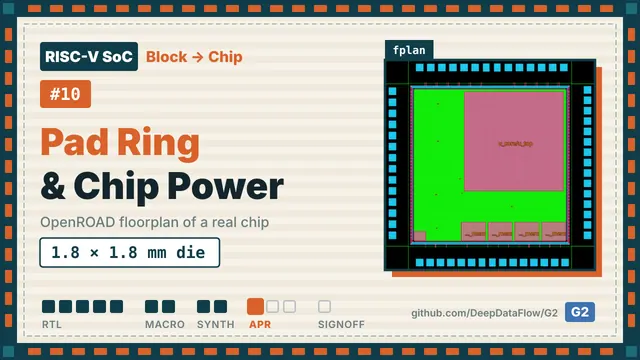
배치 배선 제약 조건은 합성 제약과 같고, 바뀐 곳은 하나입니다. 보드 신호가 표준 셀 대신 트랜지션으로 입력 패드를 구동합니다. 패드를 구동할 수 있는 표준 셀은 없기 때문입니다. 다이는 1.8 mm 정사각형, 코어는 1.3 mm입니다. 패드 58개에는 한 변에 1.6 mm 이상이 필요하므로, 크기를 정하는 것은 로직이 아니라 패드입니다.
패드 링 스크립트는 다이 둘레에 IO 사이트를 두고, 각 변의 패드를 순서대로 같은 간격으로 놓은 다음, 코너, 필러 슬라이스, 어버트먼트, 그리고 포트마다 본딩 패드 단자를 만듭니다. 중요한 순서가 하나 있습니다. 어버트먼트 전에 패드 전원의 이름을 정해야 합니다. 그러지 않으면 어버트먼트가 자체 링 넷을 만들어, 전원 패드가 코어 전원에 연결되지 않고 이후 어떤 단계에서도 고쳐지지 않습니다.
# 먼저 패드 전원을 연결(add_global_connection ...)한 다음:
global_connect
connect_by_abutment
place_io_terminals {*/PAD */VCCD_PAD */VSSD_PAD */VDDIO_PAD */VSSIO_PAD}
전원 그리드에는 패드 전원, 전원 패드에 연결되는 코어 링, 링까지 뻗는 스트라이프를 더합니다. -extend_to_core_ring이 없으면 스트라이프가 링 앞에서 멈춰 코어 그리드 전체가 떠 버립니다. 두 문제 모두 연습하면서 힘들게 찾았습니다.
add_pdn_stripe -grid {grid} -layer {met5} -width {1.600} -pitch {27.200} -offset {13.600} -extend_to_core_ring
add_pdn_ring -grid {grid} -layers {met4 met5} -widths {10.0 10.0} -spacings {2.0 2.0} \
  -core_offsets {10.0 10.0} -connect_to_pads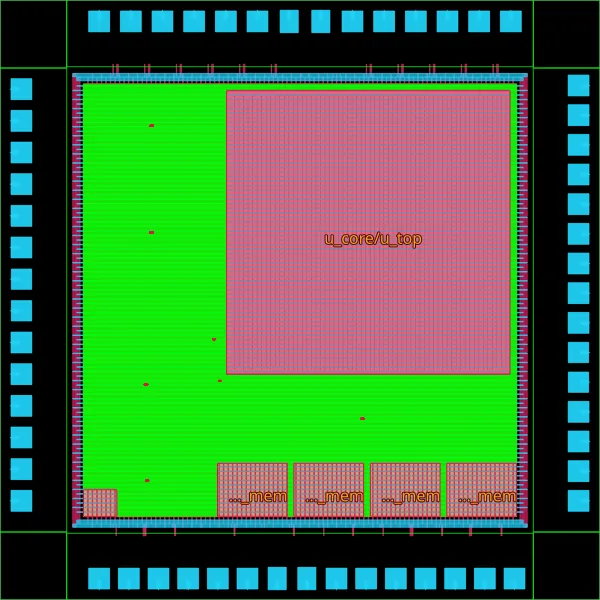
이것이 6편의 성과입니다. 메탈 5 전원 스트랩 32개가 코어 위를 지나고, 비아 900개가 메탈 4 전원 핀으로 내려갑니다.
#11배치, CTS, 포스트 CTS
 2:05
YouTube에서 보기(영어) ↗Bilibili에서 보기(중국어) ↗
배치 후 전원 검사가 통과합니다. 전원 위의 모든 도형이 연결되어 있습니다. 연습 때는 그리드가 링에 닿고 코어가 메탈 5를 비워 둘 때까지 이 검사가 계속 실패했습니다. 그 수정을 먼저 한 이유입니다.
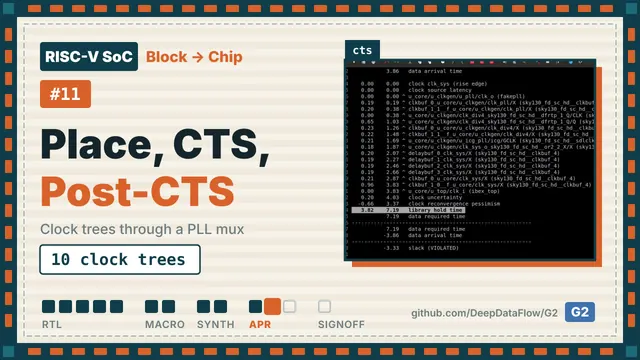
클록 트리 합성으로 클록 트리 10개가 만들어집니다. 시스템 클록은 글리치 없는 먹스에서 나와 매크로 클록 핀 9개와 플립플롭 1,892개에 도달합니다. JTAG은 자체 트리가 있습니다.
이제 계층 설계 부분입니다. 코어의 타이밍 모델에 따르면 코어 자체의 클록 트리가 매크로 안에서 5 ns 이상을 더합니다. 핀까지 3.8 ns, 내부에서 5.6 ns입니다. 코어의 플립플롭은 RAM보다 훨씬 늦게 클록을 받고, 이것이 코어 입력에서 −3.3 ns 홀드 위반으로 나타납니다. 포스트 CTS 수정이 홀드 버퍼 317개를 넣어 코어를 포함한 모든 홀드 위반을 해결합니다.
셋업 위반 하나가 클록 분주기에 남습니다. 분주기 자체의 출력이 이제 클록 트리 넷이 되었고, 그 트리를 거쳐 100 MHz로 자기 카운터에 피드백되기 때문입니다. 실제 설계라면 별도의 플립플롭에서 피드백합니다. 기록해 두고 넘어갑니다.
#12배선과 마무리
 0:55
YouTube에서 보기(영어) ↗Bilibili에서 보기(중국어) ↗
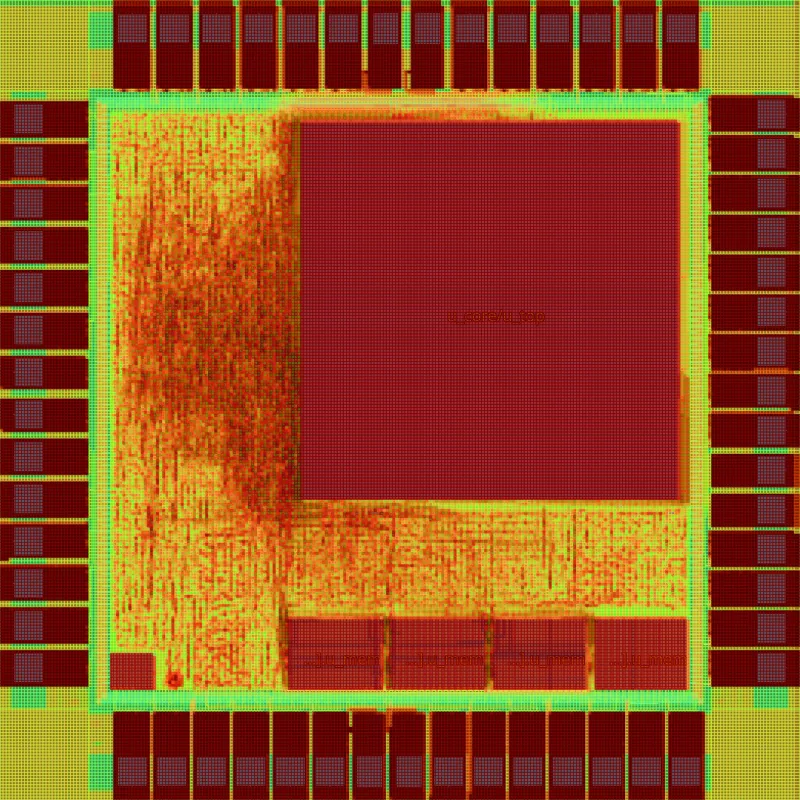
칩 전체 배선은 약 10분이 걸리고 위반은 1개, 배선 길이 1.07 m, 비아 106,115개입니다. 코어 단독일 때는 120개였습니다. 칩의 코어 영역에 여유가 있고, 매크로 위의 메탈 5가 칩에 열려 있기 때문입니다. 포스트 라우트 정리와 피니시(필러 삽입, 최종 넷리스트와 레이아웃 출력) 후에는 위반 2개, 쇼트 없음입니다. 피니시에서 출력되는 타이밍은 아직 이상적인 클록 기준이며, 실제 수치는 사인오프에서 나옵니다.
5부: 사인오프
#13칩 사인오프
 2:56
YouTube에서 보기(영어) ↗Bilibili에서 보기(중국어) ↗
사인오프는 실제 배선에서 시작합니다. OpenRCX가 4개 코너를 18초에 추출합니다. 사인오프 제약 조건은 실제 클록 트리가 반영되도록 전파 클록을 쓰고, 스큐를 추정할 필요가 없어졌으니 불확실성을 줄입니다.
실제 패드가 있는 칩에만 필요한 섹션이 하나 있습니다. 패드의 타이밍은 구동 모드에 따라 달라집니다. RTL에서 그 핀들을 고정했지만 드라이버가 없는 넷을 거치기 때문에, 타이밍 분석은 값을 볼 수 없어 가장 느린 모드를 가정합니다. 패드 모드가 없으면 출력 패드가 120 ns 걸리고 칩은 102 ns 부족합니다. 지정하면 6.9 ns로, 12.2 ns의 여유가 생깁니다.
이어서 OpenSTA로 칩 전체를 분석합니다. 코어는 타이밍 모델로, 각 패드와 RAM, PLL은 LIM에서 가져옵니다. 병합한 결과는 다음과 같습니다.
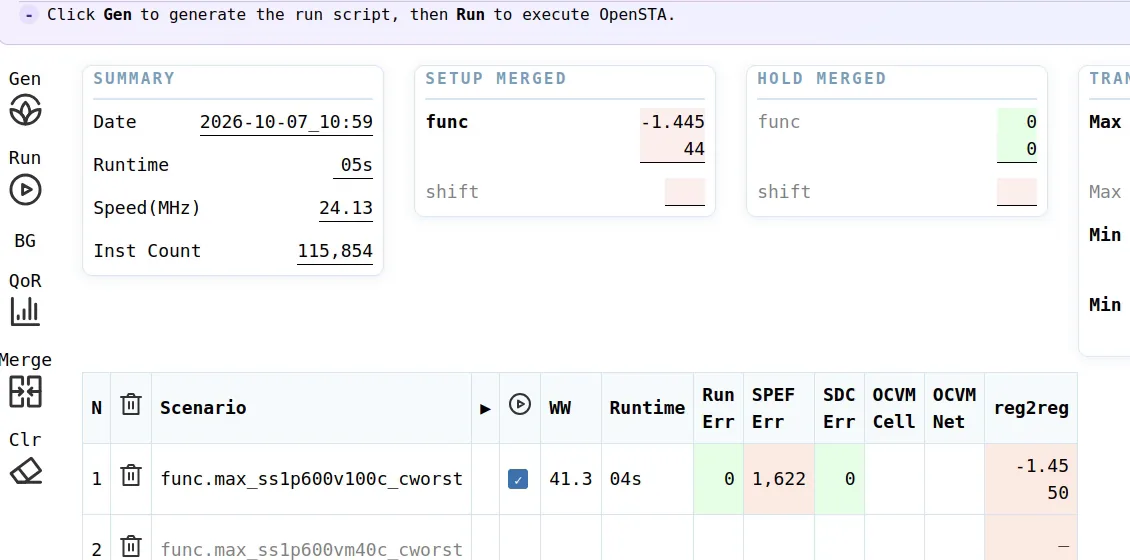
최악 경로가 이 시리즈의 교훈입니다. 클록은 7.8 ns에 코어에 도달합니다. 코어의 타이밍 모델에 따르면 데이터 주소는 그로부터 27.9 ns 뒤에 나옵니다. 코어 자체의 클록 트리와 로직 때문입니다. SoC에는 버스와 디버그 메모리를 위해 약 12 ns가 남는데, 필요한 것은 13.5 ns입니다. 블록으로 칩을 만들 때, 각 블록의 출력 타이밍은 칩이 감당해야 할 예산입니다. 칩은 25 MHz가 아니라 약 24.1 MHz로 동작합니다.
만든 것, 남은 것
시리즈 1의 코어에서 칩까지. 듀얼 포트 RAM, 안전한 바이패스가 있는 PLL, 실제 패드 58개, 칩을 위한 공간을 남기는 하드 매크로 코어, 합성, 배치 배선, 사인오프. 모두 G2에서 실행했고, 모든 인계는 설계 데이터 관리자와 라이브러리 관리자를 거쳤습니다.
남은 과제와 시작점:
- 코어 경계에서 셋업 −1.45 ns. 코어의 클록-출력 예산입니다. 다음 단계는 더 빠른 코어나, 버스 경계에 레지스터를 넣는 것입니다.
- 출력 패드 슬루. 패드의 트랜지션 테이블이 모드별로 나뉘어 있지 않아 생기는 라이브러리 모델링의 한계입니다.
- PLL 쪽의 너무 작은 클록 게이트(최대 커패시턴스).
- 100 MHz 도메인의 분주기 피드백.
- DRC 위반 2개. 그리고 이 시리즈에서는 DRC, LVS, GDS 사인오프를 하지 않았습니다.
시청하고 직접 해 보기
- 동영상: YouTube 재생목록(영어)과 Bilibili 컬렉션(중국어).
- 이 시리즈가 출발하는 코어: RISC-V RTL-to-Signoff.
- 다음 시리즈: RISC-V Flip-Chip: Pads to Bumps에서는 패드 링을 없애고, 이 와이어 본딩 칩과 플립칩 버전을 비교합니다.
- 프로젝트: G2_demo_sky130. G2는 무료 Community Edition으로 사용할 수 있습니다.
- G2나 직접 흐름을 실행하는 것에 관한 질문: support@deepdataflow.com. 라이선스와 협업: sales@deepdataflow.com.