
같은 RTL, 같은 제약 조건, 두 개의 합성 스크립트. 하나는 타이밍을 16 ns 놓치고, 다른 하나는 만족합니다. 이 시리즈는 여기서 시작합니다. 실제 RISC-V 코어, 즉 명령어 캐시를 켠 lowRISC의 Ibex를 SkyWater 130 nm에서 RTL부터 사인오프까지 진행합니다. 사용하는 것은 G2 안의 오픈소스 도구뿐입니다. 합성은 Yosys, 배치 배선은 OpenROAD, 추출은 OpenRCX, 사인오프는 OpenSTA입니다.
이 글은 동영상 12편의 글 버전입니다. 각 섹션에는 해당 에피소드 동영상, 그 뒤에 있는 결정, 그리고 실제로 나온 수치를 담았습니다. 모든 것은 GitHub의 G2_demo_sky130 프로젝트에 있습니다. 작업 공간에 클론하고 make setup을 실행하면 프로젝트가 나타납니다.
| 설계 | ibex_top: 명령어 캐시를 켠 lowRISC Ibex, 따라서 SRAM 매크로 4개 |
| 공정 | SkyWater 130 nm (sky130 HD 표준 셀) |
| 도구 | Yosys, OpenROAD, OpenRCX, OpenSTA. 모두 G2에서 실행 |
| 블록 | 850 × 850 µm, 플립플롭 약 2,400개, 필러 삽입 후 인스턴스 98,222개(필러 70,818개) |
| 결과 | 홀드 충족(+0.17 ns). 셋업은 레지스터-출력만 미달로, 주소 8비트에서 −1.74 ns. DRC 107개 |
1부: 합성
#1Yosys 합성: RTL에서 첫 넷리스트까지
 4:01
YouTube에서 보기(영어) ↗Bilibili에서 보기(중국어) ↗
블록은 ibex_top, lowRISC의 Ibex RISC-V 코어입니다. 이 블록의 spec은 sky130 표준 셀과 두 종류의 메모리 매크로를 연결합니다. 명령어 캐시를 켜면 Ibex에는 웨이가 두 개 있고, 각각 태그 RAM과 데이터 RAM이 있습니다. 모두 SRAM 매크로 4개로, 표준 셀만 있는 설계보다 훨씬 실제 칩에 가깝습니다. 메모리는 다른 라이브러리처럼 G2의 라이브러리 관리자(LIM)에 있고, 각각 LEF와 타이밍 코너 4개를 가집니다. 프로젝트에 함께 들어 있으므로 기본 G2 패키지로 동작합니다.
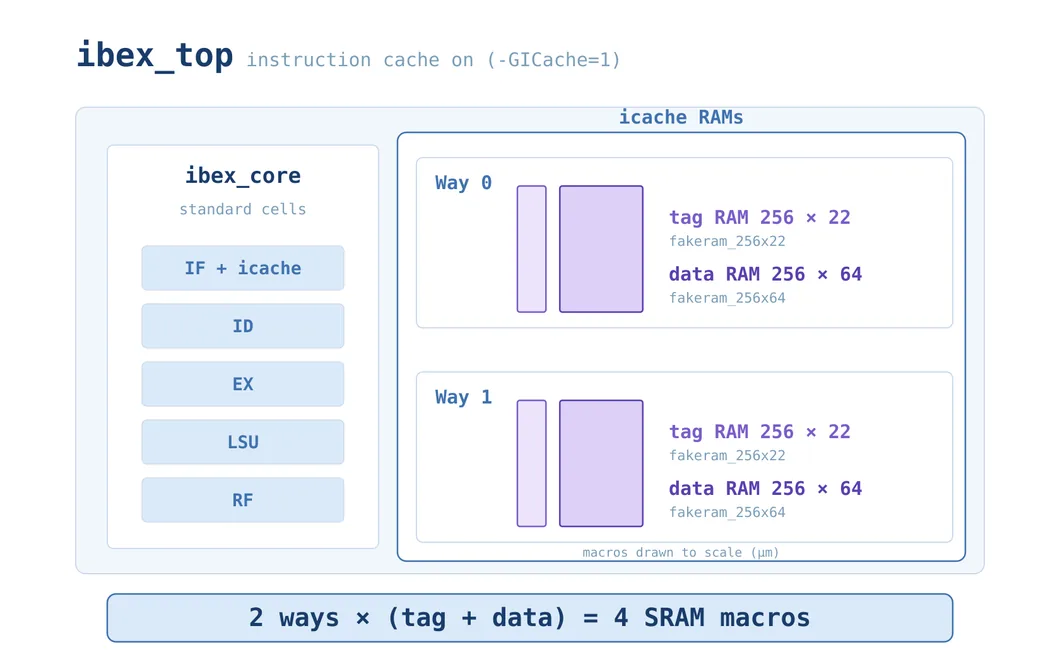
ibex_top: 웨이 2개 × (태그 + 데이터) = SRAM 매크로 4개.RTL은 DDM의 rtl v01입니다. 파일 목록의 첫 줄 -GICache=1이 구성을 정하고, 벤더 RTL 자체는 수정하지 않았습니다. 나머지는 작은 sky130 기술 레이어가 맡습니다. Ibex는 범용 싱글 포트 RAM을 요구하고, sky130 버전이 각 RAM 형태를 실제 매크로에 매핑합니다. 클록 게이팅에는 합성이 매핑할 수 없는 래치 대신 라이브러리의 실제 통합 클록 게이팅 셀을 씁니다. sky130 전용 파일은 모두 한 폴더에 있고, 나머지는 업스트림과 바이트 단위로 같습니다.
v01은 기본 스크립트를 씁니다. 범용 합성 후 면적 기준으로 라이브러리에 매핑할 뿐, 타이밍 정보는 전혀 없습니다. 실행은 약 20초. 매핑되지 않은 셀은 없고, 레지스터 약 2,400개, 매크로 4개입니다. 넷리스트는 syn v01로 DDM에 체크인되어, 이후 어떤 단계에서도 버전으로 가져올 수 있습니다.
타이밍을 보기 전에 G2의 netins 도구로 넷리스트 내용을 확인하면 매크로가 1,800개라고 보고합니다. 분류기가 sky130 셀 이름을 알아보지 못해서 플립플롭, 4입력 게이트 몇 개, 메모리, 클록 게이트가 모두 "매크로"로 분류되었습니다. G2 새 릴리스를 기다릴 필요는 없습니다. 규칙은 일반 텍스트 파일 mapping.cfg에 있으며, 패턴, 콜론, 카테고리 형식이고 처음 일치한 규칙이 적용됩니다.
__a4 : Compound
__o4 : Compound
__df : Seq-FF
__sdlclkp : ICG
^fakeram : Memory
다시 실행하면 넷리스트가 예상대로 나옵니다. 플립플롭 2,395개, 메모리 4개, 클록 게이트 1개입니다. netins는 찾은 포트로 초기 SDC도 작성합니다. 클록 하나와 모든 포트의 기본 지연입니다. 이것은 뼈대일 뿐 실제 제약 조건이 아닙니다.
#2타이밍 드리븐 합성, 그리고 데이터로 고르기
 3:57
YouTube에서 보기(영어) ↗Bilibili에서 보기(중국어) ↗
뼈대를 실제 제약 조건으로 바꿉니다. 클록은 저속 코너에서 40 ns입니다. 입력과 출력에는 주기의 4분의 1을 외부 예산으로 주고, 드라이빙 셀과 부하로 경계를 현실적으로 만들고, 테스트 모드는 끄고, 정적 설정 핀과 리셋은 타이밍 분석에서 뺍니다. 제약 조건은 sdc_syn v01로 DDM에 넣습니다. sdc_signoff_func v01도 당분간 같은 제약을 쓰고, 레이아웃 후에 버전 2가 됩니다.
여기서 문제가 생깁니다. Yosys는 SDC를 목표로 최적화하지 못합니다. 최신 버전은 SDC를 파싱할 수 있지만, 참조된 객체를 유지하기 위해서일 뿐입니다. Yosys에 있는 것은 ABC의 지연 목표 -D와, 드라이빙 셀과 부하만 담은 제약 파일입니다. 그리고 함정은 여기에 있습니다. -D만 썼더니 넷리스트가 바이트 단위로 똑같았습니다. ABC는 -constr도 함께 줘야 버퍼를 넣고 게이트 크기를 바꿉니다.
그래서 고급 스크립트는 수치를 SDC에서 바로 읽습니다. 주기에서 IO 예산과 불확실성을 뺀 29 ns가 ABC의 목표입니다. 드라이버와 부하도 같은 파일에서 가져오므로 정보원은 하나입니다. Booth 곱셈기도 켭니다. 로그에서 ABC가 29,000 ps와 buf_2 드라이버를 받았음을 확인할 수 있습니다.
이어서 OpenSTA로 두 넷리스트를 평가합니다. 시나리오도 SDC도 같고, 다른 것은 넷리스트뿐입니다.
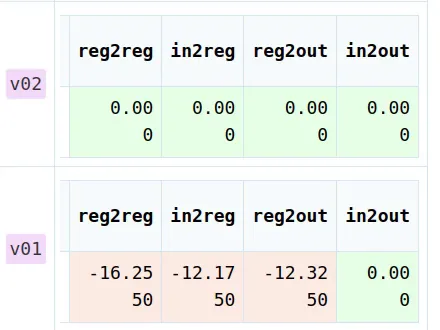
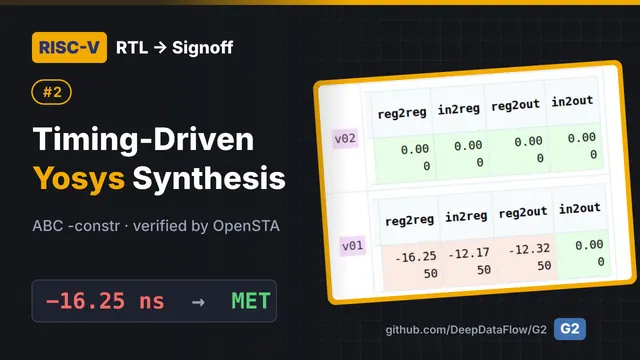
v01은 입력-출력을 제외하고 모두 실패, 타이밍 드리븐 v02는 모두 충족.| v01 기본 | v02 타이밍 드리븐 | |
|---|---|---|
| reg2reg | −16.25 ns | 충족(+6.65) |
| in2reg | −12.17 ns | 충족(+13.13) |
| reg2out | −12.32 ns | 충족(+6.67) |
| 버퍼 | 0 | 1,494 |
| 표준 셀 | 16,634 | 17,432(+4.8%) |
기본 버전은 왜 실패할까요? 최악 경로에서 플립플롭 하나가 최소 크기 출력으로 핀 259개를 구동해, 한 단계에서만 약 12 ns가 걸립니다. 바로 버퍼링이 해결하는 문제입니다. 셀 5%를 더 써서 슬랙 23 ns를 얻습니다. v02가 OpenROAD로 갑니다. 이 수치는 배치 전, 이상적인 클록에 배선 없는 결과이며, v02에는 아직 슬루 위반이 있지만 배치 배선에서 고쳐집니다.
2부: OpenROAD, 한 편에 한 단계
#3넷리스트를 OpenROAD로
 3:55
YouTube에서 보기(영어) ↗Bilibili에서 보기(중국어) ↗
배치 배선에는 자체 제약 조건이 필요합니다. 첫 번째 패스의 sdc_apr_func v01은 합성 제약과 같은 40 ns, 불확실성이 있는 이상적인 클록이고, 이후 단계에서 실제 클록 트리로 바꿉니다. G2에서 OpenROAD를 체크아웃하면 init부터 finish까지 8단계가 생기고, 각 단계의 DDM 뷰에 입력이 표시됩니다.
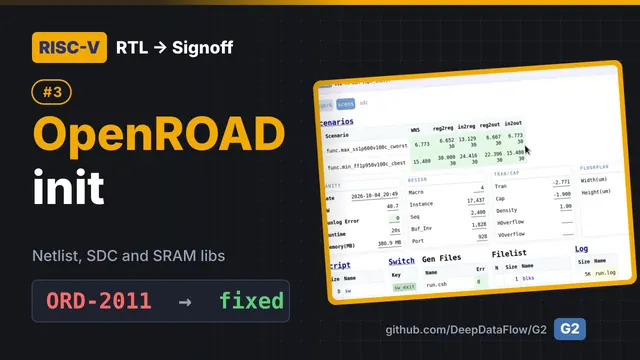
init 스크립트는 SRAM 2개를 포함한 기술 LEF와 셀 LEF를 읽고, MMMC 파일에서 코너별 타이밍 라이브러리를 불러오고, 넷리스트를 읽어 링크하고, SDC를 읽습니다. 한 곳을 바꿉니다. 넷리스트는 계층 구조이지만 OpenROAD의 계층 링크 모드는 아직 개발 중으로 표시되므로, 평탄하게 링크합니다.
link_design $blkname ;# 변경 전: link_design -hier $blkname실행은 20초이고 오류는 없지만 경고를 읽어야 합니다. ORD-2011: SRAM 2개에 LEF는 있지만 liberty가 없습니다. OpenROAD는 배치는 할 수 있어도 타이밍 분석은 못 합니다. 이 릴리스의 생성기는 표준 셀 라이브러리만 나열하므로(다음 버전에서 수정됨), 메모리 라이브러리를 저속·고속 코너용으로 직접 추가합니다. 파일을 덮어쓰므로 Gen은 다시 누르지 마세요. 이후 모든 단계가 이 파일을 읽으므로 한 번 고치면 흐름 전체에 적용됩니다.
수정 후 저속 코너의 경로 그룹별 최악 슬랙은 2편의 OpenSTA와 정확히 일치합니다. reg2reg +6.652 ns. 넷리스트, SDC, 라이브러리가 모두 같기 때문입니다. 매크로 4개, 인스턴스 17,400개, 그리고 합성이 넣은 버퍼와 인버터 1,800개. 트랜지션과 커패시턴스에는 아직 위반이 있지만 배치에서 고쳐집니다.
#4플로어플랜: 다이, SRAM 매크로, 전원 그리드
 2:23
YouTube에서 보기(영어) ↗Bilibili에서 보기(중국어) ↗
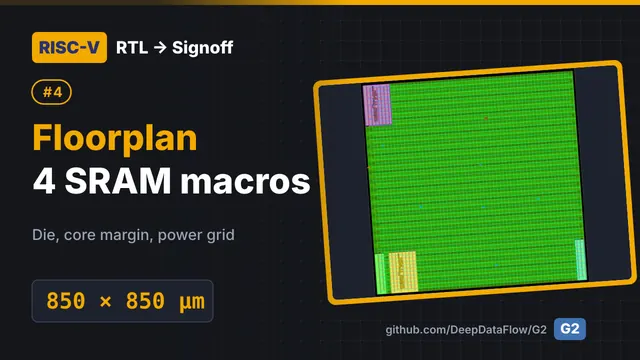
플로어플랜 스크립트는 다이와 코어를 만들고, 배선 트랙을 깔고, 합성이 넣은 버퍼를 제거하고(OpenROAD가 실제 배치에 맞춰 다시 넣습니다), SRAM 4개를 20 µm 헤일로로 배치하고, 탭 셀을 넣고, 전원 그리드를 만듭니다.
다이와 코어가 같은 850 µm로 여백이 없었습니다. 그러면 SRAM이 IO 핀이 놓이는 다이 가장자리에 딱 붙게 됩니다. 매크로 위에 핀이 있으면 배선에서 쇼트가 나고, 전원 링도 다이 밖으로 나갑니다. 그래서 10 µm를 비워 코어를 830 µm로 했습니다.
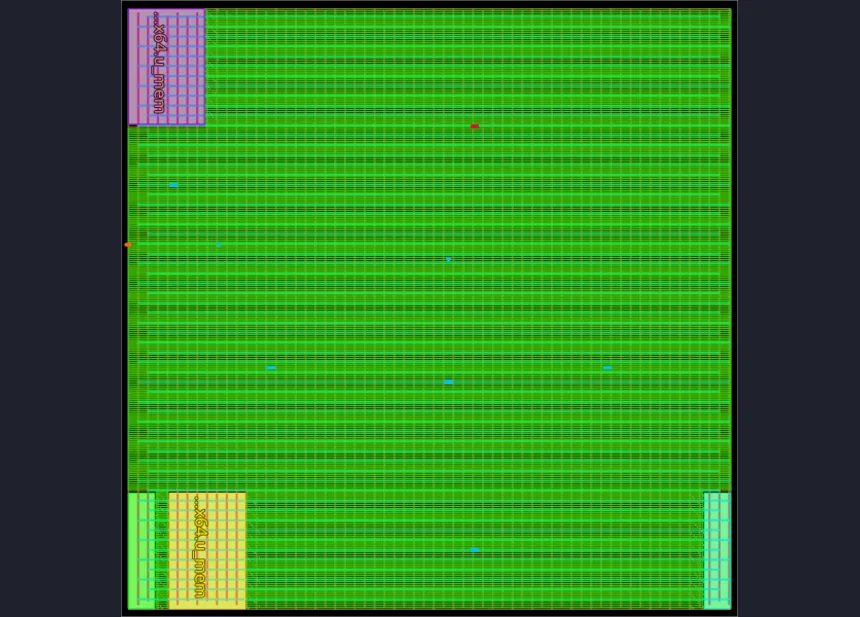
타이밍은 의도적으로 빨개집니다. 합성 버퍼 1,494개를 제거해서 reg2reg가 −14.7 ns가 되었습니다. 긴 배선이 큰 부하를 작은 셀로 구동하기 때문입니다. 이 단계에서 탭 셀 8,568개가 추가되고, 버퍼와 인버터는 1,800개에서 334개로 줄었으며, 사용률은 850 µm 다이의 31%입니다.
#5배치와 설계 수정
 2:33
YouTube에서 보기(영어) ↗Bilibili에서 보기(중국어) ↗
배치는 먼저 핀을 무시한 대략적인 글로벌 배치를 하고, 핀을 연결된 로직 옆에 놓고, 배선 혼잡을 고려해 다시 배치합니다. 그다음 배선을 추정하고 repair_design을 실행해 버퍼 삽입과 크기 조정으로 모든 슬루, 커패시턴스, 팬아웃 위반을 고치고, 마지막으로 모든 셀을 행에 맞춰 정렬합니다. 약 1분입니다.
repair_design은 슬루 위반 710개와 커패시턴스 위반 235개를 찾아 버퍼 1,258개를 넣고 셀 673개의 크기를 바꿨습니다. 실제 배치 배선으로 타이밍이 돌아옵니다. reg2reg는 +1.820 ns, reg2out은 0.63 ns 부족하지만 포스트 CTS에서 고쳐집니다. 트랜지션과 커패시턴스 위반은 사라졌고, 사용률은 34%입니다.
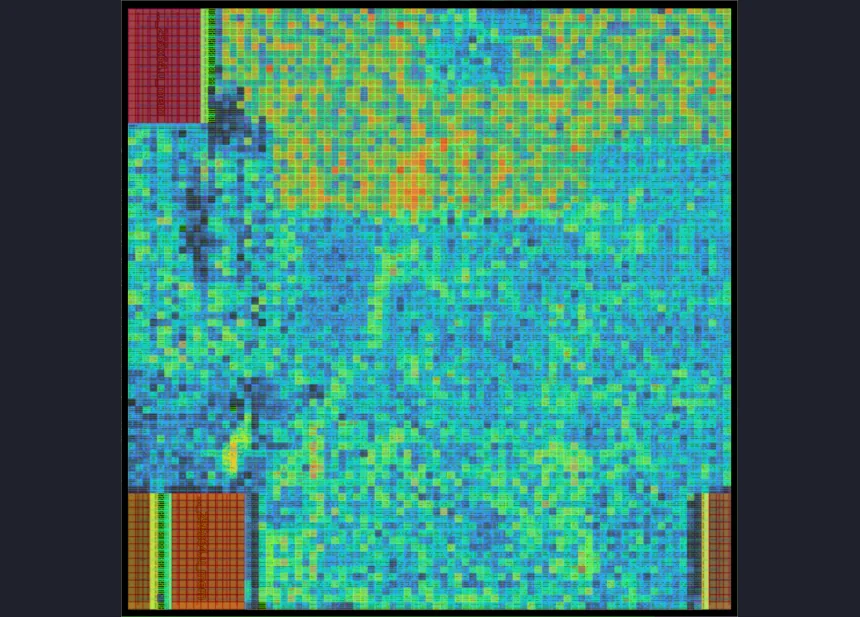
혼잡도 추정은 레지스터 파일 위와 왼쪽 SRAM 옆의 좁은 채널에서 가장 높습니다. 이 채널은 배선에서 다시 나옵니다.
#6클록 트리 합성: 오류 0개, 트리 없음
 2:34
YouTube에서 보기(영어) ↗Bilibili에서 보기(중국어) ↗
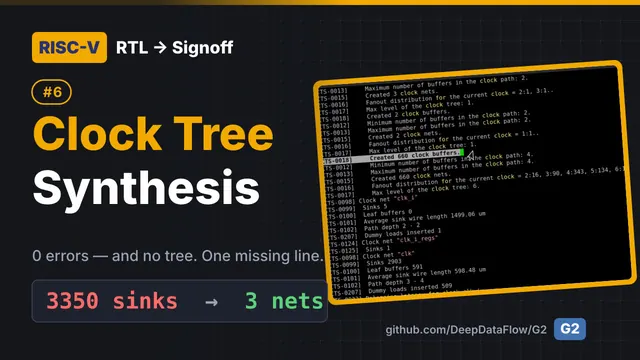
CTS는 클록 인버터를 부하 옆에 복제하고, 버퍼 한 종류 clkbuf_4로 트리를 만들고, 클록 핀에서 루트까지의 긴 배선을 고치고, 새 버퍼를 정렬합니다. 첫 실행은 오류 없음을 보고합니다. 하지만 로그에는 클록 배선의 저항과 커패시턴스가 0이라는 경고가 있습니다. 그 뒤 CTS는 클록에 매크로 싱크가 3,350개 있다고 판단하고, 복제된 넷 수백 개를 건너뜁니다. 클록 게이트 뒤에는 트리가 만들어지지 않습니다.
배치에서 와이어 RC를 설정했지만 그 설정은 데이터베이스에 저장되지 않고, CTS 스크립트는 다시 설정하지 않습니다. 배치와 같은 세 줄로 고칩니다.
source $fvar(layer_rc)
set_wire_rc -signal -layer $wire_rc_layer
set_wire_rc -clock -layer $wire_rc_layer_clk
이제 CTS는 클록 넷 세 개를 찾습니다. SRAM 4개와 클록 게이트를 구동하는 클록 핀, 게이팅되지 않은 플립플롭 하나, 그리고 거의 모든 레지스터를 구동하는 코어 클록 게이트 뒤의 게이티드 클록으로, 여기에 버퍼 660개가 들어갑니다. 수정 전에는 이 도메인에 트리가 전혀 없어서 플립플롭 2,400개가 버퍼 없는 넷 하나에 매달려 있었고, 그래도 이 단계는 오류 0개를 보고했습니다. 오류 수가 아니라 로그를 읽으세요.
#7포스트 CTS 타이밍 수정
 2:18
YouTube에서 보기(영어) ↗Bilibili에서 보기(중국어) ↗
CTS 이후 타이밍이 진짜가 됩니다. 클록을 이상적인 클록에서 전파 클록으로 바꾸면, 모든 플립플롭이 트리를 거친 실제 도착 시간을 봅니다. 이어서 repair_timing이 크기 조정과 버퍼 삽입으로 셋업과 홀드를 고치고, 전원 그리드의 정적 IR 드롭을 검사합니다.
실제 클록에서는 엔드포인트 17개가 셋업을 놓칩니다. 클록 트리가 약 4 ns의 지연을 더해 출력 예산을 잡아먹기 때문입니다. repair_timing이 버퍼 8개로 모두 고쳐 −5.2 ns에서 +0.109 ns가 되고, 홀드도 충족합니다. 넷 하나가 슬루 제한을 160 ps 넘습니다. 실제 테이프아웃이라면 CTS 후에 repair_design을 한 번 더 실행합니다. 정적 IR 드롭은 최대 147 µV로 1.6 V의 약 0.01%이며, 이 설계에는 충분히 튼튼한 전원 그리드입니다.
#8글로벌 배선과 상세 배선
 2:01
YouTube에서 보기(영어) ↗Bilibili에서 보기(중국어) ↗
배선은 상수 타이 넷을 특수 넷으로 표시해 라우터가 건너뛰게 하고, 모든 셀 핀에 대한 올바른 접근 방법을 찾고, 거친 그리드에서 각 넷의 경로를 계획하며 혼잡 해소를 위해 최대 100번의 추가 패스를 돌리고, 안테나를 수정한 뒤, 10패스의 상세 배선으로 실제 메탈을 그립니다. 백그라운드에서 약 16분 걸립니다(실행 시간 카드는 1시간 30분으로 표시하지만 스레드 8개의 합계입니다).
글로벌 배선은 오버플로 0으로 끝나고, 안테나 수정으로 위반 291개가 0이 되며, 상세 배선으로 위반이 8,985개에서 127개로 줄어듭니다.
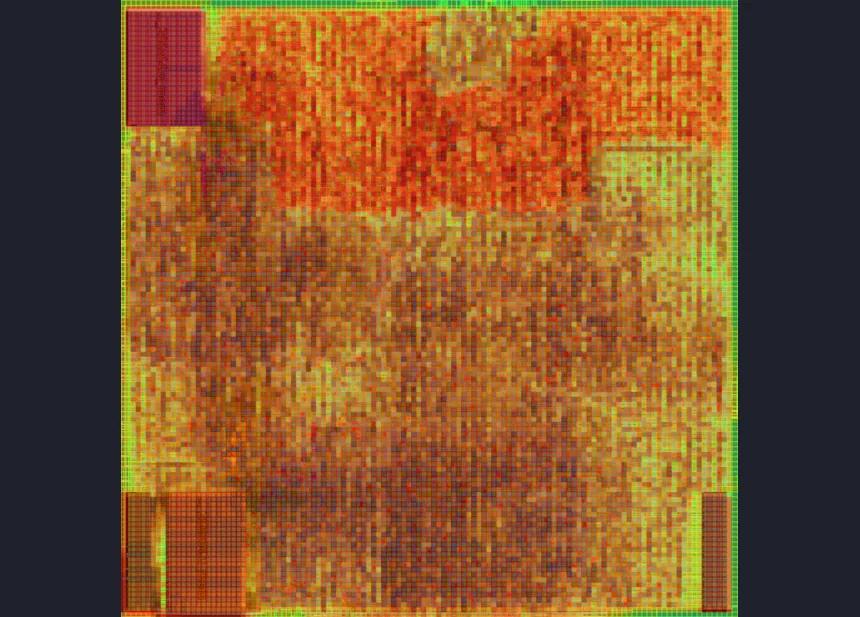
이 단계의 타이밍 표는 건너뛰세요. route 리포트는 이상적인 클록으로 돌아가 있어 실제 수치가 아닙니다. 실제 수치는 사인오프에서 나옵니다.
#9포스트 라우트 정리와 DRC
 1:51
YouTube에서 보기(영어) ↗Bilibili에서 보기(중국어) ↗
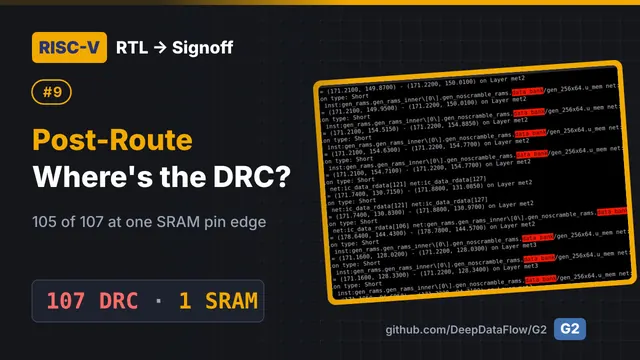
포스트 라우트는 안테나를 수정하고, 핀 접근을 다시 계산하고, 상세 배선 5패스와 안테나 수정 루프를 더 돌린 뒤, 독립적인 DRC 검사로 마무리합니다. 약 6분 걸리며 위반 107개, 그중 쇼트 62개가 남습니다. 라우터 자체의 수치는 오르내리고 중복도 포함합니다. DRC 카드의 수치는 마지막 독립 검사에서 나온 것입니다.
거의 전부, 107개 중 105개가 명령어 캐시의 데이터 뱅크인 SRAM 하나와, 바로 옆 메탈 2·3의 넷에 있습니다. 이 SRAM은 신호 핀 140개가 모두 메탈 3의 한 변에 몰려 있고, 표준 셀이 그 변에 바짝 붙어 있어서 라우터가 핀에 들어갈 공간이 없습니다. 패스를 늘려도 해결되지 않습니다. 고칠 곳은 플로어플랜입니다.
#10피니시: 칩 전체와 남은 과제
 2:48
YouTube에서 보기(영어) ↗Bilibili에서 보기(중국어) ↗
피니시는 행의 빈 공간을 필러 셀로 채우고, 배치와 DRC를 한 번 더 확인하고, IR 분석을 하고, DEF, 넷리스트, 데이터베이스를 출력합니다. 추출 줄은 주석 처리되어 있어 여기서는 SPEF를 만들지 않고, OpenRCX가 만듭니다. 결과는 인스턴스 98,222개(필러 70,818개), DRC는 포스트 라우트와 같은 107개(피니시는 다시 배선하지 않습니다), IR 드롭은 최대 약 0.11 mV입니다.
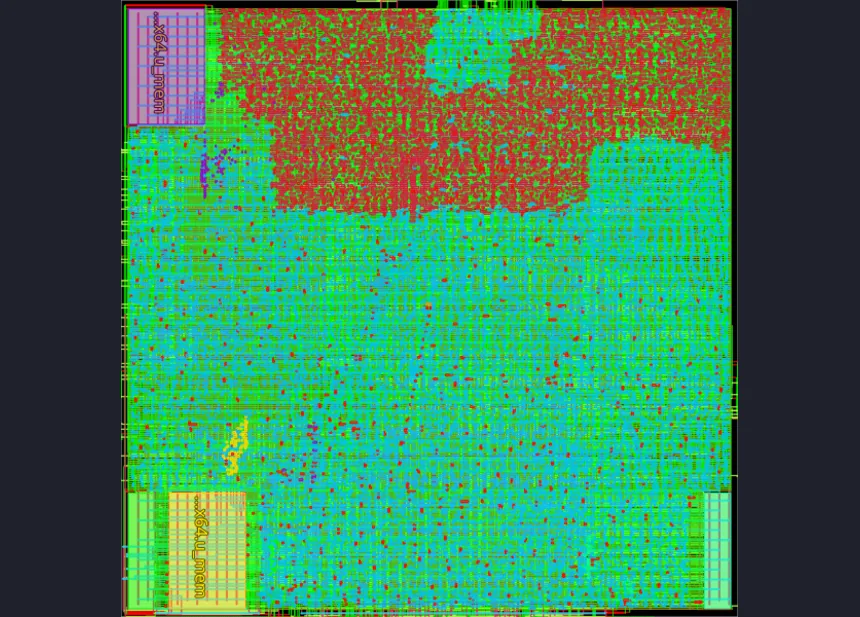
init부터 finish까지 모든 단계가 G2의 한 페이지에 있고, 각각 로그, 리포트, 카드, 그림이 있으며, 모두 DDM에 체크인되어 있습니다. 스크립트 하나를 바꾸면 그 단계부터 다시 실행해 이번 결과와 비교할 수 있습니다.
3부: 사인오프
#11OpenRCX로 기생 성분 추출
 2:16
YouTube에서 보기(영어) ↗Bilibili에서 보기(중국어) ↗
사인오프 타이밍에는 실제 배선, 즉 배선된 모든 넷의 저항과 커패시턴스가 필요합니다. G2의 흐름 페이지에서 OpenRCX는 OpenROAD 바로 옆에 있습니다. 스크립트는 완성된 데이터베이스(apr_finish v02)를 읽고, 프로젝트가 요구하는 각 코너(저온에서 고온까지 4개)에 대해 PDK spec에 있는 해당 코너의 규칙 파일로 추출해 SPEF를 하나씩 씁니다.
실행은 14초, 오류 없음. 넷 18,670개, 저항 111,215개, 결합 커패시터 206,593개입니다. SPEF 파일 4개의 크기가 같은데, 이것은 정직한 결과입니다. sky130의 공개 규칙 파일에는 RC 모델이 하나뿐이라 모든 코너가 같은 수치를 받습니다. 양산용 PDK는 코너별 규칙 파일을 제공하고, 흐름은 이미 코너마다 SPEF를 만들므로 바꿀 것은 그것뿐입니다. SPEF는 레이아웃과 같은 DDM 버전에 체크인되어, 이제 apr_finish v02는 넷리스트, DEF, 기생 성분을 함께 갖습니다.
#12OpenSTA로 포스트 라우트 사인오프
 5:14
YouTube에서 보기(영어) ↗Bilibili에서 보기(중국어) ↗
2편에서는 이상적인 클록, 배선 없는 OpenSTA로 넷리스트를 평가했습니다. 이제 같은 OpenSTA가 실제 레이아웃을 받습니다. 사인오프 SDC는 버전 2가 되며 세 가지가 바뀝니다. OpenSTA가 실제 클록 트리를 따라가도록 전파 클록을 쓰고, 스큐를 이제 측정하므로 불확실성을 줄이고(셋업 1 ns → 0.5, 홀드 0.2 → 0.1), 실제 슬루는 트리에서 나오므로 클록 트랜지션을 뺍니다.
OpenSTA를 apr_finish v02와 그 SPEF로 향하게 합니다. 실행 전에 하나 더 고칩니다. 원래 스크립트는 셋업만 검사해서, 홀드 카드는 통과 여부와 상관없이 항상 0을 표시합니다. 시나리오를 따르도록 바꿔 max 코너에서 셋업, min 코너에서 홀드를 검사합니다. 그리고 Merge로 두 코너를 모읍니다.
셋업: reg2reg, in2reg, in2out은 모두 통과합니다. reg2out은 주소 8비트에서 1.74 ns 부족합니다. 클록을 따라가 보면, 포트로 들어와 버퍼 두 개, 클록 게이트, 그리고 트리 네 단을 더 거쳐 저속 코너에서 플립플롭에 4.6 ns 늦게 도착합니다. 그런데 출력 예산은 여전히 포트의 이상적인 클록 기준 10 ns이므로, 그 4.6 ns가 고스란히 예산에서 빠집니다. 이것은 SoC 담당자와 논의할 문제입니다. 클록 레이턴시를 반영한 출력 지연을 쓰거나, 주소 경로를 더 빠르게 만드는 것입니다. (915개의 "SPEF 오류"는 부하가 없는 넷이고, 빠진 라이브러리 셀 5개는 타이밍이 없는 필러와 탭 셀입니다.)
홀드는 고속 코너에서 모두 통과하고, 가장 빡빡한 쌍도 0.17 ns의 여유가 있습니다. 10편에서는 배선 후 홀드가 0.83 ns 부족했지만, 그 수치는 추정한 배선에서 나온 것이었습니다. 추출한 배선으로는 홀드가 통과합니다. 그래서 추정이 아니라 추출로 사인오프합니다. 슬루 위반 하나가 남아 있습니다. 제한 1.5 ns에 대해 2.2 ns입니다.
만든 것, 남은 것
오픈소스 도구만으로 RTL부터 사인오프까지, 모두 G2에서 했습니다. DDM에는 칩 전체가 있습니다. RTL, 제약 조건, 합성 버전 2개, 배치 배선의 모든 단계, 기생 성분, 사인오프 SDC 2개. 모든 단계가 그곳에서 입력을 가져왔습니다.
남은 과제와 시작점. 모두 스크립트나 SDC 하나를 바꾸고 그 단계부터 다시 실행하면 됩니다.
- 출력 예산 −1.74 ns. SoC와 합의할 제약 조건입니다. 클록 레이턴시를 반영한 출력 지연이나 더 빠른 주소 경로.
- 슬루 위반 1개. CTS 후에
repair_design을 한 번 더 실행. - SRAM 하나의 핀 변에 DRC 107개. 플로어플랜에서 매크로 헤일로를 넓히거나 직접 배치.
- route 단계 타이밍 표가 이상적인 클록 기준. SDC를 읽은 뒤 전파 클록을 설정.
- 모든 코너에 RC 모델 하나. 양산용 PDK가 해결합니다.
시청하고 계속하기
- 동영상: YouTube 재생목록(영어)과 Bilibili 컬렉션(중국어).
- G2가 처음이라면 G2 시작하기부터 보세요.
- 다음 시리즈: 이 코어는 RISC-V SoC: 블록에서 칩으로에서 실제 칩 안의 하드 매크로가 됩니다.
- 프로젝트: G2_demo_sky130. G2는 무료 Community Edition으로 사용할 수 있습니다.
- G2나 직접 흐름을 실행하는 것에 관한 질문: support@deepdataflow.com. 라이선스와 협업: sales@deepdataflow.com.