
同样的 RTL、同样的约束、两套综合脚本:一个时序差了 16 ns,另一个满足时序。这个系列就从这里开始。我们把一个真实的 RISC-V 核心——打开指令缓存的 lowRISC Ibex——在 SkyWater 130 nm 上从 RTL 做到签核,只用 G2 里的开源工具:Yosys 做综合、OpenROAD 做布局布线、OpenRCX 提取寄生参数、OpenSTA 签核。
这篇文章是 12 集视频的文字版。每一节包含该集视频、背后的决定,以及跑出来的数据。所有内容都来自 GitHub 上的 G2_demo_sky130 项目:把它克隆到你的工作区,运行 make setup,项目就出现了。
| 设计 | ibex_top:打开指令缓存的 lowRISC Ibex,因此有 4 个 SRAM macro |
| 工艺 | SkyWater 130 nm(sky130 HD 标准单元) |
| 工具 | Yosys、OpenROAD、OpenRCX、OpenSTA,全部在 G2 里运行 |
| 模块 | 850 × 850 µm、约 2,400 个触发器,加入 filler 后共 98,222 个实例(其中 70,818 个 filler) |
| 结果 | hold 满足(+0.17 ns);setup 只有寄存器到输出没过,8 个地址位差 1.74 ns;107 个 DRC |
第一部分:综合
#1Yosys 综合:从 RTL 到第一份网表
 4:07
在 YouTube 观看(英文) ↗在 Bilibili 观看(中文) ↗
我们的模块是 ibex_top,也就是 lowRISC 的 Ibex RISC-V 处理器核。它的 spec 绑定了 sky130 的标准单元库和两种存储器 macro。打开指令缓存以后,Ibex 有两路,每一路各有一个 tag RAM 和一个 data RAM,一共四个 SRAM macro,比只有标准单元的设计更接近真实的芯片。存储器和其他库一样放在 G2 的库管理器(LIM)里,每个都有一个 LEF 和四个时序 corner,而且随项目一起提供,用标准的 G2 安装包就能运行。
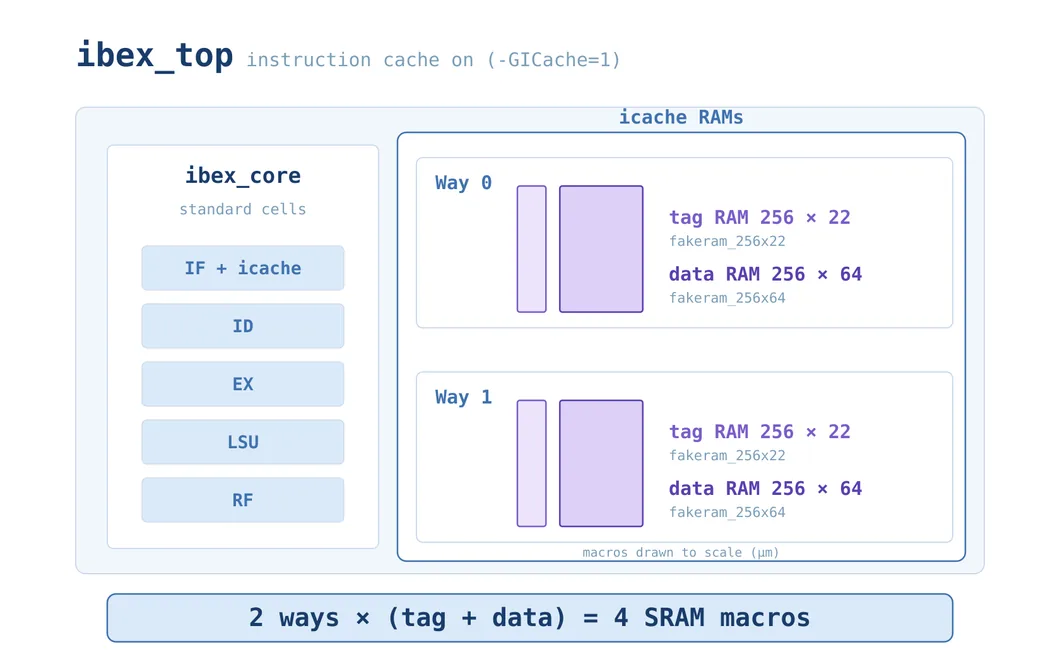
ibex_top:2 路 ×(tag + data)= 4 个 SRAM macro。RTL 在 DDM 里是 rtl v01。文件列表的第一行 -GICache=1 设定了配置,上游的 RTL 本身没有任何修改。剩下的由一个小小的 sky130 工艺层完成:Ibex 需要一个通用的单端口 RAM,sky130 版本把每一种 RAM 尺寸映射到一个真实的 macro。时钟门控使用库里真实的集成门控时钟单元,而不是综合工具无法映射的锁存器。所有 sky130 专用的文件都放在一个文件夹里,其他文件和上游完全一致。
v01 用的是基础脚本:先做通用综合,再以面积为目标映射到单元库,完全没有时序信息。运行大约 20 秒:没有未映射的单元,约 2,400 个寄存器,四个 macro。网表以 syn v01 签入 DDM,之后任何一步都能按版本取用。
在做任何时序分析之前,先用 G2 的 netins 工具看看网表里有什么,结果报告了 1,800 个 macro。分类器不认识 sky130 的单元名称,所以触发器、几个四输入门、存储器和时钟门控全被归成了 macro。这不需要等 G2 出新版本。规则就放在一个纯文本文件 mapping.cfg 里:一个模式、一个冒号、一个类别,第一个匹配的规则生效。
__a4 : Compound
__o4 : Compound
__df : Seq-FF
__sdlclkp : ICG
^fakeram : Memory
重新运行,网表就和预期一致了:2,395 个触发器、四个存储器、一个时钟门控。netins 还会根据它找到的端口写出一份初始 SDC:一个时钟,以及每个端口上的默认延迟。这只是骨架,不是真正的约束。
#2时序驱动的综合,用数据做选择
 4:01
在 YouTube 观看(英文) ↗在 Bilibili 观看(中文) ↗
骨架变成真正的约束。时钟在慢速 corner 下是 40 ns。输入和输出各给周期的四分之一作为外部预算,驱动单元和负载让边界更真实,测试模式关闭,静态配置引脚和复位不做时序分析。约束以 sdc_syn v01 放进 DDM;sdc_signoff_func v01 目前用同样的约束,版图完成后再出第二版。
问题来了:Yosys 不能针对 SDC 做优化。新版本能解析 SDC,但只是用来保留里面引用到的对象。Yosys 有的是 ABC 的延迟目标 -D,以及一个只含驱动单元和负载的约束文件。陷阱在这里:我们只用 -D,得到的网表一个字节都没变。只有同时给 ABC -constr,它才会插 buffer、调整门的尺寸。
所以进阶脚本直接从 SDC 读数字:周期减掉 IO 预算、再减掉 uncertainty,给 ABC 的就是 29 ns。驱动单元和负载也来自同一个文件,只有一个数据来源。它还打开了 Booth 乘法器。日志确认 ABC 拿到了 29,000 ps 和 buf_2 驱动单元。
接着用 OpenSTA 评估两份网表,同样的 scenario、同样的 SDC,只有网表不同。
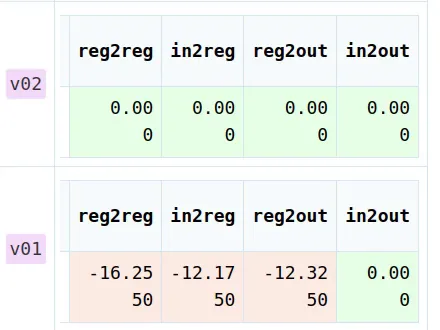
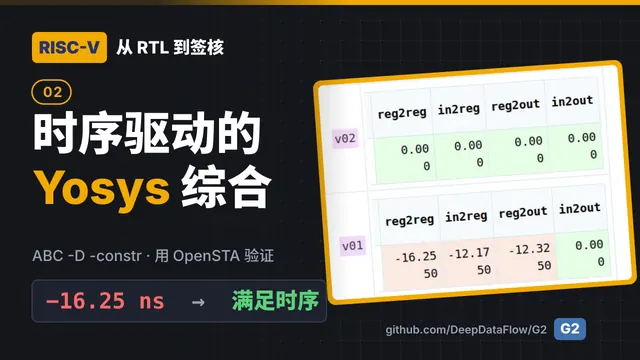
v01 除了输入到输出全部失败;时序驱动的 v02 全部满足。| v01 基础 | v02 时序驱动 | |
|---|---|---|
| reg2reg | −16.25 ns | 满足(+6.65) |
| in2reg | −12.17 ns | 满足(+13.13) |
| reg2out | −12.32 ns | 满足(+6.67) |
| buffer 数 | 0 | 1,494 |
| 标准单元 | 16,634 | 17,432(+4.8%) |
基础版为什么失败?它的最差路径上,一个触发器通过最小尺寸的输出驱动 259 个引脚:单一一级就花了将近 12 ns。这正是插 buffer 要解决的。多 5% 的单元换来 23 ns 的 slack:v02 交给 OpenROAD。这些是布局前的数字,理想时钟、没有连线,而且 v02 还有 slew 违规,布局布线会修好。
第二部分:OpenROAD,一集一个阶段
#3把网表带进 OpenROAD
 3:58
在 YouTube 观看(英文) ↗在 Bilibili 观看(中文) ↗
布局布线需要自己的约束。第一轮的 sdc_apr_func v01 就是综合约束:40 ns,带 uncertainty 的理想时钟,后面的阶段再换成真实的时钟树。在 G2 里检出 OpenROAD 会得到八个阶段,从 init 到 finish,每个阶段的 DDM 视图都列出它的输入。
init 脚本读入工艺和单元的 LEF(包括两个 SRAM),从 MMMC 文件按 corner 加载时序库,读入并链接网表,再读入 SDC。这里改了一处:我们的网表是层级式的,而 OpenROAD 的层级链接模式还标着开发中,所以我们用扁平方式链接。
link_design $blkname ;# 原本是:link_design -hier $blkname运行 20 秒,没有错误,但要看警告:ORD-2011,两个 SRAM 有 LEF 却没有 liberty。OpenROAD 能放置它们,却不能对它们做时序分析。这个版本的生成器只列出标准单元库(下个版本已修正),所以我们手动加上存储器的库,慢速和快速 corner 各一个,而且不要再按 Gen,否则会覆盖这个文件。之后每个阶段都读这个文件,修一次就涵盖整个流程。
修正之后,慢速 corner 下各路径组的最差 slack 和第 2 集的 OpenSTA 完全一样,reg2reg +6.652 ns:同样的网表、同样的 SDC、同样的库。四个 macro、17,400 个实例,以及综合加入的 1,800 个 buffer 和反相器。transition 和电容还有违规,placement 会修好。
#4Floorplan:die、SRAM macro 与电源网格
 2:23
在 YouTube 观看(英文) ↗在 Bilibili 观看(中文) ↗
floorplan 脚本建立 die 和 core、铺设绕线轨道、移除综合加入的 buffer(OpenROAD 会根据真实的布局重新插入)、以 20 µm 的 halo 放置四个 SRAM、插入 tap cell,然后建立电源网格。
原本 die 和 core 一样大,都是 850 µm,没有留边。这样 SRAM 会紧贴 die 的边缘,也就是 IO 引脚的位置:引脚压在 macro 上,绕线时就会短路,电源环也会超出 die。我们留了 10 µm,core 是 830 µm。
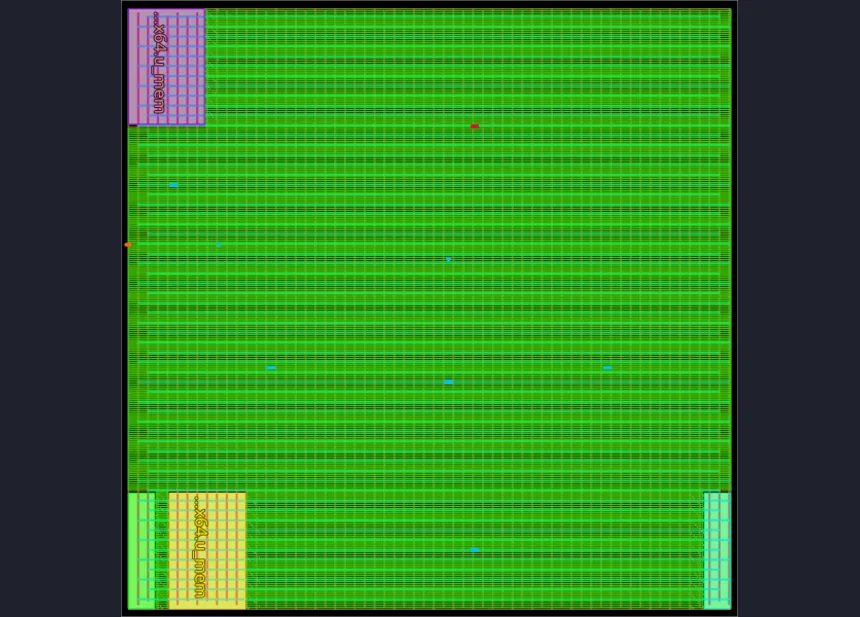
时序是故意变红的:移除综合的 1,494 个 buffer 之后 reg2reg 是 −14.7 ns,长线用很小的单元驱动大负载。这个阶段加了 8,568 个 tap cell;buffer 和反相器从 1,800 个降到 334 个;利用率是 850 µm die 的 31%。
#5Placement 与设计修复
 2:35
在 YouTube 观看(英文) ↗在 Bilibili 观看(中文) ↗
placement 先做一次忽略引脚的粗略全局布局,把引脚放到它连接的逻辑旁边,再考虑绕线拥塞重新布局一次。接着估算连线,运行 repair_design,通过插 buffer 和调整尺寸修好所有 slew、电容和扇出违规,最后把每个单元合法化到行上。大约一分钟。
repair_design 找到 710 个 slew 违规和 235 个电容违规,插入 1,258 个 buffer,调整了 673 个单元的尺寸。用真实的布局连线,时序回来了:reg2reg +1.820 ns,reg2out 差 0.63 ns,post-CTS 会修好。transition 和电容都没有违规了,利用率 34%。
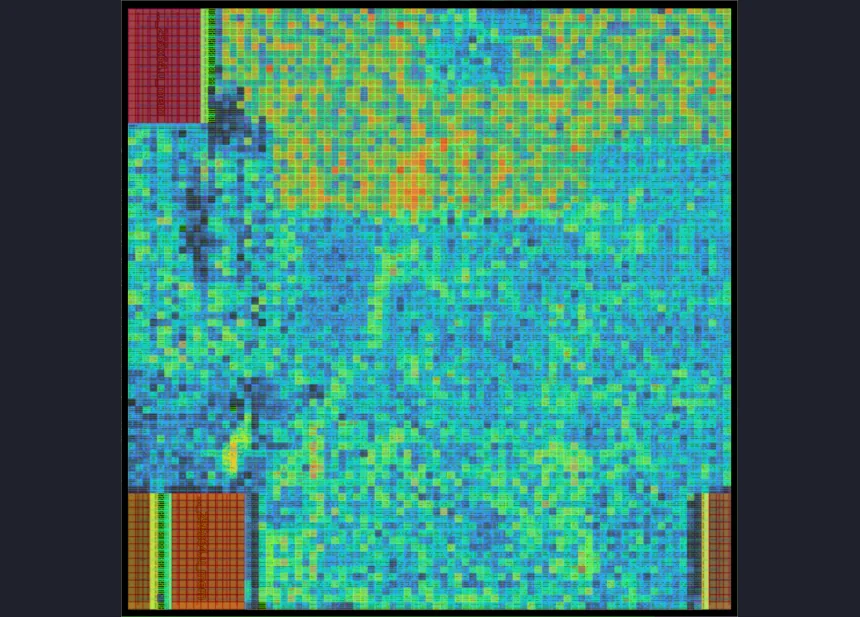
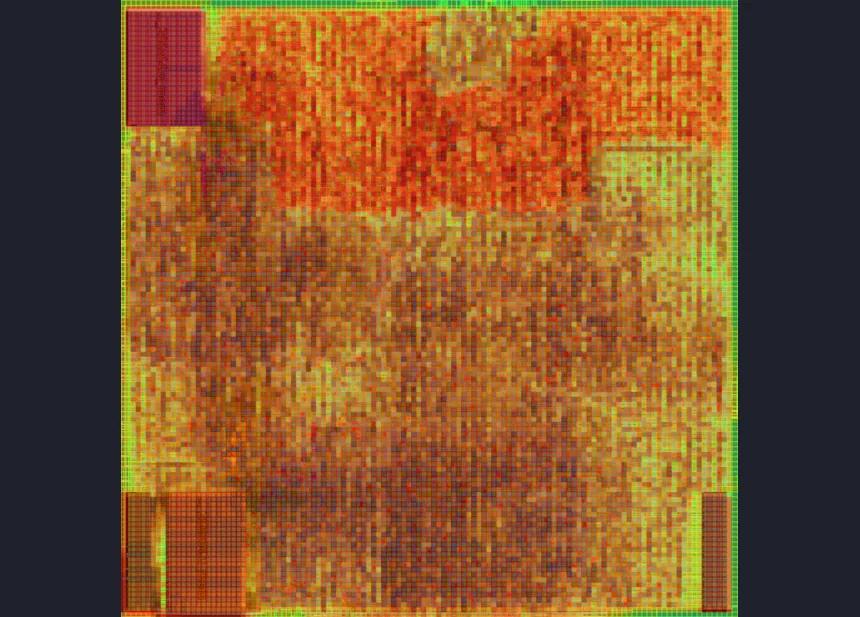
拥塞估算在寄存器堆上方、以及左侧 SRAM 旁边的窄通道最热。这个通道到绕线时还会再出现。
#6时钟树综合:零错误,却没有时钟树
 2:34
在 YouTube 观看(英文) ↗在 Bilibili 观看(中文) ↗
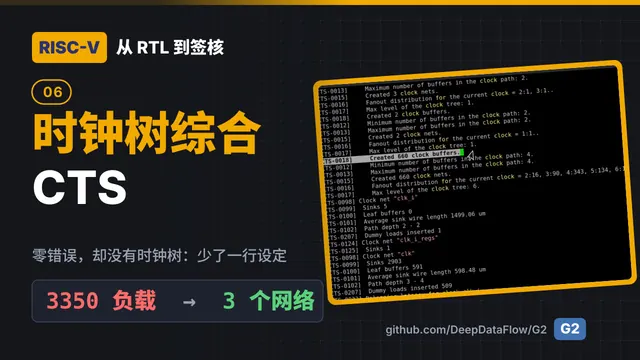
CTS 把时钟反相器复制到负载旁边,只用一种 buffer clkbuf_4 建树,修正从时钟引脚到树根的长线,再把新的 buffer 合法化。第一次运行报告没有错误。但日志说时钟连线的电阻和电容都是零,接着 CTS 以为时钟有 3,350 个 macro 负载,还跳过了几百条复制出来的线,时钟门控单元后面根本没有建出时钟树。
placement 阶段设定过连线 RC,但这个设定不会存进数据库,而 CTS 脚本又没有重新设定。加三行、和 placement 用的一样,就修好了:
source $fvar(layer_rc)
set_wire_rc -signal -layer $wire_rc_layer
set_wire_rc -clock -layer $wire_rc_layer_clk
现在 CTS 找到三个时钟网络:一个从时钟引脚驱动四个 SRAM 和时钟门控单元;一个是没有门控的触发器;还有 core clock gate 后面的门控时钟,几乎包含了所有寄存器,放了 660 个 buffer。修正之前,这个时钟域根本没有时钟树,2,400 个触发器挂在一条没有缓冲的线上,而这个阶段照样报告零错误。要看日志,不能只看错误数。
#7Post-CTS 时序修复
 2:17
在 YouTube 观看(英文) ↗在 Bilibili 观看(中文) ↗
CTS 之后,时序才是真的。时钟从理想改成传播时钟,每个触发器看到的都是经过时钟树的真实到达时间。接着 repair_timing 通过调整尺寸和插 buffer 修正 setup 与 hold,再对电源网格做一次静态 IR drop 检查。
用了真实时钟,有 17 个端点 setup 不过:时钟树增加了大约 4 ns 的延迟,吃掉了输出预算。repair_timing 用八个 buffer 全部修好,从 −5.2 ns 到 +0.109 ns,hold 也满足。有一条 net 超出 slew 限值 160 ps;真正流片时,我们会在 CTS 之后再跑一次 repair_design。静态 IR drop 最差 147 µV,约为 1.6 V 的 0.01%:对这个设计来说电源网格非常充裕。
#8全局与详细绕线
 2:01
在 YouTube 观看(英文) ↗在 Bilibili 观看(中文) ↗
绕线先把常数 tie net 标为特殊线让绕线器跳过,为每个单元引脚找到合法的接入方式,在粗网格上规划每条 net,最多再跑一百轮来消除拥塞,修复天线效应,然后用十轮详细绕线画出真正的金属。它在后台运行大约 16 分钟(运行时间卡片显示一个半小时,那是八个线程加起来的时间)。
全局绕线结束时 overflow 为零,天线修复把 291 个违规降到零,详细绕线从 8,985 个违规降到 127 个。
这个阶段的时序表可以先跳过:route 的报告又回到理想时钟,不是真正的数字。签核才是。
#9绕线后清理与 DRC
 1:51
在 YouTube 观看(英文) ↗在 Bilibili 观看(中文) ↗
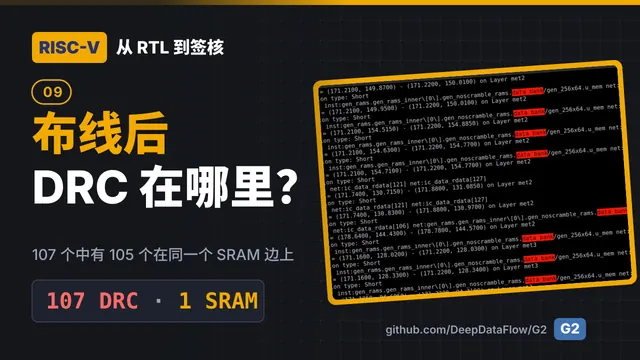
post-route 修复天线、重新计算引脚接入、再跑五轮详细绕线和一个天线修复循环,最后用独立的 DRC 检查收尾。大约六分钟,剩下 107 个违规,其中 62 个是短路。绕线器自己的计数忽高忽低,而且包含重复;DRC 卡片的数字来自最后那次独立检查。
几乎全部——107 个里有 105 个——都在同一个 SRAM,也就是指令缓存的一个 data bank,以及紧邻它的 net 上,位于 metal 2 和 3。这个 SRAM 的 140 个信号引脚全在 metal 3 的同一条边上,标准单元又紧紧贴着这条边,绕线器根本没有空间接进引脚。多跑几轮绕线修不好,要改 floorplan。
#10Finish:完整的芯片,以及还剩下什么
 2:48
在 YouTube 观看(英文) ↗在 Bilibili 观看(中文) ↗
finish 用 filler 单元填满行上的空隙,再检查一次布局合法性和 DRC,做 IR 分析,写出 DEF、网表和数据库。提取寄生参数的那几行被注释掉了,所以这里不产生 SPEF,交给 OpenRCX。结果是 98,222 个实例,其中 70,818 个是 filler;DRC 和 post-route 一样是 107 个(finish 不会重新绕线);IR drop 最差约 0.11 mV。
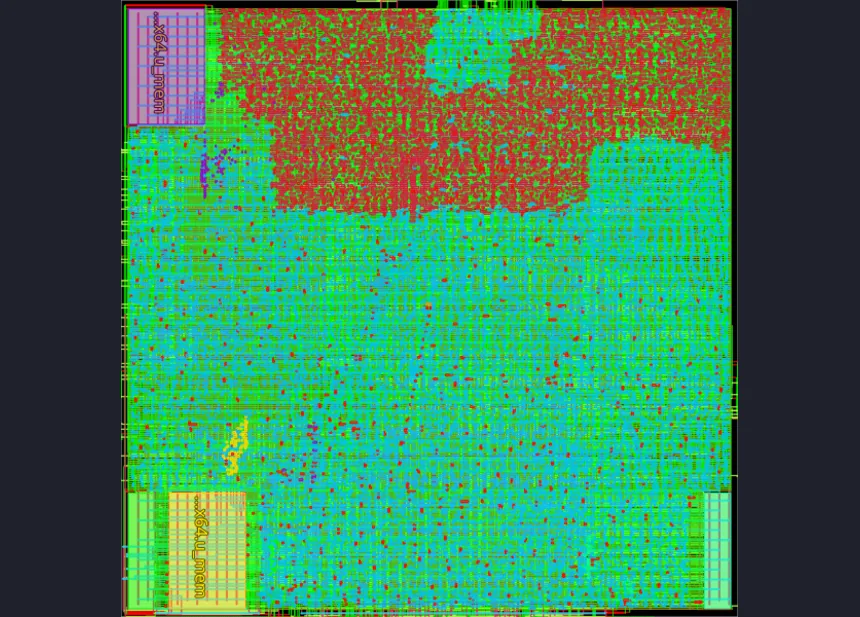
从 init 到 finish,每个阶段都在 G2 的同一个页面上,各有日志、报告、卡片和图片,而且每个阶段都签入了 DDM。改了一个脚本,就从那个阶段重跑,和这次的结果比较。
第三部分:签核
#11用 OpenRCX 提取寄生参数
 2:16
在 YouTube 观看(英文) ↗在 Bilibili 观看(中文) ↗
签核时序需要真实的连线:每条已绕线 net 的电阻和电容。在 G2 的流程页面里,OpenRCX 就在 OpenROAD 旁边。它的脚本读入完成的数据库(apr_finish v02),对项目要求的每个 corner——从低温到高温共四个——用 PDK spec 里该 corner 的规则文件提取并写出一个 SPEF。
运行 14 秒,没有错误:18,670 条 net、111,215 个电阻、206,593 个耦合电容。四个 SPEF 文件大小相同,这很诚实:sky130 开放的规则文件只有一个 RC 模型,所以每个 corner 得到的数字都一样。量产用的 PDK 会为每个 corner 提供规则文件,而流程本来就为每个 corner 产生一个 SPEF,所以只需要换文件。SPEF 签入和版图相同的 DDM 版本,现在 apr_finish v02 带着它的网表、DEF 和寄生参数。
#12用 OpenSTA 做绕线后签核
 5:03
在 YouTube 观看(英文) ↗在 Bilibili 观看(中文) ↗
第 2 集我们用 OpenSTA 评估网表时,是理想时钟、没有连线。现在同样的 OpenSTA 拿到真实的版图。签核 SDC 出第二版,有三处修改:传播时钟,让 OpenSTA 跟着真实的时钟树走;更小的 uncertainty,setup 从 1 ns 降到 0.5、hold 从 0.2 降到 0.1,因为 skew 现在是测量出来的;去掉 clock transition,因为真实的 slew 来自时钟树。
把 OpenSTA 指向 apr_finish v02 和它的 SPEF。运行之前还有一个修正:原本的脚本只检查 setup,所以 hold 卡片永远显示零,不管通过与否。我们让它跟着 scenario 走:max corner 查 setup,min corner 查 hold。然后用 Merge 汇总两个 corner。
setup:reg2reg、in2reg 和 in2out 都通过。reg2out 在 8 个地址位上差 1.74 ns。沿着时钟看:它从端口进来,经过两个 buffer、时钟门控,再经过四级时钟树,在慢速 corner 下到达触发器时已经晚了 4.6 ns。可是输出预算还是 10 ns,是从端口上的理想时钟算起的,这 4.6 ns 就直接从预算里扣掉了。这要和负责 SoC 的人讨论:用考虑时钟延迟的 output delay,或者把地址路径做得更快。(915 个“SPEF 错误”是没有负载的 net,五个缺少的库单元是没有时序的 filler 和 tap cell。)
hold 在快速 corner 全部通过,最紧的一对还有 0.17 ns 余量。第 10 集绕线之后 hold 差了 0.83 ns,但那个数字来自估算的连线。用提取出来的连线,hold 是通过的。这就是为什么签核要用提取结果,而不是估算。还剩一个 slew 违规:2.2 ns,限值 1.5 ns。
我们做了什么,还剩下什么
从 RTL 到签核,全部用开源工具、全部在 G2 里。DDM 里有整颗芯片:RTL、约束、两个综合版本、每个布局布线阶段、寄生参数,以及两版签核 SDC。每一步都从那里取得输入。
遗留问题,以及从哪里着手。每一项都只要改一个脚本或一个 SDC,再从那一步重跑:
- 输出预算 −1.74 ns。要和 SoC 一起商定的约束:考虑时钟延迟的 output delay,或者更快的地址路径。
- 一个 slew 违规。在 CTS 之后再跑一次
repair_design。 - 一个 SRAM 引脚边上的 107 个 DRC。在 floorplan 里给 macro 更宽的 halo,或者手动摆放。
- route 阶段的时序表用的是理想时钟。在读入 SDC 之后设定传播时钟。
- 所有 corner 只有一个 RC 模型。量产 PDK 会解决。
观看与继续
- 视频:Bilibili 合集(中文)与 YouTube 播放列表(英文)。
- 第一次用 G2?先看 G2 入门。
- 下一个系列:这个核心在 RISC-V SoC 实战:从模块到芯片 里变成一颗真实芯片里的硬核 macro。
- 项目:G2_demo_sky130。G2 本身有免费的社区版。
- 关于 G2 或自己跑流程的问题:support@deepdataflow.com。授权与合作:sales@deepdataflow.com。