
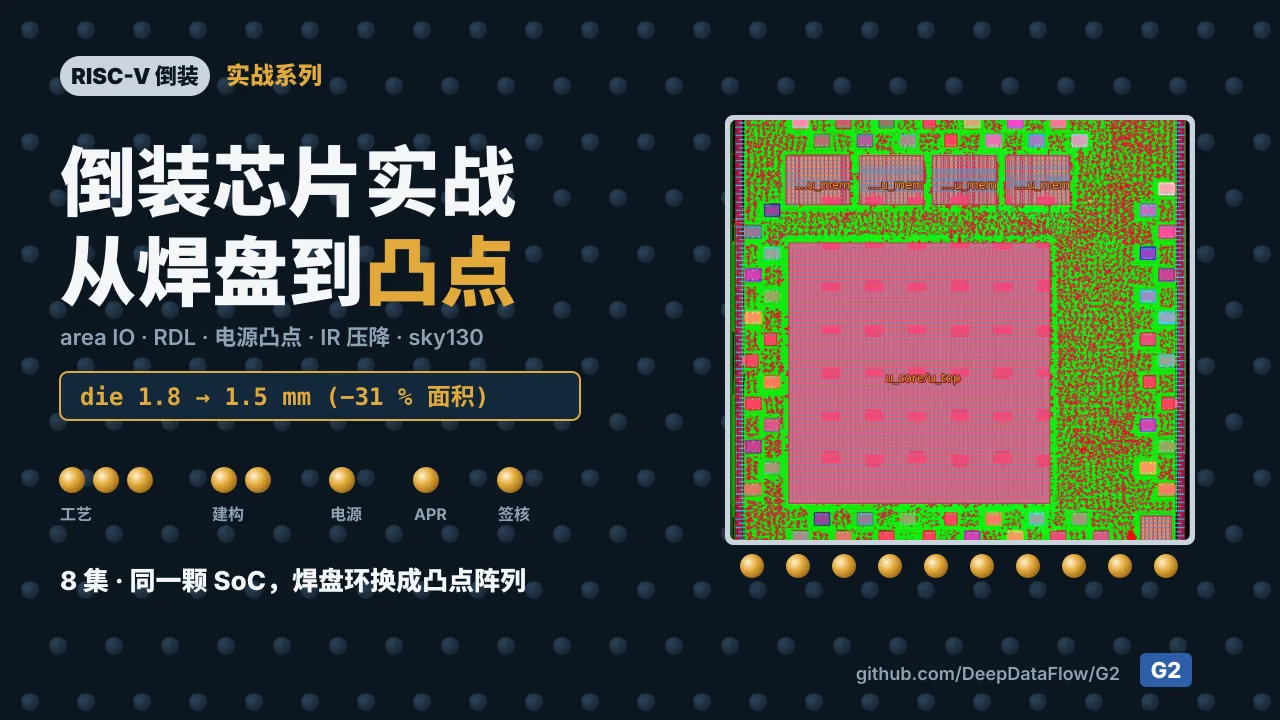
在 RISC-V SoC 實戰:從模組到晶片 裡,我們圍繞一個 RISC-V 核心做出了一顆真正的晶片:58 個 pad 排成環,圍著 lowRISC 的 Ibex demo system,系列一的核心作為硬核 macro 放在裡面。那顆晶片是 wirebond:它透過邊緣上的 pad 和封裝連接。這個系列改變同一顆晶片和電路板相連的方式:從邊緣上的 pad,變成晶片表面上的凸塊。
我們拿掉 pad 環,把 IO 單元搬進晶片、放到各自的凸塊下面(area IO),電源則從覆蓋整個 core 的凸塊進來。然後把覆晶晶片和 wirebond 晶片比較面積、電源網路、IR 壓降、IO 時序與 core 時序。其中有一個數字,並沒有看起來那麼可靠。
這篇文章是 8 集影片的文字版。所有檔案都在 G2_demo_sky130 專案裡。
| 起點 | RISC-V SoC 實戰 的 wirebond 晶片:1.8 mm die、58 個 pad、sky130 |
| 改動 | 沒有 pad 環:58 個 area IO 單元放在各自的凸塊下面,core 上方 7 × 7 的電源凸塊 |
| 工具 | G2 裡的 OpenROAD、OpenRCX、OpenSTA,加上一個替代的重分佈層 |
| 面積 | 每邊 1.8 → 1.5 mm:−31 % |
| 時序 | hold 滿足;core 邊界 setup −1.61 ns(wirebond 是 −1.45 ns),同樣的 core 預算 |
第一部分:為什麼要覆晶,需要什麼
#1為什麼要覆晶?
 1:45
在 YouTube 觀看(英文) ↗在 Bilibili 觀看(中文) ↗
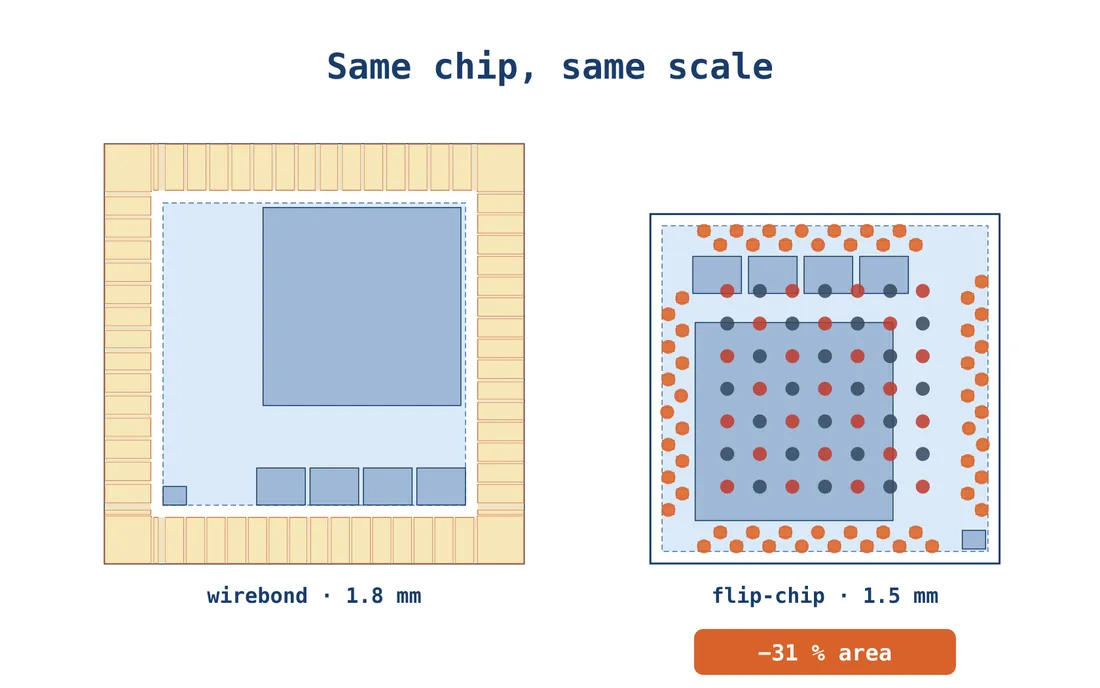
系列二的晶片是 1.8 mm 見方,58 個 pad 圍著 1.3 mm 的 core。pad 環大約佔了 die 的一半。決定尺寸的是 pad,不是邏輯:這顆晶片是 pad 受限的。而且 core 的所有電流,都從兩個電源 pad 進來,再繞著環走。
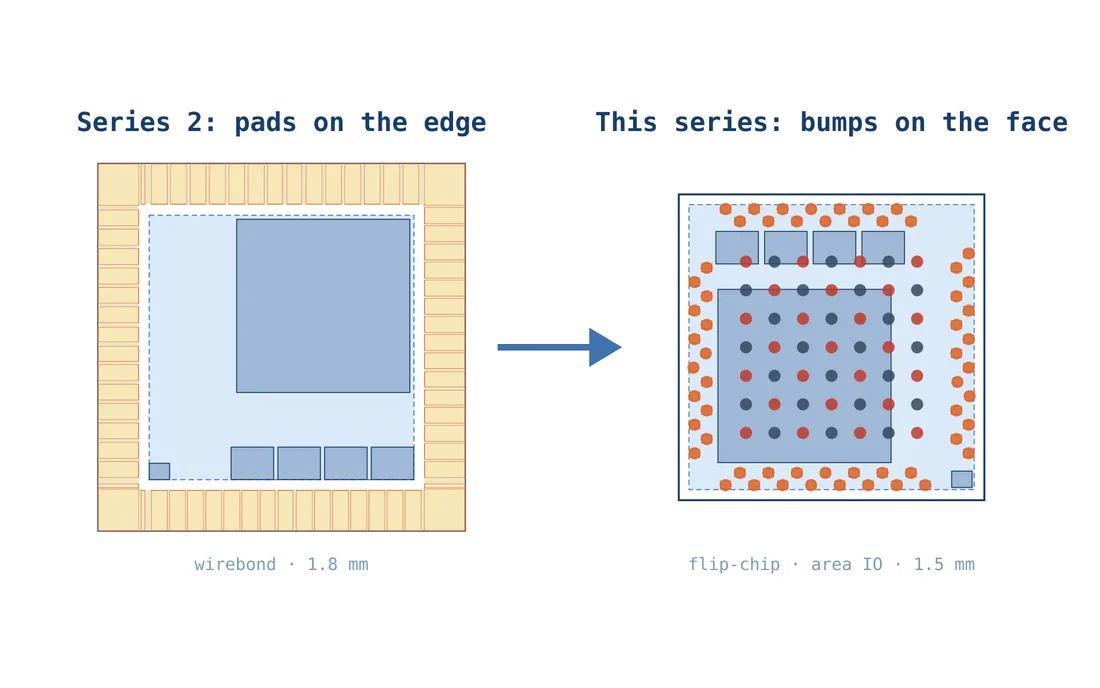
wirebond 晶片透過邊緣上的線和封裝溝通。覆晶晶片則是把晶片翻過來、正面朝下放在焊料凸塊上,由重分佈層(RDL)把凸塊連到電路。做法有兩種:可以把凸塊放在原來的 pad 環上,但這樣環還在,面積也不變;或者把 IO 單元搬進晶片、放到凸塊下面。這就是 area IO,也是我們要做的。
#2metal5 上面的一層
 1:12
在 YouTube 觀看(英文) ↗在 Bilibili 觀看(中文) ↗
凸塊要放在哪裡?metal5 走的是晶片的電源網路。metal4 屬於硬核:系列二裡我們讓核心不用 metal5,好讓晶片擁有最上層。所以凸塊需要自己的一層,在 metal5 上面。
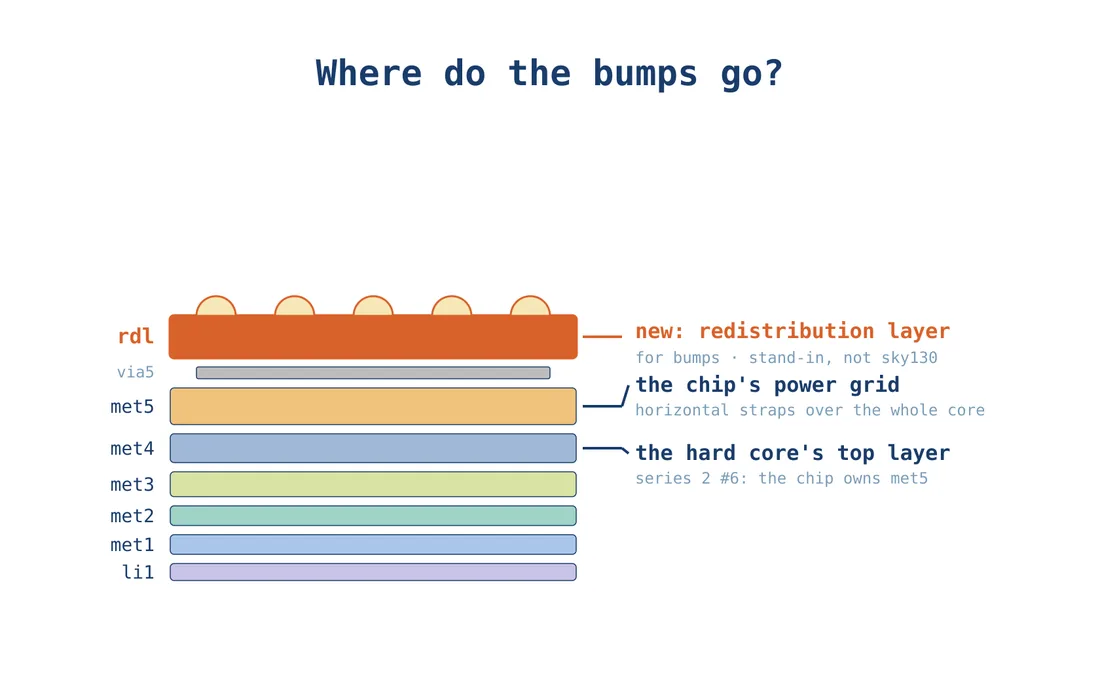
一個小腳本 gen_rdl_tech.py 把它加進 sky130 製程 LEF 的一份副本:從 metal5 往上的 via5、一層 10 µm 厚、叫做 rdl 的金屬,以及兩者之間的 via 單元 M5RDL。原本的 sky130 檔案不動。凸塊是 rdl 上一個 60 µm 的八邊形,只有一個 pin。新的層也需要在 RC 檔案裡給電阻值:IR 分析從這裡讀電阻,不是從 LEF,少了它就會失敗。OpenROAD 讀進來是 15 層。
#3area IO 單元
 1:03
在 YouTube 觀看(英文) ↗在 Bilibili 觀看(中文) ↗
系列二的 IO 單元是 80 × 198 µm,電源是它兩側邊上細細的 pin。它只能和其他 IO 單元並排,排成環才能用。
所以我們給同一個單元做第二種物理視圖。名字和訊號 pin 都一樣,所以網表和時序元件庫都不用改。但它是一個可以放在任何地方的小 block:50 × 40 µm,凸塊 pin 在 rdl 上,core 電源是 metal4 的 rail,晶片的電源網路可以像接任何 macro 一樣接到它。
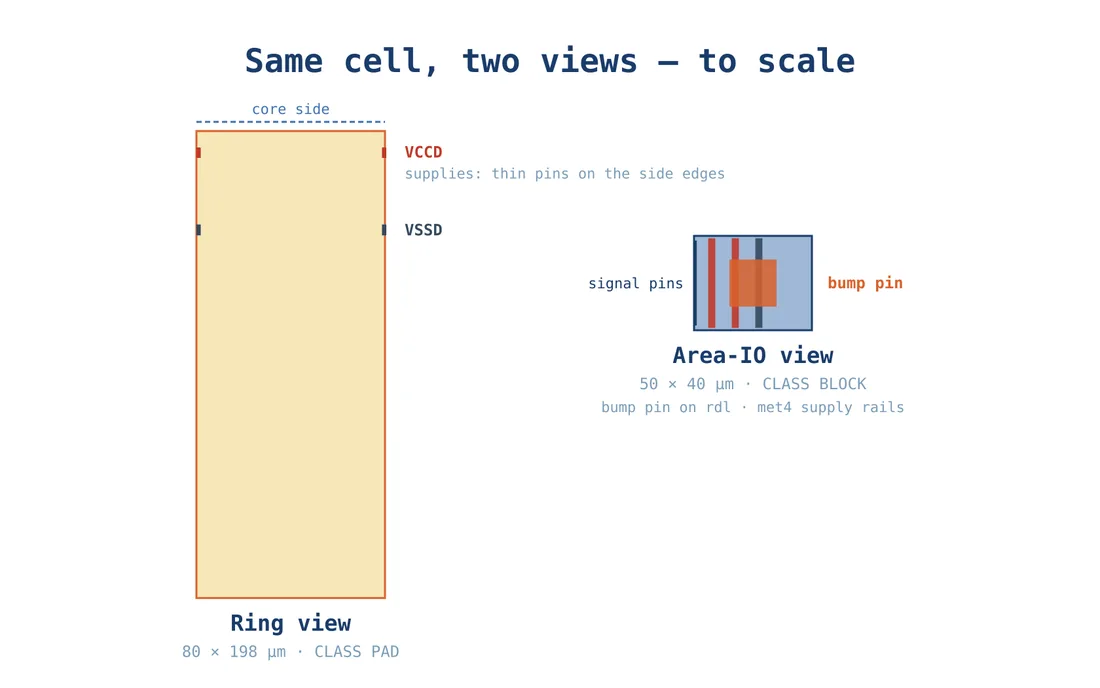
沒有建模的部分:3.3 V 的 IO 電源,以及 pad 的模擬部分。真正的 area IO 元件庫會有這些;我們的是替代模型。另外還生成一個凸塊 pin 放在 metal2 短線上的版本,簽核提取時會用到。
第二部分:覆晶晶片的 floorplan
#4沒有 pad 環的新版本
 1:04
在 YouTube 觀看(英文) ↗在 Bilibili 觀看(中文) ↗
覆晶晶片是一個新的 build v02,和 wirebond 晶片並列,網表與約束都一樣。設計變數改了:die 從 1.8 mm 改成 1.5 mm、替代製程、凸塊,以及用 area IO 單元取代環形單元。現在每個階段都讀這些變數,所以每個階段都看得到新的層。
floorplan 多了兩個 hook:macro 放置之前放 area IO,電源網路之後放凸塊。pad 環的腳本拿掉了,core 電源環也不再找 pad。init 幾秒鐘就跑完,log 顯示 15 層與新的 IO 視圖。
#5凸塊下面的 IO
 1:34
在 YouTube 觀看(英文) ↗在 Bilibili 觀看(中文) ↗
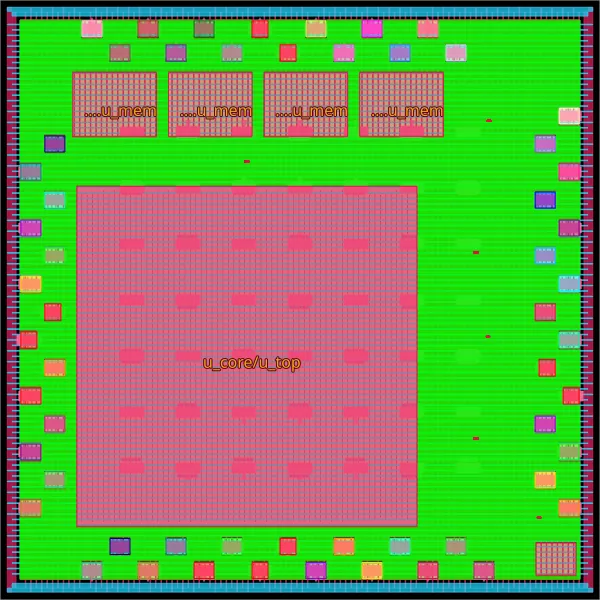
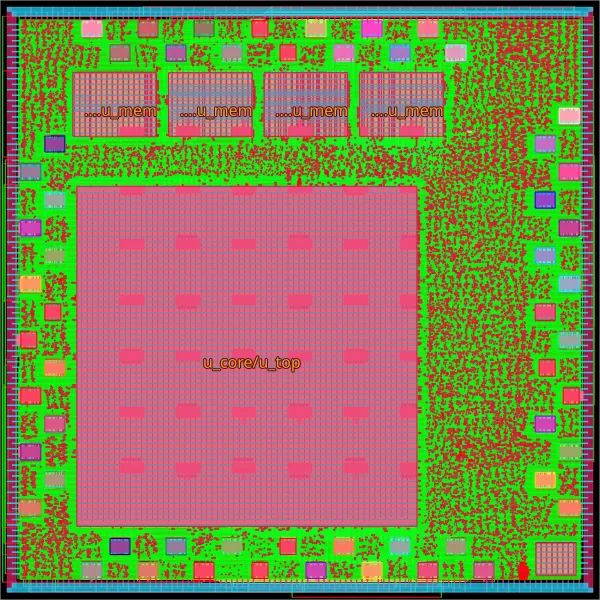
每個 IO 單元都搬進晶片,靠近邊緣,順序和原來的環一樣,每邊兩排、錯開排列,這樣凸塊才放得下。然後在每個 IO 單元的凸塊 pin 正上方放一個凸塊。它們重疊,所以就連上了:訊號不需要繞線。同一排的凸塊相距 140 µm,兩排之間至少 92 µm。
floorplan 大約跑兩分鐘。log 裡放好了 58 個 IO 單元、58 個 IO 凸塊,macro 放置工具把 58 個 IO 單元都當成固定的 macro,繞開它們。晶片有 64 個 macro,其中 58 個是 IO 單元,die 寬 1,500 µm。
第三部分:電源與 IR 壓降
#6電源凸塊與 IR 壓降
 2:06
在 YouTube 觀看(英文) ↗在 Bilibili 觀看(中文) ↗
電源凸塊在 core 上方排成 7 × 7 的陣列,電源和地交替。每個凸塊下面有一組 via 陣列,往下連到它自己那個 net 的 metal5 電源條:25 個電源凸塊、24 個地凸塊,大約 450 個 via。
現在電源和地都是真正的晶片埠,所以電源網路檢查對兩者都能做,而且兩個都完全連通。wirebond 晶片連這樣的檢查都做不了,因為它沒有電源埠。
placement 時,從 25 個電源凸塊分析的 IR 壓降,平均大約半毫伏(0.475 mV),最差 3.13 mV。那 wirebond 晶片呢?它的 log 寫著 64 µV。上面那一行說明了原因:沒有電源埠,所以工具自己編了一組凸塊。這個數字從來就不是真的。
所以我們告訴工具,wirebond 晶片的電真正從哪裡進來:兩個 core 電源 pad。每個 pad 一行:core 環上的一個位置、一個大小,以及電壓。同樣的兩個位置,建模兩次:
| wirebond 的電源入口 | 平均 | 最差 |
|---|---|---|
| 每個電源 pad 一個 10 µm 的點 | 4.19 mV | 9.29 mV |
| 整個 75 µm 的 pad 邊 | 0.45 mV | 2.18 mV |
| 覆晶晶片,25 個電源凸塊 | 0.475 mV | 3.13 mV |
用 10 µm 的點,覆晶晶片看起來好了九倍;用整個 pad 的邊,優勢就不見了。
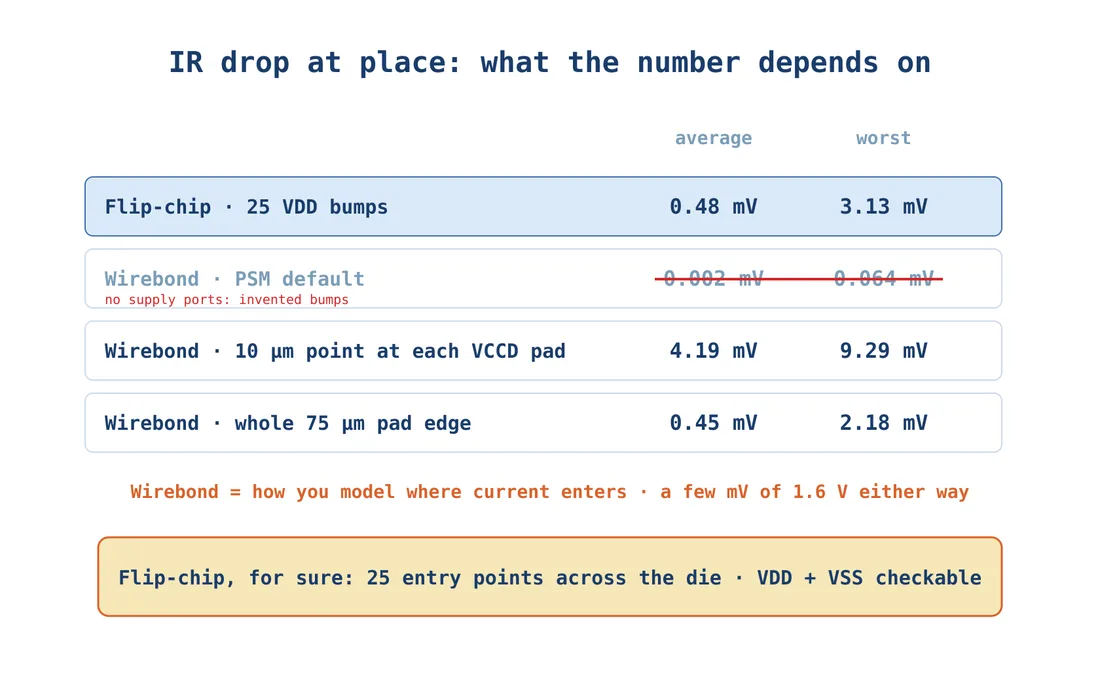
所以 wirebond 的數字,主要反映的是你怎麼建模電流的入口。真正的路徑,經過 pad、環和 bond wire,兩個模型裡都沒有。以這顆晶片的功耗,不管哪種都是 1.6 V 裡的幾毫伏。覆晶晶片確定能給的是:電從整個 die 上的 25 個點進來,功耗變大時依然有效;而且電源和地都能檢查。
第四部分:佈局、繞線與簽核
#7佈局、CTS 與繞線
 1:19
在 YouTube 觀看(英文) ↗在 Bilibili 觀看(中文) ↗
時脈樹和第一次 hold 修復跟系列二一樣,每個階段不到一分鐘。練習時這樣還不夠:繞線以後,真實的線讓除錯模組的 hold 少了大約三分之一奈秒(39 個端點 −0.330 ns)。
所以 route 階段加了一個 hook。全域繞線一完成,就用繞好的線估計時序、修 hold,然後才做細部繞線。只修 hold:練習時在這個時候修 setup,會去追輸出 pad 上一個錯誤的估計,還把細部繞線搞壞了。
route 大約跑十三分鐘。log 裡有 97 個 hold 端點、31 個 buffer,最差 hold 從 −0.539 ns 變成 +0.101 ns。postroute 大約半小時,finish 三分鐘,最後剩 8 個 DRC 違規:這是示範,不是下線(tape-out)。finish 時紅色的輸出 pad 數字,和 wirebond 晶片在這個階段一模一樣;簽核會好好檢查這些路徑。
#8簽核與結論
 2:16
在 YouTube 觀看(英文) ↗在 Bilibili 觀看(中文) ↗
簽核從寄生參數提取開始,而 OpenRCX 在我們的替代層上崩潰了。更糟的是,這個階段還顯示零個錯誤;這已經記進 G2 的 bug 清單。在這個設計裡,訊號從來不經過 RDL 層,所以我們只提取 die 本身:在記憶體裡拿掉凸塊和 RDL 圖形,用原本的 sky130 檔案提取。凸塊屬於封裝模型。這樣提取四個 corner 不到一分鐘。
OpenSTA 用和 wirebond 晶片同一個腳本,一個慢 corner、一個快 corner,各大約 15 秒。hold 滿足。setup 在 226 個端點上差 1.61 ns,進到除錯模組的記憶體:和系列二一樣,是 core 邊界的路徑。
同一個 IO 路徑腳本在兩顆晶片上,印出每個埠的 slack,以及路徑在 core 裡面的那一段。輸入在覆晶晶片上好了大約 2 ns。輸出差了 2 到 2.5 ns,而且全部在 core 裡面、pad 單元之前:是時脈和邏輯,不是 pad。原因我們還沒有分離出來。每條 IO 路徑都還有超過 10 ns 的 slack。
結論,以及還剩下什麼
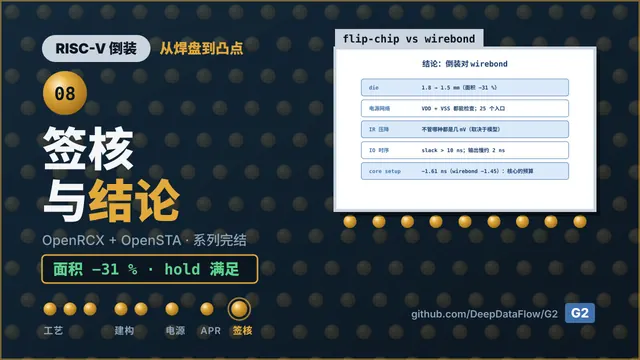
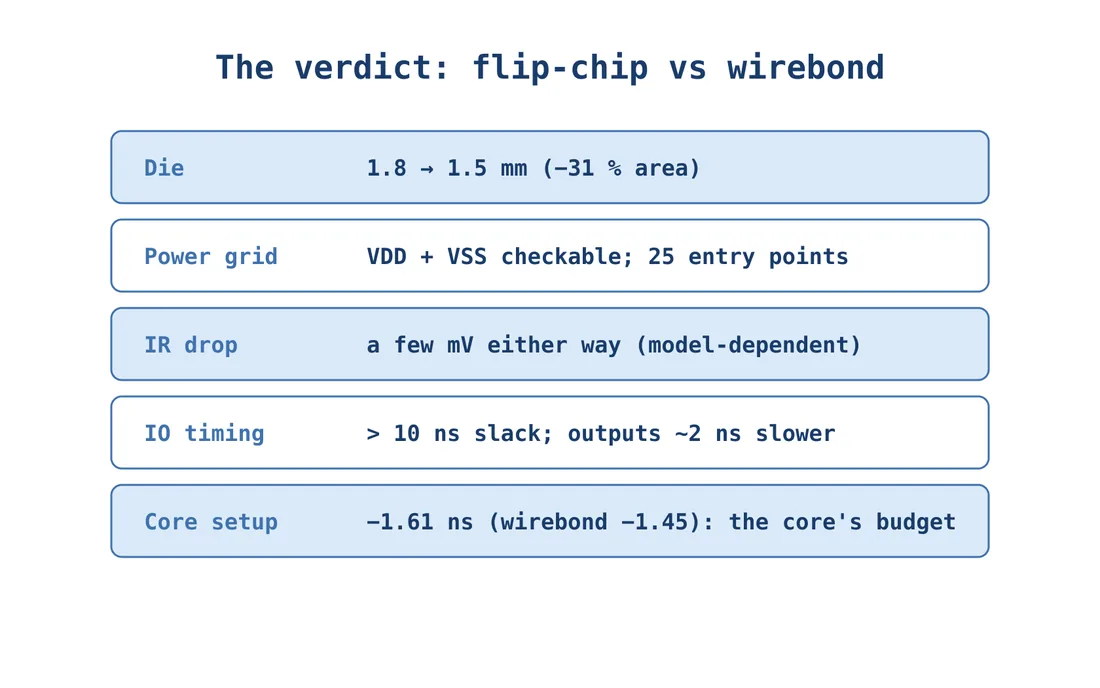
- 面積:少了 31 %,每邊從 1.8 mm 變成 1.5 mm。
- 電源網路:電源和地都能檢查,電從整個 die 上的 25 個點進來。
- IR 壓降:在這個功耗下,不管哪種都是幾毫伏,而且 wirebond 的數字取決於你怎麼建模。
- IO 時序:每條 IO 路徑都還有超過 10 ns 的 slack;輸出慢了大約 2 ns,在 core 裡面。
- core 時序:和之前一樣的預算。
這個系列沒有做的:視圖是替代模型,沒有 DRC、LVS 或 GDS;3.3 V 的 IO 電源沒有建模;凸塊與 RDL 的寄生參數沒有提取;core 的 setup 遺留問題還在;還剩 8 個 DRC 違規。
觀看與動手
- 影片:Bilibili 合集(中文)與 YouTube 播放清單(英文)。
- 這個系列出發的 wirebond 晶片:RISC-V SoC 實戰:從模組到晶片。
- 專案:G2_demo_sky130。G2 本身有免費的社群版。
- 關於 G2 或自己跑流程的問題:support@deepdataflow.com。授權與合作:sales@deepdataflow.com。