
在 RISC-V SoC 实战:从模块到芯片 里,我们围绕一个 RISC-V 核心做出了一颗真正的芯片:58 个 pad 排成环,围着 lowRISC 的 Ibex demo system,系列一的核心作为硬核 macro 放在里面。那颗芯片是 wirebond:它通过边缘上的 pad 和封装连接。这个系列改变同一颗芯片和电路板相连的方式:从边缘上的 pad,变成芯片表面上的凸点。
我们拿掉 pad 环,把 IO 单元搬进芯片、放到各自的凸点下面(area IO),电源则从覆盖整个 core 的凸点进来。然后把倒装芯片和 wirebond 芯片比较面积、电源网络、IR 压降、IO 时序与 core 时序。其中有一个数字,并没有看起来那么可靠。
这篇文章是 8 集视频的文字版。所有文件都在 G2_demo_sky130 项目里。
| 起点 | RISC-V SoC 实战 的 wirebond 芯片:1.8 mm die、58 个 pad、sky130 |
| 改动 | 没有 pad 环:58 个 area IO 单元放在各自的凸点下面,core 上方 7 × 7 的电源凸点 |
| 工具 | G2 里的 OpenROAD、OpenRCX、OpenSTA,加上一个替代的重布线层 |
| 面积 | 每边 1.8 → 1.5 mm:−31 % |
| 时序 | hold 满足;core 边界 setup −1.61 ns(wirebond 是 −1.45 ns),同样的 core 预算 |
第一部分:为什么要倒装,需要什么
#1为什么要倒装?
 1:45
在 YouTube 观看(英文) ↗在 Bilibili 观看(中文) ↗
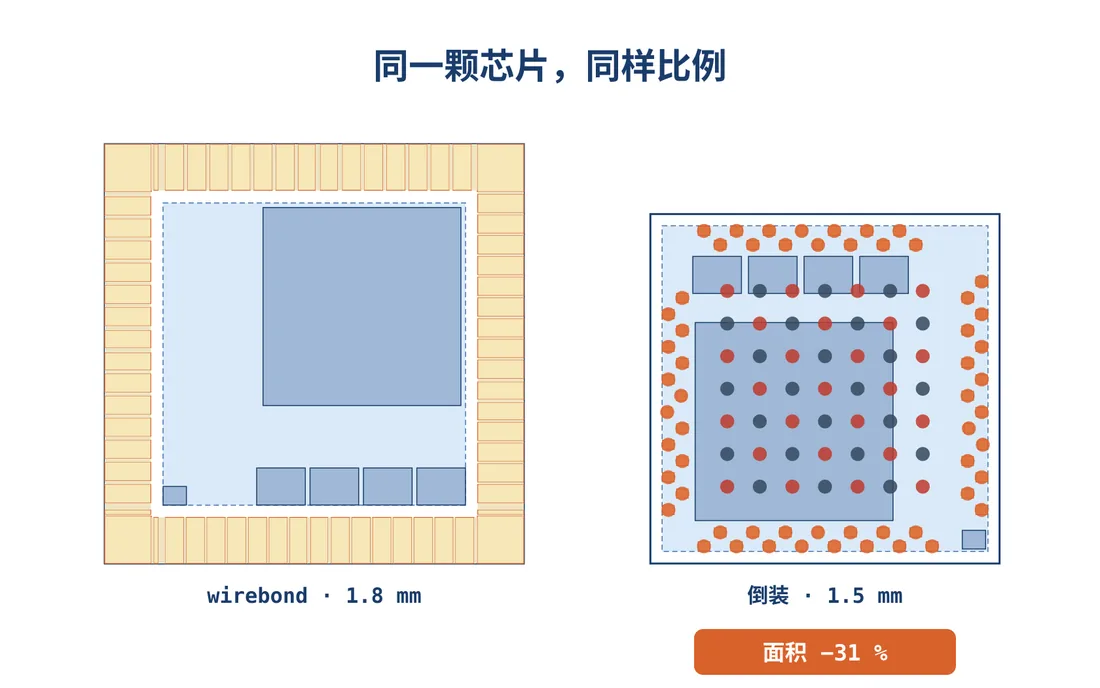
系列二的芯片是 1.8 mm 见方,58 个 pad 围着 1.3 mm 的 core。pad 环大约占了 die 的一半。决定尺寸的是 pad,不是逻辑:这颗芯片是 pad 受限的。而且 core 的所有电流,都从两个电源 pad 进来,再绕着环走。
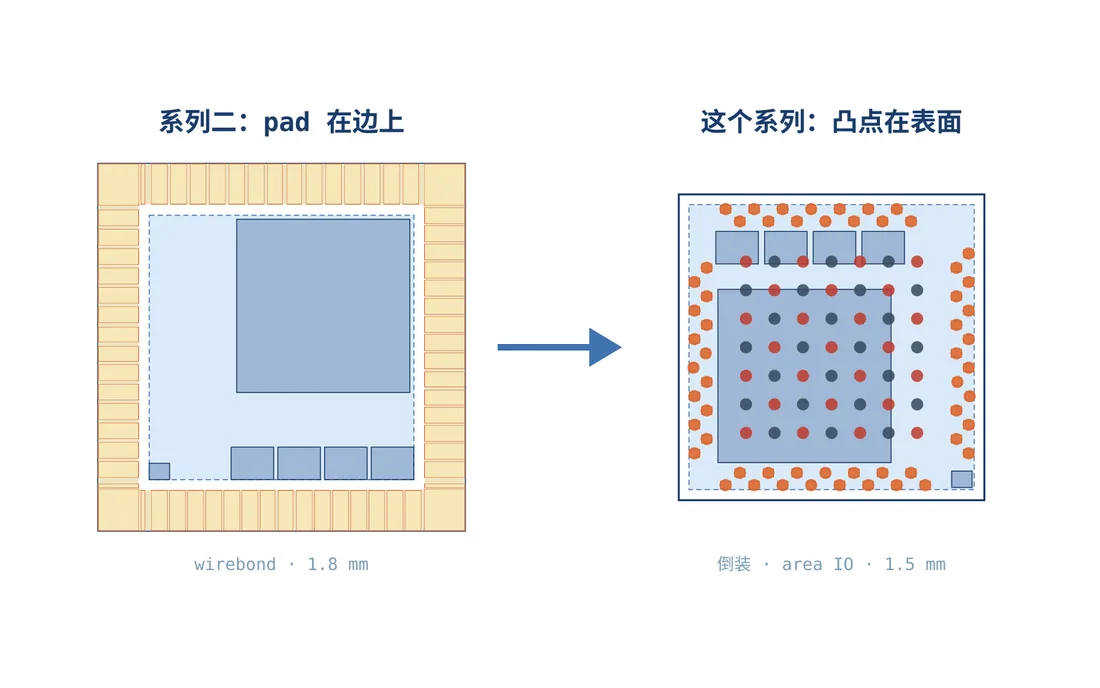
wirebond 芯片通过边缘上的线和封装沟通。倒装芯片则是把芯片翻过来、正面朝下放在焊料凸点上,由重布线层(RDL)把凸点连到电路。做法有两种:可以把凸点放在原来的 pad 环上,但这样环还在,面积也不变;或者把 IO 单元搬进芯片、放到凸点下面。这就是 area IO,也是我们要做的。
#2metal5 上面的一层
 1:12
在 YouTube 观看(英文) ↗在 Bilibili 观看(中文) ↗
凸点要放在哪里?metal5 走的是芯片的电源网络。metal4 属于硬核:系列二里我们让核心不用 metal5,好让芯片拥有最上层。所以凸点需要自己的一层,在 metal5 上面。
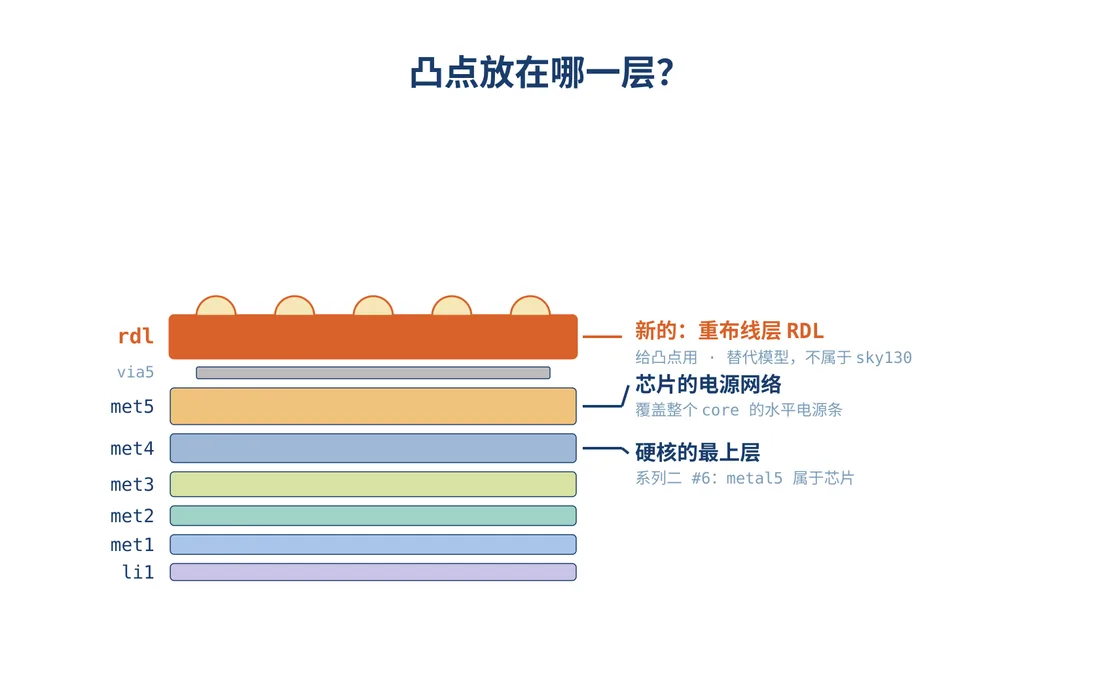
一个小脚本 gen_rdl_tech.py 把它加进 sky130 工艺 LEF 的一份副本:从 metal5 往上的 via5、一层 10 µm 厚、叫做 rdl 的金属,以及两者之间的 via 单元 M5RDL。原本的 sky130 文件不动。凸点是 rdl 上一个 60 µm 的八边形,只有一个 pin。新的层也需要在 RC 文件里给电阻值:IR 分析从这里读电阻,不是从 LEF,少了它就会失败。OpenROAD 读进来是 15 层。
#3area IO 单元
 1:03
在 YouTube 观看(英文) ↗在 Bilibili 观看(中文) ↗
系列二的 IO 单元是 80 × 198 µm,电源是它两侧边上细细的 pin。它只能和其他 IO 单元并排,排成环才能用。
所以我们给同一个单元做第二种物理视图。名字和信号 pin 都一样,所以网表和时序库都不用改。但它是一个可以放在任何地方的小 block:50 × 40 µm,凸点 pin 在 rdl 上,core 电源是 metal4 的 rail,芯片的电源网络可以像接任何 macro 一样接到它。
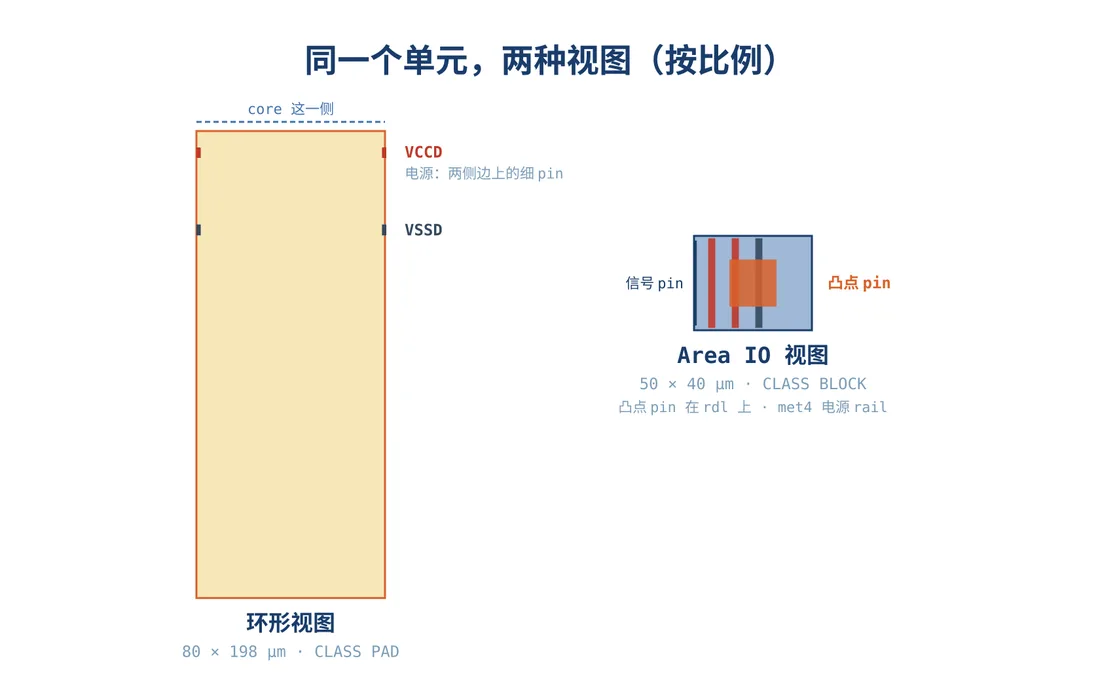
没有建模的部分:3.3 V 的 IO 电源,以及 pad 的模拟部分。真正的 area IO 库会有这些;我们的是替代模型。另外还生成一个凸点 pin 放在 metal2 短线上的版本,签核提取时会用到。
第二部分:倒装芯片的 floorplan
#4没有 pad 环的新版本
 1:04
在 YouTube 观看(英文) ↗在 Bilibili 观看(中文) ↗
倒装芯片是一个新的 build v02,和 wirebond 芯片并列,网表与约束都一样。设计变量改了:die 从 1.8 mm 改成 1.5 mm、替代工艺、凸点,以及用 area IO 单元取代环形单元。现在每个阶段都读这些变量,所以每个阶段都看得到新的层。
floorplan 多了两个 hook:macro 放置之前放 area IO,电源网络之后放凸点。pad 环的脚本拿掉了,core 电源环也不再找 pad。init 几秒钟就跑完,log 显示 15 层与新的 IO 视图。
#5凸点下面的 IO
 1:34
在 YouTube 观看(英文) ↗在 Bilibili 观看(中文) ↗
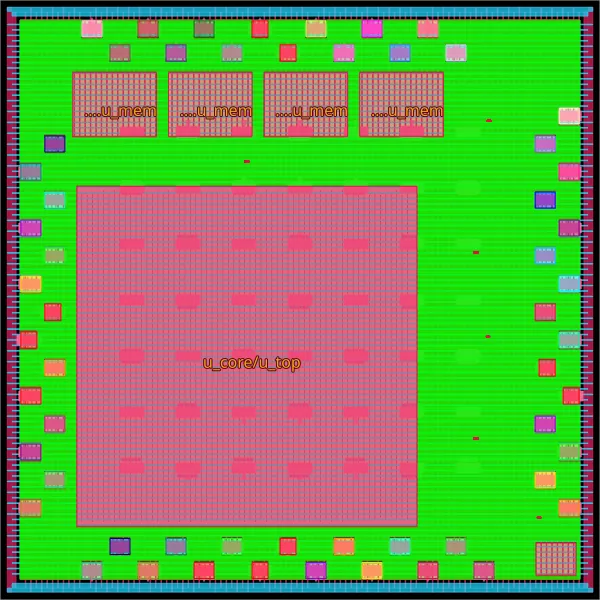
每个 IO 单元都搬进芯片,靠近边缘,顺序和原来的环一样,每边两排、错开排列,这样凸点才放得下。然后在每个 IO 单元的凸点 pin 正上方放一个凸点。它们重叠,所以就连上了:信号不需要绕线。同一排的凸点相距 140 µm,两排之间至少 92 µm。
floorplan 大约跑两分钟。log 里放好了 58 个 IO 单元、58 个 IO 凸点,macro 放置工具把 58 个 IO 单元都当成固定的 macro,绕开它们。芯片有 64 个 macro,其中 58 个是 IO 单元,die 宽 1,500 µm。
第三部分:电源与 IR 压降
#6电源凸点与 IR 压降
 2:06
在 YouTube 观看(英文) ↗在 Bilibili 观看(中文) ↗
电源凸点在 core 上方排成 7 × 7 的阵列,电源和地交替。每个凸点下面有一组 via 阵列,往下连到它自己那个 net 的 metal5 电源条:25 个电源凸点、24 个地凸点,大约 450 个 via。
现在电源和地都是真正的芯片端口,所以电源网络检查对两者都能做,而且两个都完全连通。wirebond 芯片连这样的检查都做不了,因为它没有电源端口。
placement 时,从 25 个电源凸点分析的 IR 压降,平均大约半毫伏(0.475 mV),最差 3.13 mV。那 wirebond 芯片呢?它的 log 写着 64 µV。上面那一行说明了原因:没有电源端口,所以工具自己编了一组凸点。这个数字从来就不是真的。
所以我们告诉工具,wirebond 芯片的电真正从哪里进来:两个 core 电源 pad。每个 pad 一行:core 环上的一个位置、一个大小,以及电压。同样的两个位置,建模两次:
| wirebond 的电源入口 | 平均 | 最差 |
|---|---|---|
| 每个电源 pad 一个 10 µm 的点 | 4.19 mV | 9.29 mV |
| 整个 75 µm 的 pad 边 | 0.45 mV | 2.18 mV |
| 倒装芯片,25 个电源凸点 | 0.475 mV | 3.13 mV |
用 10 µm 的点,倒装芯片看起来好了九倍;用整个 pad 的边,优势就不见了。
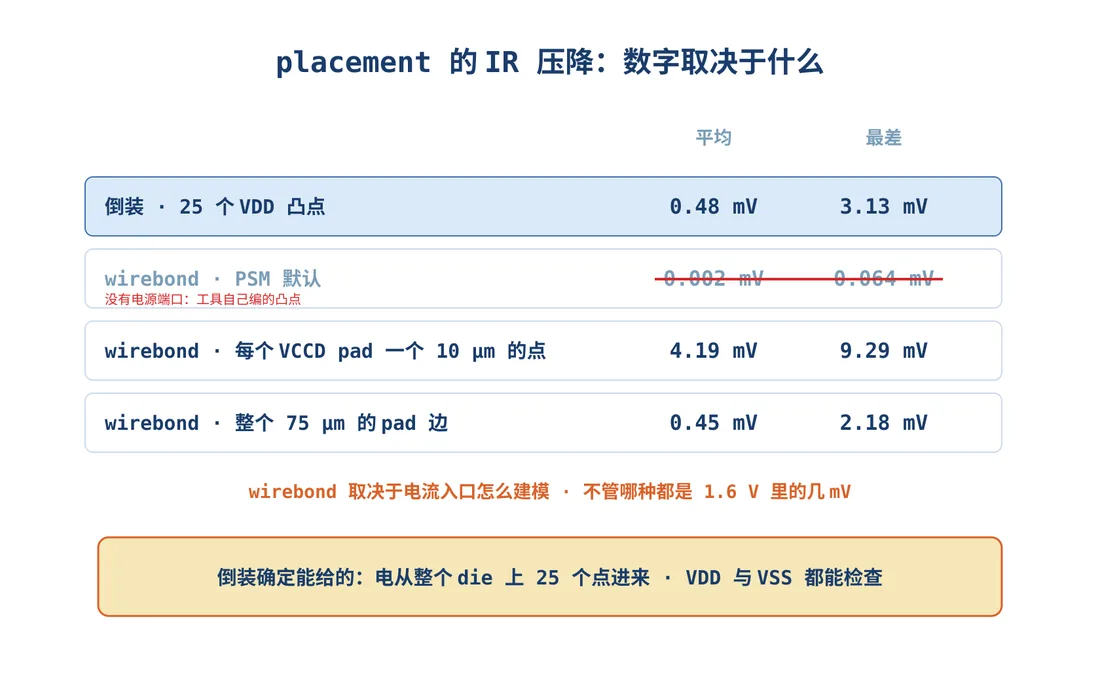
所以 wirebond 的数字,主要反映的是你怎么建模电流的入口。真正的路径,经过 pad、环和 bond wire,两个模型里都没有。以这颗芯片的功耗,不管哪种都是 1.6 V 里的几毫伏。倒装芯片确定能给的是:电从整个 die 上的 25 个点进来,功耗变大时依然有效;而且电源和地都能检查。
第四部分:布局、绕线与签核
#7布局、CTS 与绕线
 1:19
在 YouTube 观看(英文) ↗在 Bilibili 观看(中文) ↗
时钟树和第一次 hold 修复跟系列二一样,每个阶段不到一分钟。练习时这样还不够:绕线以后,真实的线让调试模块的 hold 少了大约三分之一纳秒(39 个端点 −0.330 ns)。
所以 route 阶段加了一个 hook。全局绕线一完成,就用绕好的线估计时序、修 hold,然后才做详细绕线。只修 hold:练习时在这个时候修 setup,会去追输出 pad 上一个错误的估计,还把详细绕线搞坏了。
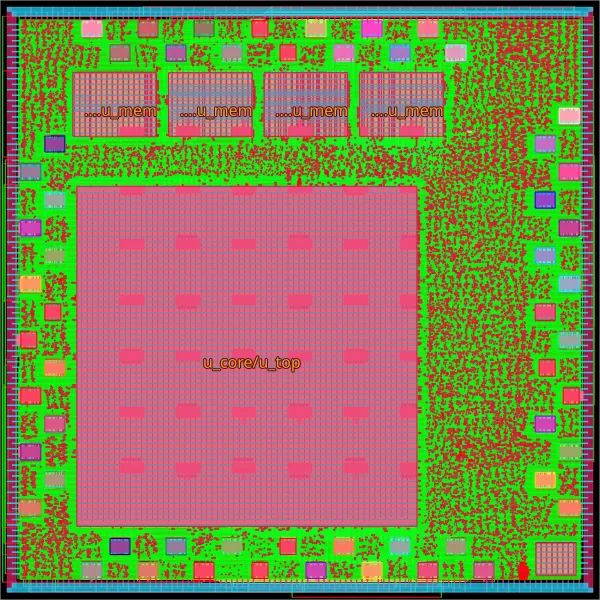
route 大约跑十三分钟。log 里有 97 个 hold 端点、31 个 buffer,最差 hold 从 −0.539 ns 变成 +0.101 ns。postroute 大约半小时,finish 三分钟,最后剩 8 个 DRC 违规:这是示范,不是流片。finish 时红色的输出 pad 数字,和 wirebond 芯片在这个阶段一模一样;签核会好好检查这些路径。
#8签核与结论
 2:16
在 YouTube 观看(英文) ↗在 Bilibili 观看(中文) ↗
签核从寄生参数提取开始,而 OpenRCX 在我们的替代层上崩溃了。更糟的是,这个阶段还显示零个错误;这已经记进 G2 的 bug 列表。在这个设计里,信号从来不经过 RDL 层,所以我们只提取 die 本身:在内存里拿掉凸点和 RDL 图形,用原本的 sky130 文件提取。凸点属于封装模型。这样提取四个 corner 不到一分钟。
OpenSTA 用和 wirebond 芯片同一个脚本,一个慢 corner、一个快 corner,各大约 15 秒。hold 满足。setup 在 226 个端点上差 1.61 ns,进到调试模块的存储器:和系列二一样,是 core 边界的路径。
同一个 IO 路径脚本在两颗芯片上,印出每个端口的 slack,以及路径在 core 里面的那一段。输入在倒装芯片上好了大约 2 ns。输出差了 2 到 2.5 ns,而且全部在 core 里面、pad 单元之前:是时钟和逻辑,不是 pad。原因我们还没有分离出来。每条 IO 路径都还有超过 10 ns 的 slack。
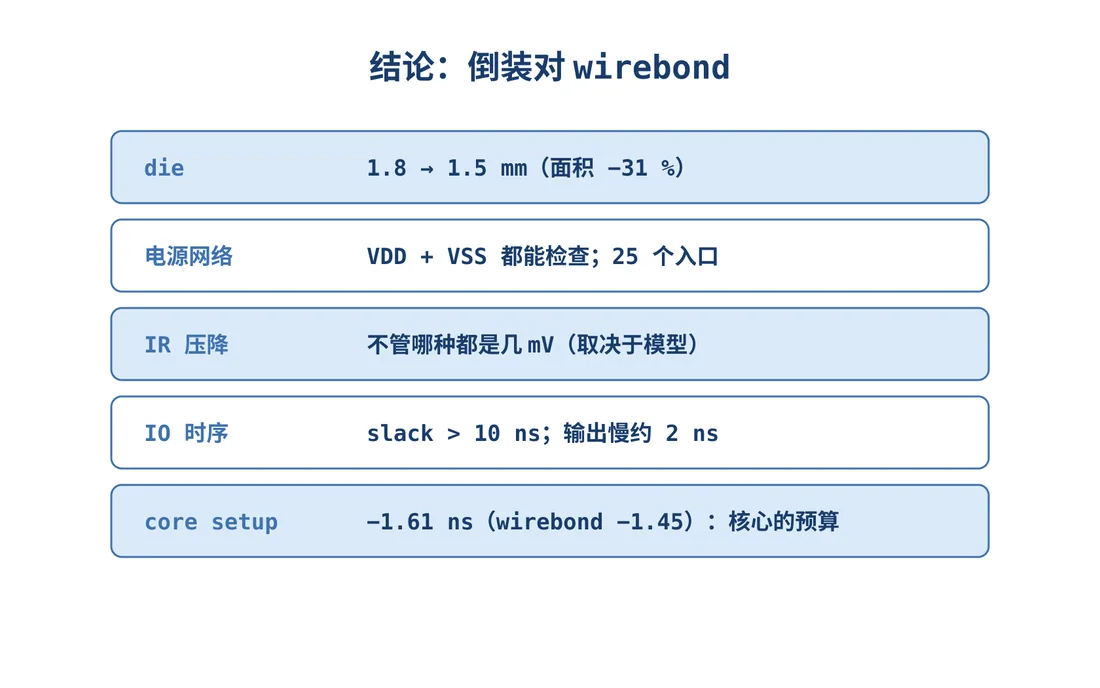
结论,以及还剩下什么
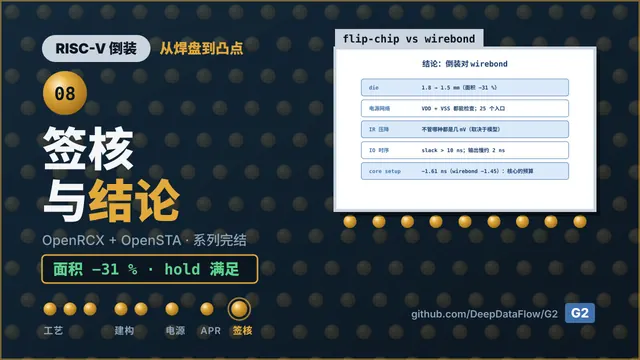
- 面积:少了 31 %,每边从 1.8 mm 变成 1.5 mm。
- 电源网络:电源和地都能检查,电从整个 die 上的 25 个点进来。
- IR 压降:在这个功耗下,不管哪种都是几毫伏,而且 wirebond 的数字取决于你怎么建模。
- IO 时序:每条 IO 路径都还有超过 10 ns 的 slack;输出慢了大约 2 ns,在 core 里面。
- core 时序:和之前一样的预算。
这个系列没有做的:视图是替代模型,没有 DRC、LVS 或 GDS;3.3 V 的 IO 电源没有建模;凸点与 RDL 的寄生参数没有提取;core 的 setup 遗留问题还在;还剩 8 个 DRC 违规。
观看与动手
- 视频:Bilibili 合集(中文)与 YouTube 播放列表(英文)。
- 这个系列出发的 wirebond 芯片:RISC-V SoC 实战:从模块到芯片。
- 项目:G2_demo_sky130。G2 本身有免费的社区版。
- 关于 G2 或自己跑流程的问题:support@deepdataflow.com。授权与合作:sales@deepdataflow.com。